Google Genie 4发布:实时交互世界模型来了

Google发布Genie 4世界模型,主打实时可操控与原生音频,先研究预览后API化。
Google 发布 Genie 4,定位为迄今最逼真、最具交互性的世界模型,核心卖点从画质转向可玩性与实时性。其能力包括实时操控动态环境中的事件走向、镜头与角色动作,原生生成与环境匹配的背景音并支持角色实时对话,照片级场景与真实物理模拟,以及借助 Gemini 推理能力生成连贯的多步骤事件链。这标志着世界模型正从视频生成器演化为可运行的模拟环境。发布节奏上,Genie 4 先向受信任测试者开放研究预览,后续登陆 Project Genie 订阅服务,并通过 Gemini API 与 AI Studio 向早期合作伙伴开放,显示其兼具研究项目与商业平台的双重定位。文章认为竞争焦点已转向交互与实时,但研究预览阶段的能力边界与稳定性仍待验证。
Google 正式发布了 Genie 4,定位为「迄今最逼真、最具交互性的世界模型」。与以往偏向静态生成的模型不同,Genie 4 的核心卖点是把「可玩性」和「实时性」放到首位:用户可以在动态环境中实时转向、塑造事件、调整机位并触发动作,而不只是观看一段生成好的视频。
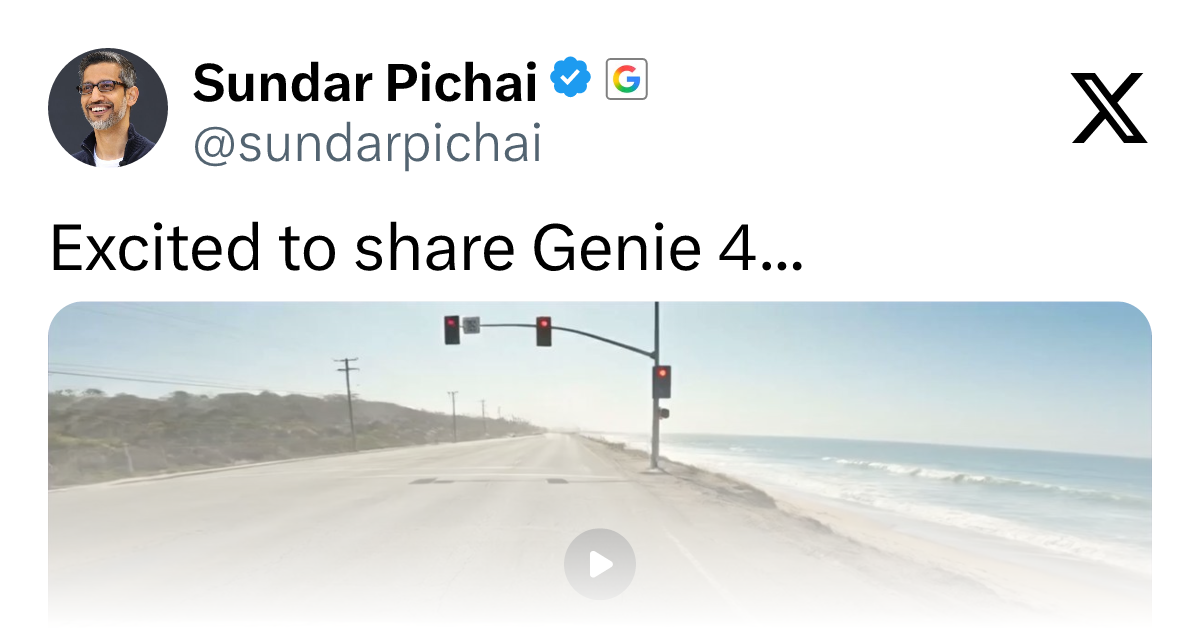
从「生成画面」到「操控世界」
官方对 Genie 4 的描述围绕四组能力展开。第一是实时操控动态环境——改变事件走向、镜头角度和角色动作,这意味着生成内容具备可交互的连续性,而非一次性输出。第二是原生音频生成,既包括与环境匹配的真实背景音,也包括能实时对话的角色。第三是照片级场景与真实物理模拟。第四是通过 Gemini 的推理能力,生成更连贯的多步骤事件链。
这四点组合起来,指向的其实是同一个方向:世界模型正在从「视频生成器」演化为「可运行的模拟环境」。镜头角度和动作可以被实时改写,说明模型内部维护着某种一致的空间与因果状态,而不是逐帧拼接画面。
世界模型(World Model)是一类学习环境动态规律、能在内部表征空间中对未来状态进行预测与推演的模型。与只学习像素分布的视频生成模型不同,世界模型强调维护环境的状态一致性(物体不会凭空消失、光照与几何保持连贯)和动作—结果的因果映射,从而支持“给定动作预测下一状态”。Genie 系列正是沿这一思路演进的:早期版本多聚焦于从单张图像生成可探索的二维环境,而后续版本逐步引入更强的时空一致性与交互响应。世界模型的典型应用包括机器人策略的仿真训练、自动驾驶的闭环测试、游戏与交互内容的快速原型,以及作为具身智能体的“想象环境”。其核心难点在于长程一致性、物理合理性以及推理时延——三者共同决定了模型能否被真正“操控”,而不只是被“观看”。
音频与对话为什么关键
在 Genie 4 的能力清单里,原生音频是容易被低估的一项。背景音与环境匹配,意味着声音不是后期贴上去的,而是随场景状态同步生成;角色能实时对话,则把「世界模型」和「对话模型」的边界进一步模糊。
结合 Gemini 的推理能力来看,多步骤事件的连贯性依赖的不只是视觉一致性,还包括对「接下来会发生什么」的推断。官方特别强调 reasoning from Gemini,这暗示 Genie 4 在事件编排层面借力了 Gemini 的推理链路,而非纯靠扩散模型逐帧外推。
原生音频生成指的是模型在生成视觉内容的同时,直接输出与画面状态同步的音频信号,而非先用文本描述再由独立的音频模型事后配音。这种联合生成要求模型在统一的时序中对视觉事件与声学事件建模,例如脚步落地与脚步声的对应、环境光照变化与氛围音的匹配。技术上通常需要把音频编码为离散 token 或连续潜变量,与视频 token 在同一序列中自回归或扩散生成,从而保证音画对齐。相比之下,传统流程是“先出视频、再配声音”,容易出现口型不同步、音画事件错位的问题。原生音频的意义不仅在于省去后期环节,更在于让声音成为世界状态的一部分——声音能反映场景中的物理事件,进而为交互提供额外的反馈通道,这也是可玩性体验的重要组成。
发布节奏:研究预览先行
Genie 4 目前以研究预览形式向受信任的测试者开放。后续计划面向 Google AI Ultra 订阅用户在 Project Genie 中提供,同时通过 Gemini API 和 AI Studio 向早期接入合作伙伴开放。
这个节奏值得注意:先小范围测试、再订阅制产品、最后 API 化,说明 Google 把 Genie 4 既当作研究项目,也当作可商业化的平台能力。对开发者而言,Gemini API 和 AI Studio 的接入路径意味着世界模型可能像调用普通模型一样被集成进应用,而不是停留在演示视频里。
Gemini API 与 AI Studio 是 Google 面向开发者的模型接入渠道:AI Studio 提供基于网页的提示调试、参数对比与原型验证环境,适合快速试验;Gemini API 则提供程序化调用接口,支持将模型能力集成进生产应用,并按用量计费。两者的分工类似“沙盒”与“生产线”。若世界模型通过这一路径开放,开发者就可像调用语言或多模态模型一样,把可交互环境的生成能力嵌入游戏、教育、仿真等应用,而不必自建推理基础设施。需要留意的是,此类高实时性模型对推理算力与时延要求远高于文本模型,API 的吞吐上限、并发限制与定价策略会直接影响其可用场景与经济性。
世界模型竞赛的新变量
Genie 4 的发布把竞争焦点从「画质」推向「交互与实时」。真实物理模拟加上实时操控,直接关联到机器人仿真、游戏原型、交互式内容创作等场景;原生音频和实时对话则让它更接近一个可以「走进去」的环境。
不过,研究预览阶段通常意味着能力边界和稳定性仍有待验证,官方也未披露具体性能指标。Genie 4 能否在开放后保持实时操控的流畅度与物理一致性,将是判断其实际价值的关键。
相关推荐
Ollama本地部署指南:零基础跑通开源大模型
Ollama本地部署教程:介绍Ollama是什么、为什么选择它,以及如何下载安装、运行开源大模型,并利用API进行个性化开发,适合零基础用户。
n8n:GitHub 187K星的开源自动化神器,把重复工作变工作流
n8n 是一款 GitHub 187K 星的开源可视化工作流自动化引擎,支持 400+ 节点、Webhook/定时/轮询触发,可自托管保障数据安全,还能接入 AI Agent 打造 AI 工作流。本文介绍其核心概念、典型场景与避坑指南。
n8n自托管实战:Docker+PostgreSQL+Caddy部署指南
手把手教你用 Docker Compose 部署 n8n 自托管实例,搭配 PostgreSQL 和 Caddy 自动 HTTPS,含环境变量避坑、网站巡检飞书告警流程、备份升级回滚要点。