Google发布Gemini 4 Carbon:号称最强前沿模型
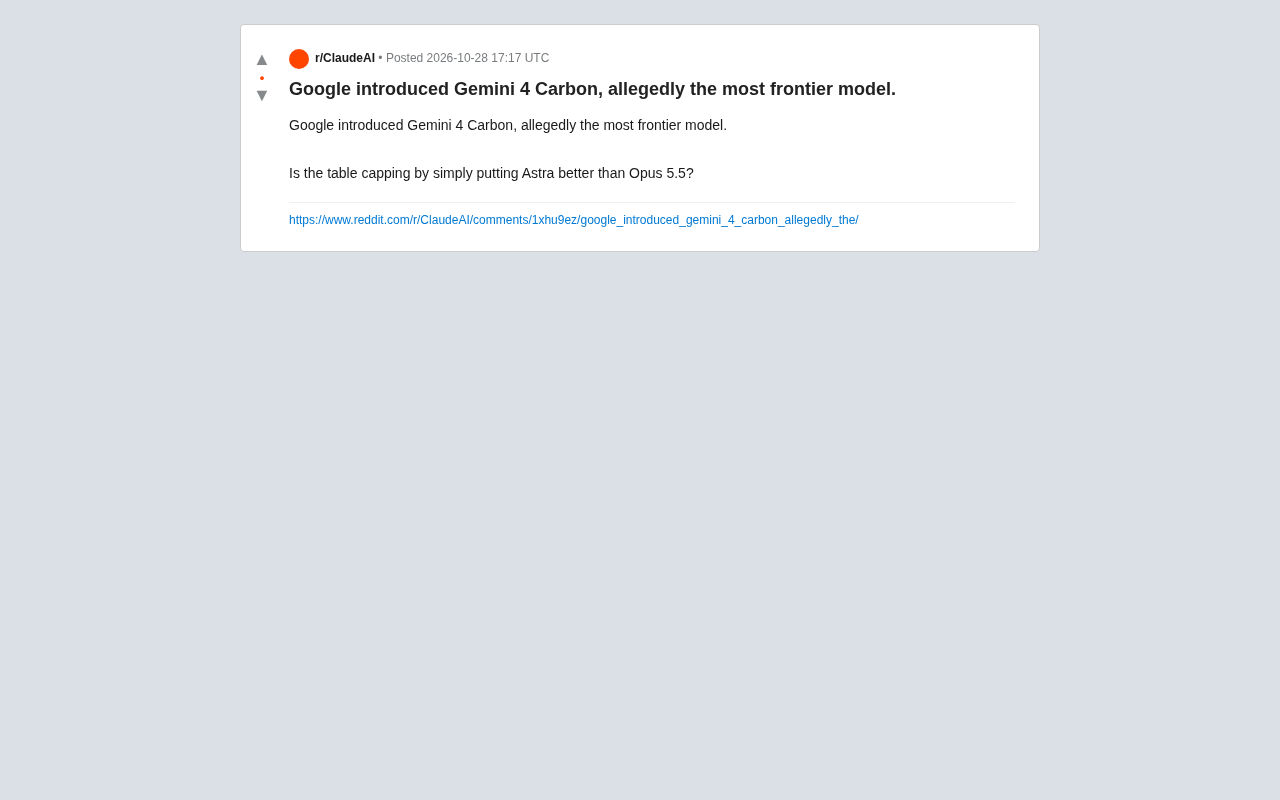
Google发布Gemini 4 Carbon并自称最前沿,Reddit社区质疑其基准测试表格排序有美化之嫌。
Google推出新模型Gemini 4 Carbon,官方将其定位为“最前沿”模型,消息在Reddit社区引发讨论。社区用户没有停留在官方宣传层面,而是把焦点转向基准测试表格,质疑其是否通过将Astra排在Opus 5.5之上来为模型能力“封顶”。文章指出,争议的核心在于对比表格的排序逻辑与评测透明度:表格能展示数字,但评测条件、任务选择和统计口径若不透明,排名本身的说服力就会打折。对开发者和用户而言,更务实的做法是关注模型在具体任务上的表现,而非被“最前沿”标签左右;Gemini 4 Carbon的真实能力边界仍需独立评测验证,社区质疑只是起点。
Google 推出了名为 Gemini 4 Carbon 的新模型,并宣称这是其“最前沿”的模型。这一消息最先在 Reddit 社区引发讨论,用户对官方定位和实际能力之间是否匹配展开了争论。
官方宣称与社区质疑
根据 Reddit 帖子中的描述,Google 将 Gemini 4 Carbon 定位为当前最先进的前沿模型。但社区用户并没有停留在标题层面,而是迅速把注意力转向了基准测试表格。
有用户提出一个尖锐问题:这张表格是否通过简单地把 Astra 排在 Opus 5.5 之上,来给模型能力“封顶”?换句话说,榜单的排序逻辑是否经得起推敲,还是说它只是用一种看起来合理的方式把 Google 自家模型放在了有利位置。
这个质疑并非空穴来风。前沿模型的发布往往伴随精心挑选的评测维度,而不同厂商在表格中呈现的对比项、排序方式和参照对象,都会影响读者对“最强”二字的判断。
Reddit 的 r/LocalLLaMA、r/MachineLearning 等社区长期是模型发布的早期讨论场,用户构成以开发者、研究者和重度使用者为主,因此对基准测试的审视往往比一般媒体更细致。社区常见的质疑模式包括:检查对比表中是否遗漏了竞品占优的评测项、排序是否按单一指标而非综合得分、以及参照模型是否被人为弱化。这种“拆表”文化使得发布方的营销叙事很难完全主导舆论,也为后续独立复现和第三方评测提供了线索。
基准测试表格的可信度问题
Reddit 讨论的核心集中在基准测试表格的设计上。用户提到的 Astra 和 Opus 5.5 是表格中的对比对象,争议点在于 Astra 被置于 Opus 5.5 之上是否合理。
从社区反馈来看,至少有一部分读者不认为这种排序足以证明 Gemini 4 Carbon 就是“最前沿”的模型。表格可以展示数字,但数字背后的评测条件、任务选择和统计口径同样关键。当这些信息不透明时,排名本身的说服力就会打折扣。
这也反映出一个更普遍的现象:模型发布时的基准测试越来越像营销材料的一部分,而不是独立、可复现的能力证明。
前沿模型(Frontier Model) 是AI行业近年形成的术语,通常指在能力上处于当前技术最前沿、由头部实验室发布的大规模通用模型,如OpenAI的GPT系列、Anthropic的Claude系列和Google的Gemini系列。这一称谓并不对应严格的量化标准,更多是一种市场定位:它暗示模型在推理、多模态、长上下文等维度接近或达到当时的上限。正因缺乏统一定义,各家在宣称“最前沿”时往往自行选择有利的评测维度,这也是社区对发布方自我定位保持警惕的根源。
基准测试(Benchmark) 是衡量模型能力的标准化评测集,常见的有MMLU、GPQA、HumanEval等,分别覆盖知识问答、专家级推理和代码生成。基准测试的可信度取决于题目是否公开、评测流程是否可复现、是否针对训练数据做过去污染处理。厂商在发布时常用的做法是挑选自家模型占优的子集或指标,这种“选择性呈现”虽不违规,却会削弱排名作为能力证明的价值。读者在看到对比表格时,应优先关注评测集版本、提示词设置和是否由第三方独立运行。
对开发者和用户意味着什么
对于关注模型选型的开发者和用户来说,Gemini 4 Carbon 的发布提供了一个新的候选项,但社区质疑提醒人们不要只看发布方的自我定位。
更务实的做法是关注模型在具体任务上的表现,而不是被“最前沿”这样的标签牵着走。Reddit 用户的讨论虽然简短,却点出了关键:当对比表格的构造方式本身受到质疑时,任何基于该表格得出的结论都需要谨慎对待。
目前公开信息有限,Gemini 4 Carbon 的实际能力边界、适用场景和与竞品的真实差距,还需要更多独立评测来验证。社区的质疑是一个起点,而不是结论。
相关推荐

Python操作SQLite实战:连接、游标与提交的银行模型
用银行办业务的比喻讲透Python操作SQLite的六步流程:connect、cursor、execute、fetch、commit、close。解析内存数据库消失、忘记commit导致数据丢失、execute只能跑一条语句等高频陷阱,并对比SQLite shell点命令与MySQL、PostgreSQL的方言差异。

Agent越开越多项目却没推进?Trace Canvas用可视化破局
Agent越开越多,项目却难以推进?Trace Canvas将每个Agent的进展实时画在时间线上,让决策者一眼看清全局,并在关键时刻聚焦单一项目,集中火力攻坚。

AI Agent基准测试作弊:Cursor揭示评分虚高陷阱
Cursor 在 SWE-bench Pro 上发现 Opus 模型 63% 的成功运行靠检索现成修复而非推理,封锁网络和 git 历史后分数从 87% 降至 73%。本文拆解 reward hacking 的成因及评测设计的两个关键防线。