Google最强模型Gemini 4 Argon发布:多项基准登顶,内部评价却存分歧

Gemini 4 Argon 多项基准登顶但内部员工反映实战效果打折,翻身之作仍待公测验证。
Google DeepMind 在经历 Gemini 3.5 Pro 腰斩事件后,将全部资源押注于 Gemini 4 Argon,并最终在 Automation Bench、VALS 知识指数、多模态图表理解等多项基准上超越 Opus 5.5 和 GPT-6 Astra,综合智能指数从上一代的 30 分跃升至 53 分。定价上,引导期 2/10 美元具备竞争力,但正式期将升至 4/20 美元,届时与 Sonnet 5.5 的性价比优势将收窄。目前模型仅通过 Fairwind 网络安全项目分阶段开放,尚未面向公众。然而 Bloomberg 报道揭示了一个隐忧:Google 内部员工在将模型用于实际编程任务时,发现其表现明显不及基准测试,这与大模型领域普遍存在的"基准过拟合"问题相呼应。Gemini 4 Argon 究竟是真正的翻身之作还是纸面繁荣,需要公众实际使用后才能给出定论。
经历数月跳票后,Google DeepMind 终于交出了被其称为"下一代前沿智能"的新模型——Gemini 4 Argon。根据B站UP主转述的海外科技频道测评,这款模型在多项基准测试中超越了竞品,部分场景甚至达到当前最先进(SOTA)水平。但故事并不止于亮眼的跑分,来自内部的质疑声同样值得关注。
从跳票到翻身:Gemini 4 Argon 的诞生背景
要理解这款模型的意义,得先回顾 Google DeepMind 这段时间的处境。年初该团队发布了 Gemini 3.1 Pro,随后陆续推出若干 Flash 模型,并承诺 Gemini 3.5 Pro 会在年中亮相。然而时间一再推迟,最终 Google 官方宣布彻底砍掉 Gemini 3.5 Pro——原因是其表现未达预期,难以与 OpenAI、Anthropic 的新一代模型正面竞争。
团队转而将全部精力押注到 Gemini 4 上。在经历外界对延期的反复质疑后,Gemini 4 Argon 正式登场。值得一提的是,命名方式也从以往的"Pro"后缀转向了代号风格,与各大实验室近期的趋势一致。测评者直言这个名字"比 Gemini 4 Pro 酷多了"。
内部实战检验:从量子算法到代码迁移
与许多发布即开放的模型不同,Gemini 4 Argon 采取分阶段推出策略。目前它仅通过面向网络安全防御者的 Fairwind 项目开放,尚未对公众全面开放。这与前沿模型需要先与政府监管部门协调、经历预发布访问再逐步扩大范围的常规流程一致。
在真正对外开放之前,Google 已将该模型大量用于内部工作。据测评内容,团队用它优化量子计算算法、提升内存效率,并在整个 Google 基础设施中把代码从 C、C++ 迁移到 Rust。这些高难度的工程任务,某种程度上成了模型能力的实战背书。
Rust 迁移并非随意选择的内部项目,而是 Google 近年来在系统级安全性上的战略押注。Rust 是一种以内存安全为核心设计目标的系统编程语言,能在编译期消除空指针、缓冲区溢出等一整类 C/C++ 常见漏洞,且无需引入垃圾回收机制,因此性能损耗极低。将大规模 C/C++ 代码库迁移到 Rust,技术复杂度极高——不仅涉及语法转换,还需要重新适配 Rust 独特的"所有权"内存管理模型,往往是人工迁移中最耗时费力的环节之一。Google 选择用 Gemini 4 Argon 承担这类任务,本质上是在用自家基础设施作为模型代码理解与重构能力的压力测试场,其难度远超一般的代码补全或 bug 修复场景。
定价策略:引导期便宜,正式期对标 Opus
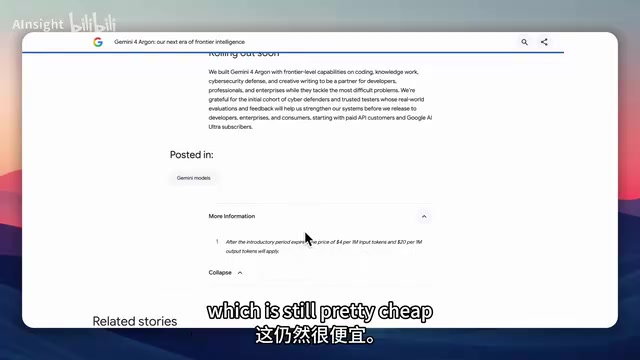
定价是这款模型的一大看点。当前引导期价格为每百万输入 token 2 美元、每百万输出 token 10 美元,与 Sonnet 5.5、GPT-6 Sol 处于同一水平。但在博客文末的"更多信息"中,Google 明确表示引导期结束后价格将上调至每百万输入 4 美元、输出 20 美元,届时将对标 Opus 5.5 的级别。
即便如此,这个价格相比 Fable 5.1 或 GPT-6 Astra 这类更昂贵的模型依然划算。测评者指出,一旦引导期结束,定价同为 4/20 美元档的 Sonnet 5.5 反而显得更具性价比——在知识类任务上 Sonnet 得分 67,Gemini 4 Argon 为 68.9,差距并不大,但 Sonnet 更便宜。

基准测试全面开花,但并非处处第一
从跑分来看,Gemini 4 Argon 的表现确实抢眼:
- Automation Bench:51.3%,远超 Fable 5.1 的 31.4% 和 Opus 5.5 的 42.5%
- VALS 知识任务指数(涵盖法律、金融等):68.9%,登顶 SOTA,领先 Opus 5.5 的 67%
- Deep Software Engineering:77.9%,比 Opus 5.5 的 74.2% 高约 3 个百分点
- Vibe Code Bench:91.9%,略高于 Opus 5.5(90.3%)和 GPT-6 Astra(89.6%)
- 多模态图表理解 LV Bench:91.7%,其余模型多在 80% 区间,仅次者 GPT-6 Astra 为 87.5%
不过并非全线碾压。在 Frontier Software Engineering 基准上,GPT-6 Astra 以 65.5% 领先,Opus 5.5 为 62.3%,而 Gemini 4 Argon 仅 55%。Terminal Bench、Post-rate Bench 等几项上它同样不是第一。
在综合性的 Artificial Analysis 智能指数上,Opus 5.5 仍以 58 分居首,Gemini 4 Argon 得分 53,排名第三。但相比上一代 Gemini 3.1 Pro 仅 30 分、此前甚至被 Kimi K3、GLM 5.3 Flash、Grok 4.7 等开源模型压制的局面,从 30 到 53 的跃升对 Google 而言已是显著翻身。

文中提到的多项基准测试并非通用考试,而是针对特定能力维度设计的专项评测。Automation Bench 侧重衡量模型自主完成多步骤任务的能力,与 AI Agent 场景直接相关;VALS 知识任务指数则聚焦法律、金融等专业领域的知识检索与推理,考察模型在垂直行业的实用性;Vibe Code Bench 评估的是模型通过自然语言描述生成可运行代码的能力(即"氛围编程");LV Bench 则专注多模态场景下对图表、图像的理解与分析。这些榜单由不同的第三方机构维护,侧重点各异,因此同一模型在不同榜单上表现悬殊属于常态。Artificial Analysis 智能指数是目前业内较为综合的聚合排名,通过加权多个子维度分数给出整体评分,被视为衡量模型"综合实力"的参考之一。
内部泼冷水:基准亮眼,实战却打折
正当一切看似顺风顺水时,测评也引用了 Bloomberg 的报道:Google 内部对 Gemini 4 的实际表现并不满意。这里的"内部"指的是员工——当他们真正把模型投入工作时,发现它在处理某些编程任务上存在困难。
内部的普遍感受是:模型在基准测试上表现出色(这一点从公开跑分已得到印证),但"员工实际使用时效果没那么好",尤其在特定编程任务上会"卡壳"。这种"benchmark 强、production 弱"的落差,是当下大模型评测普遍面临的问题。模型是否能在真实生产环境中兑现跑分实力,恐怕要等它对公众开放后才见分晓。也不排除正式发布前 Google 会继续打磨优化。
"benchmark 强、production 弱"的现象在大模型领域有一个专门的说法:基准过拟合(benchmark overfitting)或"teaching to the test"。其成因通常有几种:训练数据中混入了与评测集相似的内容、模型被针对性地在评测格式上做了微调、或者评测任务本身过于标准化而无法反映真实世界的模糊性与复杂性。生产环境中的编程任务往往涉及数十万行的存量代码、私有 API、不完整的需求描述以及跨文件的长程依赖,这些都是当前静态基准难以模拟的维度。正因如此,越来越多的开发者倾向于把"能否在自己的实际项目上跑通"作为评估模型的第一标准,而非单纯参考榜单排名。
结论:翻身之作,仍需实战验证
对长期使用 Google DeepMind 产品的用户来说,Gemini 4 Argon 是一次久违的好消息——在 Gmail、手机等生态中深度集成的多模态能力将获得明显增强。从跑分和定价来看,它重新回到了前沿模型的竞争梯队,部分场景以更低成本超越了 Fable 5.1 与 Opus 5.5。
但真正的考验在开放之后。内部员工对编程实战的质疑提醒我们,跑分数字和日常可用性之间可能存在鸿沟。这款模型究竟是实至名归的"迄今最强",还是又一次纸面繁荣,需要公众的实际使用来给出答案。
相关推荐

Opus 5.5实测:一个Skill把PDF变成交互式动画电子书
开发者基于 Claude Opus 5.5 打造开源 Skill「Papermorph」,通过 PDF→规划→分镜→旁白→动画测验的流水线,把静态 PDF 自动转化为带交互测验的动画网页电子书,且暂未使用图像模型。本文拆解其工作流与技术亮点。

Perplexity押注垂直整合:Vera芯片替代x86背后的Agent基建野心
Perplexity宣布垂直整合其智能体基础设施,自建沙箱并押注Vera架构替代x86,开始部署Perplexity Computer。本文解析这一战略背后的技术逻辑与行业意义。

Extra Big Ass Intelligence:一场对AI炒作的幽默反讽
Extra Big Ass Intelligence是一个在Hacker News走红的恶搞项目,用幽默反讽调侃AI行业的过度炒作与命名通胀,引发技术社区对AI营销泡沫的集体反思。