GPT 5.1 vs Claude Sonnet 4.5实测对比:推理、写作、编程谁更强

GPT 5.1擅长计算推理和指令执行,Claude Sonnet 4.5更擅长创意写作和情感沟通。
基于多维度实测对比,GPT 5.1 Thinking凭借自适应推理能力,在数学推理、逻辑分析、指令遵循和前端编程方面表现更优,推理过程结构清晰;Claude Sonnet 4.5则在创意写作、情感沟通方面展现出更强的文学质感和共情能力。两者定位互补,用户应根据具体场景灵活选择。
概述:GPT 5.1正式登场
OpenAI最新发布的GPT 5.1已向付费用户开放,包含5.1 Instant和5.1 Thinking两个模型。5.1 Instant默认更温暖、更智能,首次具备自适应推理能力;5.1 Thinking则可以动态调整思考时间——简单问题快速响应,复杂问题深度思考。
所谓自适应推理(Adaptive Reasoning),是指模型能够根据问题复杂度动态分配计算资源。这一设计借鉴了诺贝尔奖得主Daniel Kahneman提出的"快思考-慢思考"双系统理论:面对简单直觉性问题时快速给出答案,遇到需要深度分析的问题时则投入更多推理步骤。这一能力的技术基础源自OpenAI在o1系列模型中探索的"思维链"(Chain-of-Thought)推理和"测试时计算缩放"(test-time compute scaling)研究——即通过在推理阶段而非训练阶段增加计算量来提升模型表现。
本文基于B站UP主Kate的详细实测,从故事创作、数学推理、心理咨询、指令遵循、编程能力等多个维度,对GPT 5.1 Thinking和Claude Sonnet 4.5进行全面对比。
故事创作:Claude更有文学质感
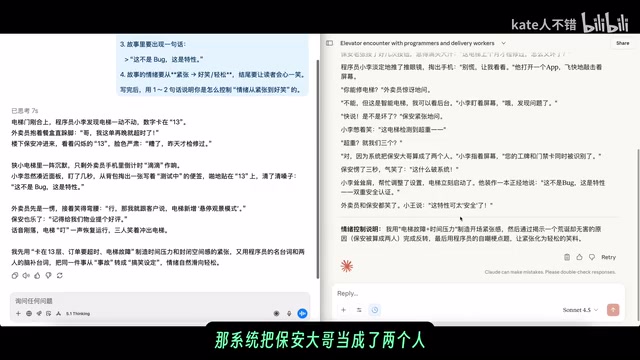
测试要求模型生成一个300字的短故事,情绪需从紧张过渡到好笑。
GPT 5.1 Thinking的故事围绕程序员小李在电梯里贴"测试中"面签展开,结构简洁但略显单薄。而Claude Sonnet 4.5则构建了一个更丰富的场景:电梯检测到超重,原因竟是保安的工牌和门禁卡被系统识别为两个人,保安"愣了三秒气笑了"。
从叙事技巧来看,Sonnet 4.5的故事有更多人物互动、情绪铺垫和出人意料的反转,文学质感明显更胜一筹。Claude在创意写作上的优势与Anthropic的训练方法论密切相关——Anthropic采用"Constitutional AI"(宪法AI)框架,在通过人类反馈强化学习(RLHF)进行对齐时,特别注重模型输出的细微差别(nuance)和情感层次感。此外,Claude的训练数据在文学、心理学和人文类语料上的配比据推测权重较高,这使得它在叙事节奏、人物塑造和情绪转折方面天然具有优势。
数学推理:GPT 5.1逻辑更清晰
测试题是一道拼车费用分摊问题:三位同事共乘一辆车,总费用60元,需按各自单独打车的价格占比来分摊。
两个模型都给出了正确答案,但在推理过程的呈现上有明显差异。GPT 5.1 Thinking先给结论再逐步推导,每一步计算清晰可追溯;Sonnet 4.5虽然也算对了,但过程的条理性稍逊。
在纯计算和逻辑推理任务上,GPT 5.1 Thinking展现出更强的结构化思维能力,这与其"动态调整思考时间"的设计理念一致——面对数学问题时,模型会自动进入深度推理模式,分配更多的计算步骤来确保每一环节的逻辑严密性。这种"先结论后推导"的呈现方式也反映了OpenAI在用户体验上的设计考量:让用户先知道答案是否可信,再决定是否需要验证推导过程。
心理咨询:Claude更像朋友,GPT更像教练
第一道心理题:累但焦虑
用户表达"什么都不想干但又焦虑不努力会混不下去"。GPT 5.1 Thinking的回复非常系统化:先帮你搞清三个问题,给出代差清单,提供最低配和进阶版方案,内容丰富且有条理。Sonnet 4.5则更注重情感共鸣,先认同感受再给建议。
这种差异本质上反映了两种不同的心理辅导流派:GPT更接近认知行为疗法(CBT)的风格,强调通过结构化的行动方案来打破负面循环;而Claude更接近人本主义心理学的"无条件积极关注",先建立情感联结再引导改变。
在这道题上,测试者认为GPT 5.1表现更好,因为它提供了更具操作性的方案。
第二道心理题:做事虎头蛇尾
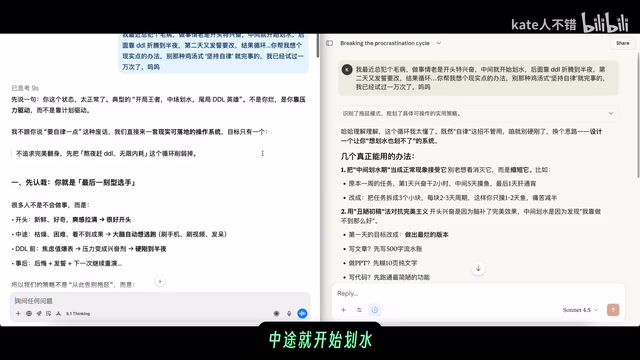
用户明确要求"不要鸡汤式的坚持自律"。Sonnet 4.5的开场是"啊哈哈我理解这个循环,我太懂了",给人一种朋友聊天的亲切感,然后提出"设计让你想滑水也滑不了的系统",包括接受滑水期、用丑陋初稿对抗完美主义、物理切断滑水环境等实用建议。
GPT 5.1 Thinking则开场说"不是你烂,是你靠压力驱动而不是靠计划驱动",虽然直接但略带说教感。测试者指出,既然用户已经知道自己的状态,这种"诊断式"开场反而让人不太舒服。
结论:在需要情感连接的场景中,Claude Sonnet 4.5的"朋友式"沟通风格更受欢迎。
指令遵循与逻辑推理
字数控制测试
要求模型恰好写40个字且包含三个指定要点。Sonnet 4.5精确完成了40字,GPT 5.1写了37字。在中文字数统计方面,Claude表现更精准。
中文字数统计对大语言模型而言是一个看似简单实则棘手的挑战。这涉及到模型的分词器(Tokenizer)设计——大多数模型使用BPE(Byte Pair Encoding)分词,一个中文字符可能对应1-3个token,模型在生成时需要在token层面"翻译"回字符层面的计数,这个映射过程容易产生偏差。Claude在这方面的精准度可能得益于Anthropic在中文对齐训练中的专项优化。
逻辑推理题
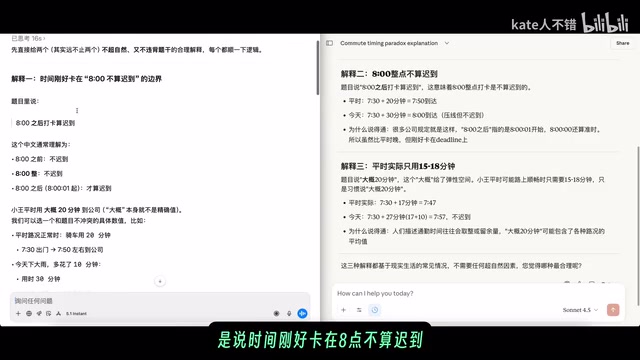
题目设定小王骑车20分钟上班,今天多花10分钟却没迟到,要求给出合理解释。GPT 5.1 Thinking给出了两个非常贴近现实的答案:一是"8点整不算迟到,8:01才算";二是"考勤系统时间和真实时间不一致"。Sonnet 4.5的解释中有一条"平时只用15-18分钟"略显勉强。
在这类需要严密逻辑的推理题上,GPT 5.1 Thinking的表现更为出色。
编程与前端生成:GPT 5.1指令遵循惊艳
测试者用一个极其详细的提示词要求生成"绵羊理发店"网页,包含窗格透明玻璃、聚光灯效果、三层货架六个蓝色瓶子、黑白格子围布、金属脚踏板、欢迎地垫等数十个细节要求。
这类前端生成任务实际上综合考验了模型的多项能力:对自然语言描述的精确理解、HTML/CSS/JavaScript的代码生成能力、空间关系的推理能力,以及将抽象视觉描述转化为具体样式参数的能力。它本质上是一个"自然语言到可视化"的端到端任务,比纯粹的算法题更能体现模型的综合素质。
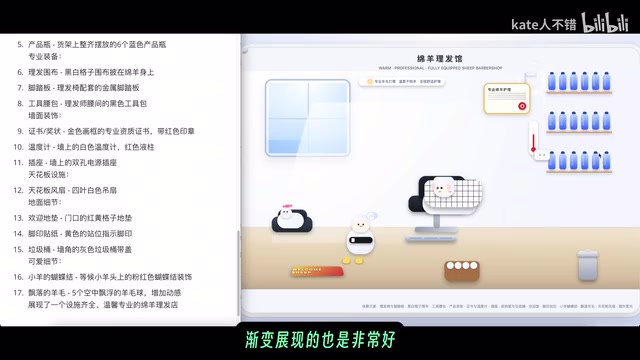
GPT 5.1 Thinking的表现令人印象深刻:
- 六个瓶子不多不少,精确遵循
- 地垫上的"Welcome"文字清晰自然
- 唯一一个将黑白格围布正确围在绵羊身上的模型
- 理发师腰包、剪发工具等细节都有体现
- 窗外光线的渐变效果模拟得很好
对比其他模型(疑似Gemini 3的"refer"模型、Kimi KL、Haiku 4.5),GPT 5.1在前端生成的指令遵循和视觉质感上都处于领先地位。
总结:各有所长,按需选择
经过多维度测试,两款模型的定位差异非常清晰:
| 维度 | GPT 5.1 Thinking | Claude Sonnet 4.5 |
|---|---|---|
| 数学推理 | ⭐⭐⭐⭐⭐ | ⭐⭐⭐⭐ |
| 逻辑分析 | ⭐⭐⭐⭐⭐ | ⭐⭐⭐⭐ |
| 创意写作 | ⭐⭐⭐ | ⭐⭐⭐⭐⭐ |
| 情感沟通 | ⭐⭐⭐ | ⭐⭐⭐⭐⭐ |
| 指令遵循 | ⭐⭐⭐⭐⭐ | ⭐⭐⭐⭐ |
| 编程/前端 | ⭐⭐⭐⭐⭐ | ⭐⭐⭐⭐ |
选择建议:
- 需要精确计算、编程开发、复杂指令执行 → GPT 5.1 Thinking
- 需要创意写作、心理陪伴、情感化对话 → Claude Sonnet 4.5
正如标题所言:Claude更懂人,GPT更会算。两者并非替代关系,而是互补关系,聪明的用户应该根据具体场景灵活切换。这也预示着AI工具使用的未来趋势——不再是"哪个模型最好"的单一选择题,而是构建个人的"模型组合"(Model Portfolio),针对不同任务调用最适合的AI能力。
核心要点
- GPT 5.1包含Instant和Thinking两个模型,均具备自适应推理能力,Thinking模型可动态调整思考时间
- 在数学推理、逻辑分析和指令遵循方面,GPT 5.1 Thinking表现更优,推理过程结构化程度更高
- 在创意写作和情感沟通场景中,Claude Sonnet 4.5展现出更强的文学质感和"朋友式"沟通风格
- GPT 5.1在前端代码生成任务中指令遵循能力惊艳,是唯一正确完成所有细节要求的模型
- 两款模型定位互补:GPT擅长计算和执行,Claude擅长创意和共情,用户应按需选择
相关推荐
 产品体验
程序员桌面布局指南:打造让你「回到家」的高效工作空间
探索程序员如何打造高效舒适的桌面布局。从多显示器配置到人体工学设计,解析技术工作者的桌面哲学,帮助你构建提升专注力与生产力的个人工作空间。
 产品体验
Qoder vs Cursor实测对比:同样20美金谁更强?
实测对比Qoder和Cursor两款AI IDE,从Agent自主修复能力、人工沟通次数、架构决策等维度评测。Qoder仅需2次沟通完成任务,Cursor需8次。详细分析两者差异,帮你选择最适合的AI编程工具。
 产品体验
Cursor云Agent演示:打通软件开发全链路瓶颈
深度解析Cursor云Agent最新Demo,展示如何通过云端虚拟机、自动测试产物和全链路控制平面,系统性消除软件开发生命周期中的人类瓶颈,让Agent自主运行、人按需介入。