GPT-5.6实测对比:便宜20倍但创意能力输给旗舰模型

GPT-5.6(内部代号 Sol)的发布,让整个 AI 圈再次热闹起来。官方基准测试数据显示它在多个维度上「完胜」竞品,价格却便宜得多。然而基准测试从来只是故事的一半。本文基于一位资深测试者长达一整天的横向实测,将 GPT-5.6 与 Anthropic 阵营的旗舰模型进行了多轮真刀真枪的对比,试图回答一个核心问题:便宜近 20 倍的模型,输出质量真的够用吗?
跑分很惊艳,但实测才见真章
GPT-5.6 Sol 的官方跑分确实亮眼,在与竞品的基准对比中号称「完胜」,且定价大幅低于对手。产品落地页设计也颇具巧思——Saw、Tera、Luna 几个子模型如星球般悬浮排列,视觉体验相当出色。
值得注意的是,AI 领域的**基准测试(Benchmark)**存在系统性局限,常见的评估集如 MMLU(大规模多任务语言理解)、HumanEval(代码生成)、GSM8K(数学推理)等,均面临训练数据污染(模型可能在预训练阶段见过测试题)、过度优化特定指标(即 Goodhart 定律效应)以及无法捕捉真实工作场景复杂性等问题。业界将这种现象称为「基准游戏」(benchmark gaming)——模型在榜单上的亮眼表现,未必能平移到实际生产环境。
正如测试者反复强调的:看基准是一回事,用真实工作任务上手测又是另一回事。 关键在于你的实际用例、提示方式以及对模型参数的把控。于是这场评测没有停留在数字层面,而是通过三组游戏/网页生成任务、一组多模拟器任务,以及大量 API 单次调用,来还原最真实的使用体感。
三轮创意生成对决:旗舰模型完胜
第一轮:浏览器开放世界小游戏
测试者给两款模型完全相同的提示词——做一个能在浏览器里运行的开放世界小游戏,并给予充分创作自由。结果颇具戏剧性:旗舰模型做出的版本更接近 GTA 式的 3D 开放世界,地图更大、探索感更强、物理效果更自然;Sol 的版本虽然功能齐全,但俯视视角操控略显别扭。旗舰模型完胜。
但成本对比才是重点:旗舰模型耗时约 21 分钟、花费约 14.22 美元、输出约 9 万 Token;Sol 耗时 23 分钟、仅花费 4.5 美元、输出约 3.1 万 Token。这里出现了一个关键概念——Token 利用率。Token 是大语言模型处理文本的基本单位,大约对应英文的 3/4 个单词或中文的 1 个汉字,模型定价通常按输入/输出 Token 分别计费。Sol 仅用约三分之一的 Token 量完成了同等任务,说明其信息压缩效率更高,但代价是输出质量明显弱于旗舰模型。Sol 用不到三分之一的成本完成任务,但输出质量明显更弱。
第二轮:最震撼的交互式网页
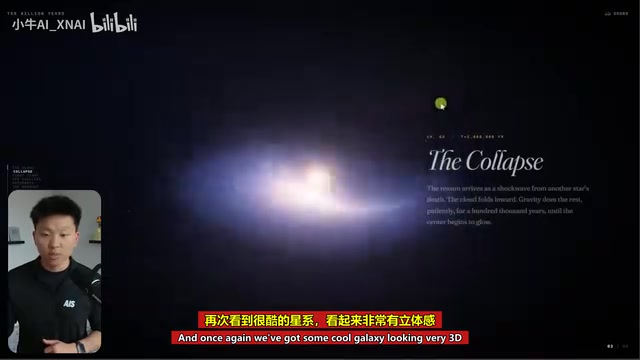
第二轮任务是「做一个最吸睛的交互式网页」。两个版本都做出了带音效、可随鼠标交互的 3D 星系旅程动画,讲述宇宙演化的故事,包含星云坍缩、宇宙膨胀、超新星爆发等视觉特效。测试者认为旗舰模型的版本沉浸感更强、整体高出一个档次。
成本差距进一步拉大:旗舰模型用了约 23 分钟、19.24 美元、8 万 Token;而 Sol 只用了不到 7 分钟、约 1 美元出头、2 万 Token。旗舰模型几乎贵了 20 倍,但测试者仍基于质量选择了旗舰模型的输出。

多模拟器任务:Sol 首次扳回一城
第三组任务更加开放:「设计五个完全不同的视觉元素」。旗舰模型做出了飞行模拟器、圆环收集游戏、调色板生成器、深海下潜互动故事等,整体存在部分菜单遮挡的小 bug,缺乏特别惊艳的亮点。
Sol 这次表现出色:极光交响乐、失落回声图集、打字追踪游戏、幻灯片展示、潮汐池生命模拟器——在多样性和整体体验上更胜一筹,测试者将这轮冠军颁给了 Sol。
最惊人的是效率表现:面对「五倍复杂度」的任务,Sol 不但没变慢,反而是全场最快(约 7 分钟 vs 旗舰模型的 15 分钟),成本约 1 美元、22000 Token,而旗舰模型约 15 美元、65000 Token。这印证了一个反复出现的规律:GPT 系模型的 Token 利用率远高于对手。 这一特性可能源于模型底层架构对信息的更紧凑编码方式,以及训练阶段对简洁输出的强化——高 Token 利用率意味着在相同预算下可执行更多任务,是衡量模型实用价值的重要维度。
API 单次任务:Sol 的绝对主场
在脱离智能体循环、直接通过 API 进行单次问答的测试中,格局彻底反转。100 余次快速任务中,Sol 以 24 胜 3 负大幅领先旗舰模型。
这里需要理解AI 智能体(Agent)与单次 API 调用的本质区别。AI 智能体是指能够自主规划、调用工具、执行多步骤任务的 LLM 系统——它在循环中多次调用模型(Agentic loop),每次调用产生 Token 费用并累积延迟,对模型的延迟稳定性和工具调用准确率要求极高。而单次 API 调用则是无状态的一次性请求,更看重响应速度与直接准确性。Sol 在后者场景中的碾压性优势,恰恰说明了它为这类高频、轻量任务而生。
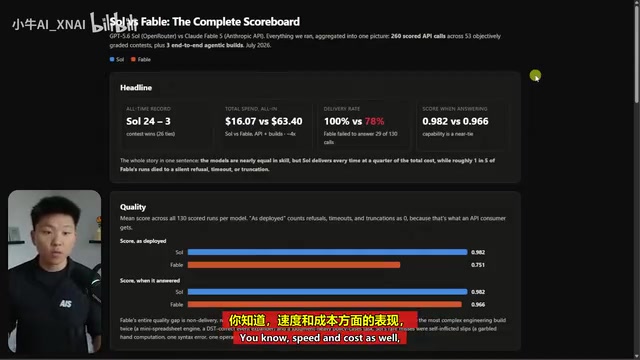
说个细节,旗舰模型有多次直接拒绝回答——其安全护栏设置相对更严。从实际回答率看,Sol 为 0.98,旗舰模型为 0.966,两者相差不大;后者「输」主要输在漏掉工具调用。成本上 Sol 花约 16 美元,旗舰模型花约 63 美元。
测试者由此提出一个精彩的观点——基于任务难度的单位经济学:这一概念源自 SaaS 行业,指单次服务交付的成本与收益分析。引入 AI 模型选型后,核心逻辑变为:任务难度决定所需模型能力,而非默认追求最强模型。如果任务难度是 5 分,你未必需要一个 10 分的模型,5、6 分的模型就够了。对于无状态的快速一次性请求,Sol 的性价比完胜。
更公平的横向对比对象
测试者认为,把 GPT-5.6 直接对标旗舰模型其实并不公平——两者本就不在同一量级。更合理的对比应是 Sol 5.6 对阵同价位的竞品:输入成本几乎一样,输出体量也相近。这也引出一个耐人寻味的疑问:既然是「下一代旗舰」,为什么只命名为 5.6 而不是 6?GPT-5.6 Sol 的定价策略(约为旗舰模型的 1/20)折射出 OpenAI 对产品矩阵的精细分层——用价格信号引导用户根据任务复杂度选择合适工具。也许 OpenAI 正在准备一个真正能与顶级对手正面竞争的 GPT-6,届时才会祭出「旗舰」定位。
延迟与稳定性:Sol 快但波动大
在延迟表现上,Sol 的 API 中位数延迟比旗舰模型更快,但平均延迟反而更慢——这说明 Sol 响应时间波动较大,有时极快、有时极慢;而旗舰模型更为稳定,基本维持在 20 秒左右。在实际的智能体构建场景中,延迟的可预期性至关重要:智能体循环中每一步的延迟抖动都会被放大,导致整体任务完成时间难以估算,影响系统的 SLA(服务级别协议)保障。旗舰模型几乎总是慢一些,但胜在稳定可预期,更适合对响应时间有严格要求的生产环境。

关于 Token 利用效率,测试者的判断是:即便两者定价完全相同,Sol 依然会明显更便宜,因为它对 Token 的处理效率高得多——这可能与其底层架构(如更高效的注意力机制或更紧凑的输出策略)和训练方式密切相关。
结论:Sol 是执行者,旗舰是管理者
经过一整天的全面实测,测试者给出了一个精辟的角色定位:
- 旗舰模型更适合当「管理者/联合创始人」:创意更强、写作质量更高、头脑风暴更到位、擅长策略规划,甚至会像顾问一样反驳你的请求(这实为优点)。综合能力上属于「完全另一个档次」。
- Sol 是极出色的「执行者」:价格低廉、代码执行能力强、细心排查 bug、能从多角度提出质疑、响应速度快。
理想的工作流或许是——让旗舰模型统筹调度一批 Sol 智能体,发挥各自所长。这种「异构智能体编排」架构(Heterogeneous Agent Orchestration)正成为 AI 工程领域的新范式:高能力模型负责任务分解与质量评估,低成本模型承担大量并行执行工作,在质量与成本之间找到系统性平衡。
最终的综合能力排序中,测试者认为 GPT-5.6 与同价位竞品非常接近,Sol 略领先于这两者,但距离旗舰模型仍有相当大的差距。Sol 绝对比上一代 GPT-5.5 更强,是一款极具性价比的模型,但其定价本身也说明了厂商对自身产品定位的清醒认知。
这场评测最大的启示或许是:AI 模型的选择正在从「唯跑分论」走向「单位经济学」。 没有绝对最强的模型,只有最适合你任务难度与预算的模型。便宜 20 倍的 Sol 在快速一次性任务中完胜,而追求极致创意质量时,多花的钱依然物有所值。
核心要点
相关推荐

iPhone Duo续航实测:一天一充跑不掉,大屏是耗电元凶
iPhone Duo续航实测:重度使用一天需至少充电一次,6.5小时亮屏约剩30%电量。大屏展开频率是耗电关键,MagSafe电池背夹可救场,长期衰减同样值得关注。

Kimi K3.1 Pro开源发布:2.8万亿参数逼近Opus
Moonshot发布开源MoE模型Kimi K3.1 Pro,2.8万亿总参数、1040亿激活参数,Terminal Bench 4.0仅落后Opus 5.5不到1分,单任务成本约三分之一,API价格减半,开源权重11月4日开放。

Costco科技产品价格竞猜:显示器、键鼠、Bose音响值不值?
YouTube博主在Costco竞猜科技产品价格:2K 180Hz显示器、罗技键鼠、Bose音响和CyberPower UPS实测估价,揭示仓储会员店的选品定价逻辑与品牌溢价真相。