GPT-6.1 Sol 实测:3D任务不敌Claude Opus 5.5?

GPT-6.1 Sol 以Sonnet同等定价登场,3D生成不及对手,但视觉理解与token效率表现亮眼。
OpenAI 开发者日发布的 GPT-6.1 Sol 定价与 Claude Sonnet 5.5 完全一致(输入2美元/输出10美元每百万token),将竞争层级从Opus直接下移至Sonnet档位。在UP主以3D游戏生成为核心的测试中,Sol整体表现「competent但不惊艳」,泳池派对、滑板城市等任务的视觉效果普遍逊于Sonnet 5.5;但在静态场景复刻(《宋飞正传》Jerry公寓、RuneScape界面)上展现出强劲的视觉理解能力,机械臂测试中「知难而退」的决策方式也获得一定认可。全程token消耗仅约3%,效率突出。测试者坦承评测框架偏重3D视觉,Sol在底层软件工程、边缘设备等领域的潜力尚未充分验证,单一维度横评不足以为前沿模型盖棺定论。
新模型登场:GPT-6.1 Sol 的定位与定价
OpenAI 在开发者日推出了 GPT-6.1 Sol,这是继 GPT-6 Sol 之后的快速迭代版本。相比前代,Sol 没能在 3D 生成这类测试中给人留下深刻印象,而这次的 6.1 版本被官方描述为「接近 Astra 智能水平」——Astra 是 OpenAI 当前最强的可用模型,输出价格高达每百万 token 50 美元,而 Sol 只需其五分之一的成本。
这个定价是关键。GPT-6.1 Sol 的价格为输入每百万 token 2 美元、输出每百万 token 10 美元,与前一天发布的 Claude Sonnet 5.5(视频中称 Sonic 5.5)完全一致。这意味着原本被视作 Opus 级别竞争者的 Sol,如今在价格上直接对标 Sonnet。模型知识截止为 April 30, 2026,拥有超过一百万 token 的上下文窗口、12.8 万的最大输出 token,输入支持文本与图像两种模态。
从基准测试看,6.1 相比 6 Sol 在仅 8.1 的版本号增量下实现了相当不错的能力提升。值得一提的是 DeepSWE 得分:该模型在高推理强度(high reasoning effort)下表现最佳,而非 Max 或 Ultra 这类更高档位。这呼应了近期一个趋势——更高的推理强度并不总是带来更优结果,有时反而因模型「做得过多」而导致特定基准分数下降。
DeepSWE 是一个专门用于评估大模型在软件工程任务上能力的基准测试,全称 Deep Software Engineering Benchmark,主要考察模型在真实代码库中完成复杂编程任务的表现,包括理解已有代码结构、定位缺陷、编写补丁等。它与 SWE-bench 类似,但更注重高难度、多步骤的工程推理场景。「推理强度」(reasoning effort)是 OpenAI API 中的一个可调参数,允许开发者在 low/medium/high/max 等档位之间选择模型花费多少计算资源进行内部「思考」,较高档位意味着更长的思维链,但并不总是产出更好的答案——某些基准测试反而在中等强度下得分更高,原因在于过度推理会导致模型在简单任务上「绕弯子」,引入不必要的错误。
3D 游戏测试:竞争力与现实落差
UP主在搭载 Blender 和 Godot 的测试系统上运行了一系列 3D 生成任务,涵盖后院泳池派对、GTA 风格城市、轨道飞行游戏、地铁 FPS 以及滑板游戏等。
泳池派对测试颇具代表性。为确保公平,测试者清空了所有缓存与临时文件,确认模型没有任何先前结果的残留,并分别在 Ultra(含 fast 模式)和纯 Max 模式下运行。结果两次产出高度相似——Max 模式只是更慢而已。坦率地说,这一结果在视觉上远不及前一天 Sonnet 5.5 的版本,尤其是角色建模的精细度。
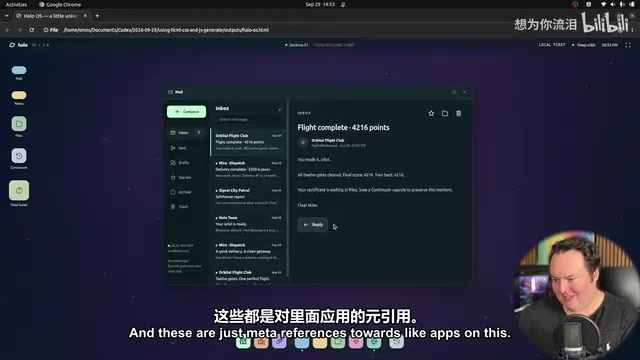
一个有趣的观察是「邮件应用」的收敛行为:多个不同厂商的模型都不约而同地把邮件应用与游戏功能联系起来,比如从邮件里直接启动游戏、接收飞行状态报告。这种跨厂商、跨模型的功能收敛现象,是观察当前大模型行为模式的一个有趣切口。
轨道飞行游戏(Orbital Run)则获得了较高评价——音效随速度升高而变调、包含音乐实验室功能、甚至有存档回溯(Chrono)机制。这个结果在 Max 模式下完成得相当迅速,整体「competent,但没有惊艳」。
「邮件应用」收敛现象背后有一个可能的解释:大模型在训练数据中大量接触了游戏开发教程、示例代码和 GitHub 项目,这些资料中恰好有相当比例使用邮件通知作为游戏事件的演示载体(如飞行状态报告、任务完成提醒)。当不同厂商的模型独立完成相似任务时,若训练数据存在系统性重叠,便容易收敛到相似的实现细节。这种现象与学界观察到的「模型同质化」问题相关——尽管架构各异,但共享的网络语料会令多个模型在特定场景下产生近乎相同的行为模式。
滑板游戏与机械臂:短板与亮点并存
自包含 C++ 滑板游戏测试带来了转折。初版结果是一个相当空旷的纽约街区,没有行人交互,与 Sonnet 那个「生机勃勃的城市」差距明显。但在测试者追加提示(要求做得更好、并明确允许使用多文件而非单文件 C++)后,模型产出了显著改进的版本:水面效果出色、建筑在水中的倒影逼真、音效完整。

来自评论区建议的「回放功能」表现亮眼——按 Z 键可触发完成特技后的电影化回放,模型需要自行判断特技的起止时间点,这一点处理得相当到位,被测试者称为「X Games 级别的 Pro Skate 效果」。
机械臂抓取测试则展现了另一种能力特征。模型在高推理强度加 fast 模式下工作了 18 分钟,每次目标车辆被移动、翻转或挪远,机械臂都能很好地导航到位,动作细腻、破坏性小。但最终模型「主动放弃」了任务——它判断自己无法完成而选择停止。相比之下,Sonnet 5.5 虽然成功完成,却是以近乎破坏性的、运气成分很大的方式做到的。测试者对 Sol 这种「知难而退」的决策反而给予了一定尊重。
场景复刻:视觉理解能力的闪光点
如果说游戏测试喜忧参半,那么静态场景复刻则暴露出 Sol 的真正强项——视觉理解。
《宋飞正传》中 Jerry 公寓的复刻被评为「绝对惊艳」。门上的多重锁、电脑屏幕上的文字细节、窗外的建筑、绿色 Klein 自行车连链条都做了建模、Porsche 海报,甚至还为不同场景(办公室、卧室、娃娃屋视角)提供了预设切换和光照控制。模型还引用了布景细节的来源。尽管布局仍不完全忠实于剧中实际样貌,但就单个元素的精细度而言,这是一次巨大的能力飞跃。
《RuneScape 2007》大交易所 PvP 的像素级复刻同样出色——物品栏界面的武器图标、鲨鱼、药水几乎像素级完美,连熟悉的 NPC 都复现了出来。主要不足是视角偏远、角色拟真度不够、无法触发特殊攻击。

SAAB 900 Turbo 的 3D 建模是测试者刻意选的难题——这款车形状独特怪异,难以套用传统跑车模板。结果虽不完全神似,但前下包围结构、保险杠上的标志性条纹、头灯纹理、引擎舱的减震塔和电池、轮毂造型都有可圈可点之处,还支持开引擎盖交互、换色、进入驾驶座等功能,可直接用于游戏。
Token 效率与综合评价
整场测试(含大量 Ultra 与 Max 模式任务)仅消耗了约 3% 的使用额度(从 98% 降至 95%),token 效率表现相当不错。测试者还尝试了一项非视觉任务——用 USB 和以太网连接一台装有 Red Hat 的老旧 Pentium 3 笔记本,试图让模型自主入侵登录界面并重装系统。但因切换到权限更宽松的 Daybreak 模型意外降级,加上需要人工介入,该实验未能成功。
综合来看,GPT-6.1 Sol 是一个 competent、token 高效且相对便宜的模型。但在这位 UP主最擅长的 3D 视觉任务上,它未能达到前一天 Sonnet 5.5 带来的「mind-bending」水准。鉴于两者如今价格完全相同,这对 Sol 并不有利。
测试者也坦承其评测框架的局限——Sol 可能在边缘设备优化、底层软件能力等未充分探索的领域更有优势。换言之,Sol 不是更差,而是在这个频道偏重的测试类型上更弱。这一自省恰恰值得读者注意:单一维度的横评,不足以给一个前沿模型下定论。
文中提到的 Daybreak 是 OpenAI 内部或测试环境中权限宽松的模型版本,通常用于允许模型执行更高风险操作(如系统命令、网络访问)的实验场景。Red Hat 笔记本入侵实验所涉及的「自主入侵登录界面并重装系统」属于 AI Agent 在真实计算机环境中执行多步骤操作的典型测试,与 OpenAI 的 Operator 能力方向高度相关。此类测试要求模型不仅能生成代码,还需在反馈循环中根据实际输出动态调整策略,是当前前沿模型能力边界探索的重要方向之一。
相关推荐

Opus 5.5实测:一个Skill把PDF变成交互式动画电子书
开发者基于 Claude Opus 5.5 打造开源 Skill「Papermorph」,通过 PDF→规划→分镜→旁白→动画测验的流水线,把静态 PDF 自动转化为带交互测验的动画网页电子书,且暂未使用图像模型。本文拆解其工作流与技术亮点。

Perplexity押注垂直整合:Vera芯片替代x86背后的Agent基建野心
Perplexity宣布垂直整合其智能体基础设施,自建沙箱并押注Vera架构替代x86,开始部署Perplexity Computer。本文解析这一战略背后的技术逻辑与行业意义。

Extra Big Ass Intelligence:一场对AI炒作的幽默反讽
Extra Big Ass Intelligence是一个在Hacker News走红的恶搞项目,用幽默反讽调侃AI行业的过度炒作与命名通胀,引发技术社区对AI营销泡沫的集体反思。