#模型定价
共 10 篇相关文章

GPT-6.2双模型发布:Astra与Sol的定价、基准与争议
OpenAI发布GPT-6.2 Astra与GPT-6.2 Sol双模型,Astra降价至前代80%并强化长任务能力,Sol维持低价。本文解析定价、基准实测与社区争议。

Gemini 4 Hydrogen发布:谷歌新模型为何命名氢?
谷歌发布Gemini 4 Hydrogen,接替Flash主打速度与效率。本文解析其命名“氢”的商业意图、100万Token定价策略、4档思考级别,以及为何分层协同架构是智能体时代的主线。
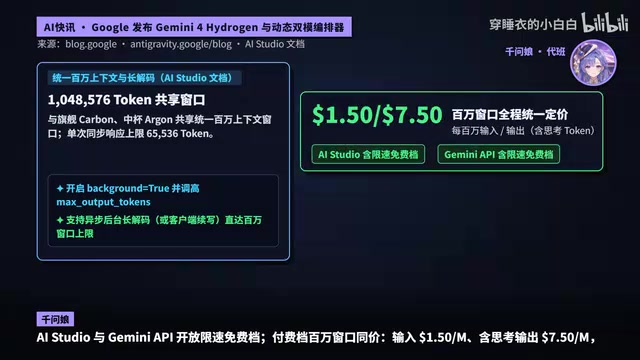
Gemini 4 Hydrogen发布:百万上下文统一价,动态编排器省24%额度
Google发布Gemini 4 Hydrogen,主打高速智能体场景,与Carbon、Argon共享百万上下文窗口,输入每百万1.50美元、输出7.50美元统一价,Orchestrator动态编排器在Terminal Bench上节省24%额度。
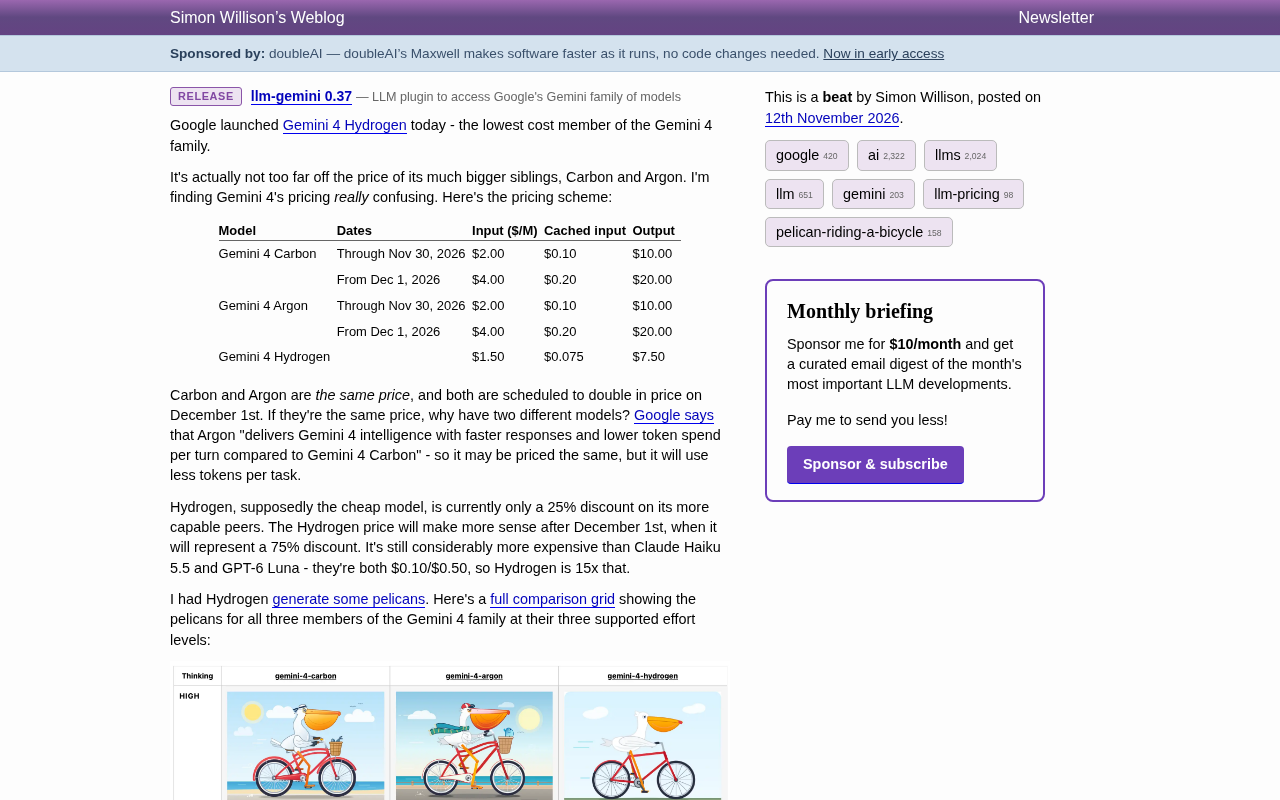
Gemini 4 Hydrogen发布:低价模型定价策略与性能对比
Google发布Gemini 4 Hydrogen,本文分析其定价策略、与Carbon/Argon的性能对比,以及作为免费层模型和多模型工作流执行引擎的定位。
Fable 5.2 与 Opus 5.5 成本对决:单位任务成本更低
Fable 5.2 单位 token 价格是 Opus 5.5 的两倍,但官方数据显示其高努力等级下性能匹敌 Opus 5.5 最高努力,且每任务成本仅约一半。本文解析这一成本效率差异及其对模型选型的启示。
Kimi K3.1 Pro定价与基准测试:开源权重承诺与成本真相
Kimi K3.1 Pro 定价每百万 token 输入2美元、输出10美元,Terminal-Bench 4.0 得分65.7%(厂商自报),并承诺11月4日前开放权重。本文拆解其定价结构、基准可信度与每任务真实成本。
GPT-6.1 Terra深度解读:中端模型的视觉与电脑使用定位
OpenAI发布GPT-6.1 Terra,主打视觉推理与电脑操作,定价介于旗舰Sol与轻量Luna之间。本文解读其中端定位、定价策略、适用场景及推理等级实测表现。

GPT-6.1 Terra:$1/$5定价与Terminal-Bench 4.0跑分解析
OpenAI GPT-6.1 Terra 以每百万 token $1/$5 定价推出,Terminal-Bench 4.0 厂商自报 50.3%,价格仅为 Sol 一半。本文解析其定价策略、跑分含义与适合路由的任务类型。

LLM定价调整追踪:Inceptron、OpenInference等四家服务商变动
监测数据显示Inceptron、OpenInference、Relace和Wafer四家LLM服务商出现定价调整。本文解析模型定价变动对AI开发者成本结构与供应商选型的影响。

Claude Opus 5.5对决GPT-6:AI模型价格战全面开打
Anthropic发布Claude Opus 5.5,OpenAI紧随推出GPT-6 Sol与Luna,引爆新一轮大模型价格战。本文解析各模型定价、缓存成本变化及实测表现,包括Opus 5.5 max模式过度思考崩溃等关键发现。