GPT-6.1 Sol 文档OCR实测:表格解析能力大幅跃升
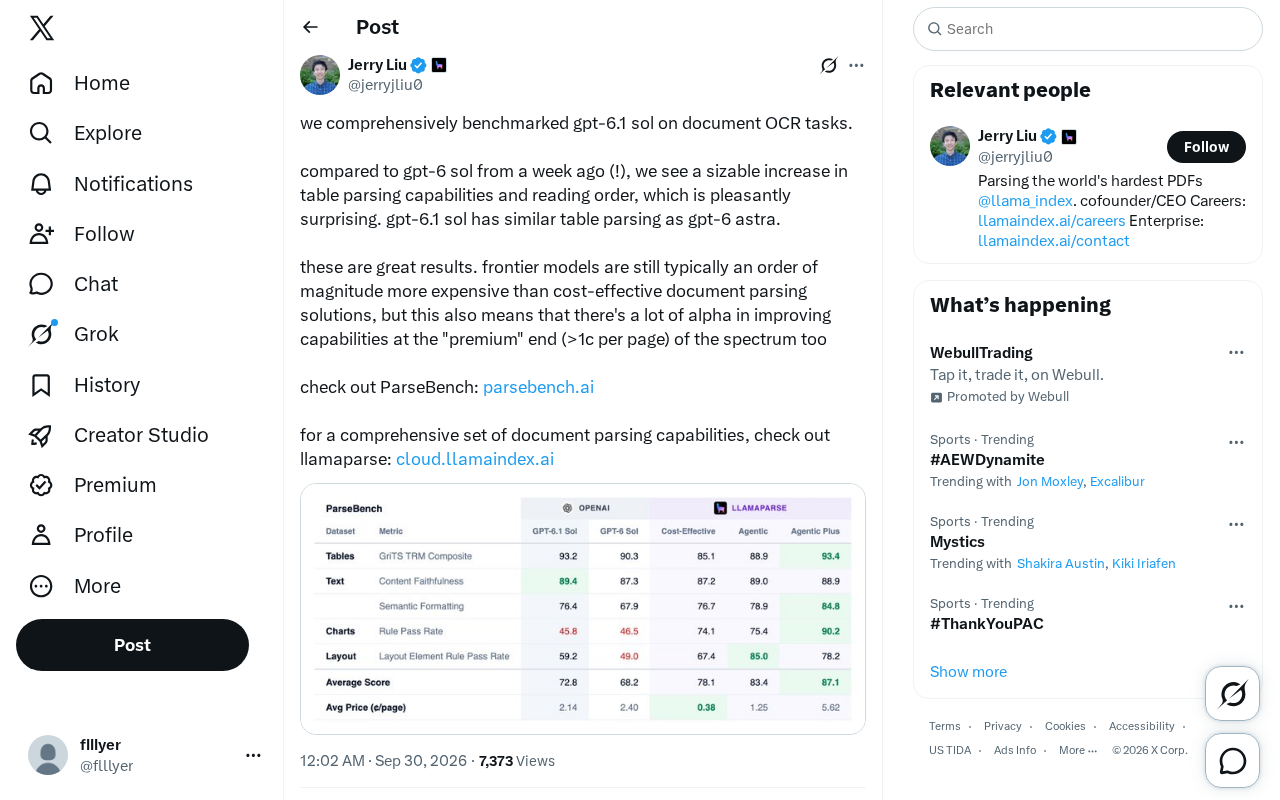
GPT-6.1 Sol 一周内在表格解析和阅读顺序能力上显著提升,但前沿模型成本仍比专用方案高一个数量级。
LlamaIndex 团队基于 ParseBench 基准对 GPT-6.1 Sol 进行文档OCR评测,并与仅一周前发布的 GPT-6 Sol 对比。结果显示,6.1 Sol 在表格解析和阅读顺序两个核心维度上均有显著提升,其表格解析能力甚至已接近定位更高的 GPT-6 Astra。这一进步令测试团队感到"惊喜",体现了前沿模型在结构化文档理解上的快速迭代。然而,前沿模型的成本通常仍比专用解析方案高出一个数量级,每页超过1美分的定价使其主要适用于对精度要求极高的高端场景。测试团队认为,正是这个高端市场存在大量尚未被充分开发的能力提升空间,值得技术团队重点关注。
一周之内,前沿模型的OCR能力再迎升级
大模型在文档解析(Document OCR)领域的迭代速度正在加快。据LlamaIndex团队发布的基准测试结果,他们对 GPT-6.1 Sol 在文档OCR任务上进行了全面评测,并与仅仅一周前发布的 GPT-6 Sol 进行横向对比。
结果令人意外:在表格解析(table parsing)和阅读顺序(reading order)两个关键维度上,GPT-6.1 Sol 都出现了显著提升。测试团队用"pleasantly surprising"(令人惊喜)来形容这种进步——要知道,前后两个版本的发布间隔仅有一周时间。
表格解析:追平更高定位的 GPT-6 Astra
在企业级文档处理场景中,表格解析历来是OCR技术最难啃的硬骨头之一。复杂的合并单元格、多层表头、嵌套结构,往往会让解析结果出现错位或丢失。
根据测试团队的说法,GPT-6.1 Sol 在表格解析能力上已经接近 GPT-6 Astra 的水平。这里值得关注的是模型命名逻辑:"Astra"通常对应更高定位的旗舰版本,而"Sol"则是相对更注重成本效益的版本。6.1 Sol 能够在表格解析上追平上一代的 Astra,意味着OpenAI在优化中低定位模型的核心能力上取得了实质进展。
阅读顺序的改善同样重要。文档中文字的正确排序直接决定了下游任务(如信息抽取、问答)的准确性,多栏排版、图文混排都会让阅读顺序判断变得复杂。这两项能力的同步提升,反映出前沿模型在结构化文档理解上的整体进步。
阅读顺序(Reading Order)是文档解析中另一个容易被低估的难点。对于人类读者而言,从左到右、从上到下的阅读习惯使顺序判断几乎是无意识完成的,但对模型来说,PDF等文档格式中的文字流并不总是按视觉顺序存储。多栏排版(如学术论文的双栏格式)、图文混排(文字绕图)、脚注与页眉的穿插,都会导致底层文字流与视觉顺序严重错位。如果阅读顺序判断失误,后续的信息抽取、摘要生成等任务会接收到语义混乱的文本输入,准确率随之大幅下降。正因如此,阅读顺序与表格解析一同被视为衡量文档理解能力的核心指标。
成本仍是前沿模型的主要门槛
测试团队同时给出了一个务实的判断:前沿模型在文档解析任务上的成本,通常仍比专用的高性价比解决方案高出一个数量级。
这意味着,尽管 GPT-6.1 Sol 的能力表现亮眼,但在大规模、成本敏感的文档处理流水线中,专用解析方案依然具备明显的经济优势。不过,测试团队也指出了另一面——正因为前沿模型定位在"premium"区间(每页成本超过1美分),这个高端市场反而存在大量的能力提升空间("a lot of alpha")。
换言之,当基础的、低成本的文档解析已经相对成熟时,真正的技术红利可能正在转向那些愿意为更高准确率、更复杂文档结构买单的高端场景。这对想要在文档智能领域构建差异化产品的团队,是一个值得思考的方向。
评测工具:ParseBench 与 LlamaParse
此次基准测试基于 LlamaIndex 推出的 ParseBench 完成,这是一套面向文档解析能力的综合评测基准,可用于横向比较不同模型与方案在OCR、表格、阅读顺序等任务上的表现。
对于需要实际落地文档解析能力的开发者,团队还推荐了 LlamaParse,它提供了一整套较为完整的文档解析能力。将标准化的基准测试(ParseBench)与可用的工程工具(LlamaParse)结合,为评估和选型提供了相对客观的参考路径。
ParseBench 的意义在于为一个长期缺乏统一标准的领域提供了横向对比的基准线。此前,不同文档解析方案往往各自定义评测指标,导致"准确率"数字之间几乎无法直接比较。ParseBench 通过标准化的测试集和评分维度(涵盖OCR文字识别、表格结构还原、阅读顺序等),使研究者和工程团队能够在同一把尺子下衡量 GPT-4o、Claude、专用解析引擎等不同路线的真实表现。LlamaParse 则是 LlamaIndex 提供的工程化文档解析服务,底层整合了多种解析策略,可作为 RAG(检索增强生成)管道的前置处理模块,将非结构化文档转化为模型可消费的结构化文本。两者结合,一个负责"测",一个负责"用",形成从评估到落地的完整链路。
小结
GPT-6.1 Sol 在一周之内实现表格解析与阅读顺序的明显提升,展示了前沿模型迭代的惊人速度。但成本数量级的差距提醒我们,模型能力并非选型的唯一指标。对多数企业而言,如何在能力、成本与文档复杂度之间找到平衡,才是落地文档智能的关键。
(注:以上内容来自 LlamaIndex 团队在 Twitter 发布的基准测试结论,具体数据以 ParseBench 官方结果为准。)
相关推荐

智能体底座(Harness)比模型本身更关键:YC深度解析Agent架构演进
YC在Harness Night分享会上提出:决定智能体能力的关键不是模型本身,而是外层的Harness底座。本文梳理从GPT-2到自改进Harness的演进,解析Prime Agent、OpenJarvis、QM三大实践及Agent架构设计要点。

用n8n搭建LinkedIn线索抓取与丰富化自动工作流
一套基于n8n的LinkedIn线索抓取与丰富化自动工作流:只需填写职位、地点、行业和公司规模,系统即可自动生成含专业邮箱和验证状态的客户名单并写入Google表格。本文解析其流程、输出字段与合规注意事项。

SageMaker HyperPod:跨团队共享GPU集群的隔离与公平性实践
Amazon SageMaker HyperPod 推出跨团队共享GPU集群的参考架构,通过IAM Identity Center认证、Kubernetes命名空间隔离、Task Governance公平调度和成本分摊,实现算力安全共享与费用透明化。