GPT-6.1 Sol实测:性能追平Astra,价格却打到Sonnet级

GPT-6.1 Sol以远低于竞品的价格达到接近顶级模型的性能,擅长代码审查但长程实现仍弱于Opus 5.5。
OpenAI在GPT-6 Sol发布仅一周后上线了GPT-6.1 Sol,这款模型以2美元/百万输入token的定价、极低的缓存读取费用,在DeepSWE等基准上达到接近更贵竞品的分数。它最大的改进是修复了前代Astra模型"忽聪明忽愚蠢"的不稳定问题,稳定性足以让测评者信任其处理电汇发票等敏感任务。深度代码审查与根因分析是其强项,效率和成本均优于Sonnet系列;但在长时间无人值守的重度代码重写任务上,仍明显落后于Anthropic的Opus 5.5。测评者建议将两者协同使用,并指出其激进定价可能预示着AI API补贴时代正走向终结。
一次意料之外的模型迭代
就在Anthropic发布Opus 5.5引发行业震动的一周后,OpenAI接连推出了GPT-6 Sol和GPT-6 Luna两款模型,但反响平平。真正掀起波澜的是随后悄然上线的GPT-6.1 Sol——一款便宜得离谱、能力却出人意料强悍的模型。据这位获得早期访问权限的测评者所说,GPT-6.1 Sol距离GPT-6 Sol发布仅隔一周,从6.0到6.1的时间间隔短得反常。
这种反常间隔本身就透露了信息。测评者直言,6.1 Sol"很可能原本就不打算叫6.1 Sol"——它比GPT-6 Sol明显更聪明,token生成速度也明显更慢(通常意味着模型更大)。种种迹象表明,这并非一次简单的小版本升级,而是一个根本上不同的模型。
性能:接近Astra,远超预期
在Terminal Bench 4这项被测评者称为"疯狂"的基准测试中,GPT-6.1 Sol拿下了当前最高分(state-of-the-art)。更值得关注的是DeepSWE基准的表现:即便在low和high档位,6.1 Sol的得分也接近Astra在high档的成绩,但成本却低得可笑。
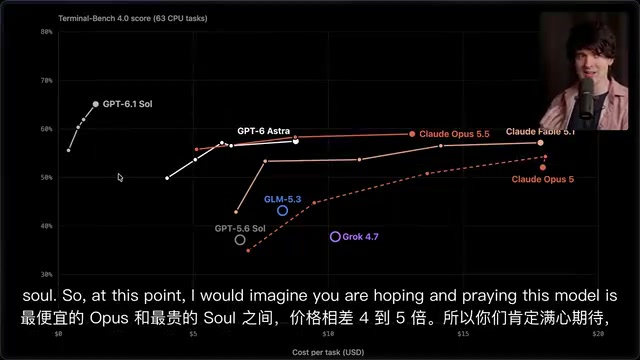
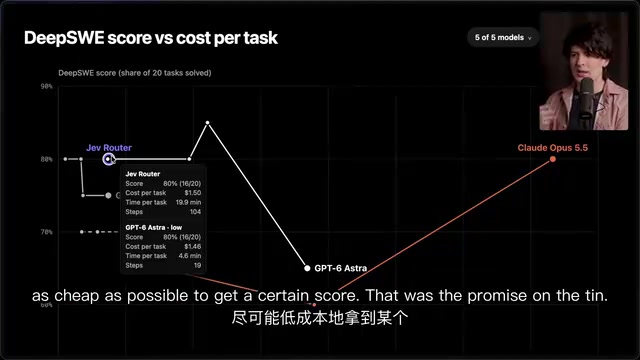
价格对比极具冲击力:6.1 Sol在low档跑一次仅需0.21美元,而Astra同档需要1.46美元,Opus 5.5在max档拿到相同分数则要花14.65美元。测评者坦言DeepSWE远非衡量模型日常编码能力的完美标尺,但"6.1 Sol能拿到接近Astra high档的分数"这一事实本身就值得注意。
在实际任务成本上,6.1 Sol单任务最贵约1.38美元,而Opus 5.5最便宜的运行也要5.12美元——这是4到5倍的差距。
DeepSWE 是一项专门评估AI模型软件工程能力的基准测试,要求模型在真实代码仓库中自主完成缺陷修复、功能实现等任务,通常以"通过率"衡量。其"low/high档位"指的是推理预算或最大步骤数的不同配置:low档限制模型的思考步数和工具调用次数,成本更低但允许的探索空间更小;high档则放开限制,允许模型进行更深入的多步推理,成本随之上升。Terminal Bench 4 则是侧重命令行环境下复杂任务自动化的评测集,包含需要调用系统工具、处理文件和执行多步操作的场景,因其对模型实际工程部署能力要求极高而被视为严苛指标。这两项基准的共同特点是贴近真实开发场景,比纯数学或问答类测试更能反映模型在生产环境中的可用性。
定价背后的商业信号
6.1 Sol的定价为输入每百万token 2美元、输出10美元,与GPT-6 Sol持平,是Astra价格的五分之一。但真正的杀手锏在缓存读取(cache read)价格:从惯常的正常读取价10%(即0.20美元)砍到了0.10美元,等于把缓存成本再腰斩,折扣从90%提升到95%。
测评者指出,这可能是OpenAI历史上首次改变缓存读取的定价逻辑。由于真实世界的agent工作负载中约96%都是缓存读取,这一改动让模型在实际编码场景中变得"便宜到荒谬"。
更深层的信号来自订阅政策的调整——$200 Pro订阅回归,但用量计算方式改变,实际相当于旧计划一半的API额度。测评者推测,这背后可能是补贴时代的终结:过去在$200的Codex套餐上能薅到超过1.2万美元的用量,如今随着新模型上线、利润空间收窄,OpenAI的补贴能力正在下降。业界传闻这些模型的毛利率高达95%,如今他们主动切入自己的利润空间。
缓存读取(Cache Read) 是大语言模型API中的一项计费优化机制:当同一段上下文(如系统提示词、大段代码库)在多次请求中重复出现时,服务商会将其缓存,后续调用直接读取缓存而无需重新处理,因此按更低的"缓存读取价"计费,而非完整的输入token价格。对于Agent工作流而言,每一步都携带完整的历史上下文和工具定义,缓存命中率极高——测评者提到实际负载中约96%属于缓存读取,意味着真实账单中绝大多数token都按缓存价结算。将缓存读取价从正常输入价的10%再腰斩至5%,等于把Agent场景下的实际成本压缩到标价的二十分之一,这也解释了为何6.1 Sol在真实编码工作流中"便宜到荒谬"——官方标价并不能反映开发者的实际支出。
Spiky问题得到改善,但峰值不如Astra
测评者对GPT-6 Astra最大的不满不是它不够聪明——恰恰相反,Astra在很多方面比Anthropic的顶级模型更聪明——问题在于它"又聪明又愚蠢",会毫无征兆地跌入"今年见过最蠢的错误"。这种不稳定的"spikiness"最终让测评者几乎放弃了它。

6.1 Sol在这方面"大体上"解决了问题:稳定性显著提升,峰值虽不及Astra那种"革命性的3D能力",但足够可靠。测评者甚至放心让它处理所有邮件、找出漏付的发票、在Chrome里为每笔投资开好标签页填好细节——"没有一处出错",甚至指出了他自己会漏掉的项目。"我真的信任这个模型帮我电汇资金。"
其他测试者的反馈也印证了这点:Julius称它"incredible",Ben称它"incredibly boring"——对这类模型发布而言,"无聊"恰恰是最好的评价。
测评者所说的"spikiness"(毛刺感)在AI模型评估语境中指模型输出质量的高度不一致性:模型时而表现出色,时而在极简单的任务上犯低级错误,且这种崩坏难以预测。这与平均能力不足是完全不同的问题——一个平均水平稍低但高度稳定的模型,在生产工作流中反而更可用,因为工程师可以建立明确的预期并设计相应的检查机制;而一个偶尔出现灾难性失误的模型,会迫使使用者对每一个输出进行人工复核,实际上抵消了自动化带来的效率收益。对于无人值守的Agent管道(agentic pipeline)而言,spikiness的危害尤为严重——单次工具调用错误可能引发级联失败,导致数十步后才被发现的不可逆操作。
擅长审查,不擅长实现
6.1 Sol展现出OpenAI模型特有的"罗威纳犬"式深挖能力——咬住一个问题反复撕扯直到找出所有缺陷。在代码审查任务中,它对Orchestrator V2的审计表现几乎与Astra持平,成本却只有一半(2.97美元 vs 5.84美元)。在改进T3 Code的任务上,它拿下87.4分,超过Astra的83.8分,成本仅2.15美元,而Opus 5.5要5美元、Sonnet 5.5近9美元。
效率是关键:6.1 Sol平均每次请求只读取约11万token,而Sonnet 5要36万token,输入token用量不到Sonnet的一半。测评者甚至让Opus 5.5盲测这个模型,Opus评价它"scoped work(限定范围任务)的前沿级模型",并在猜测定价时开出5美元/百万输入——当被告知实际是2美元时,Opus称之为"非常激进的定价"。
但短板同样明显:在长时间无人值守的重度重写任务上,6.1 Sol"会死守流程规则即使毫无进展,也不会主动求助"。测评者那个耗时数月、烧掉数十万token的TS到Rust移植项目,6.1 Sol、Astra、5.6 Sol都推不动,而Opus 5.5从头重写一晚上就搞定了。在长循环、重度重写这类任务上,"Anthropic遥遥领先"。
Fish Slop测试:图形惊艳,UI灾难
在测评者标志性的"Fish Slop"游戏生成测试中,6.1 Sol展现了矛盾的一面。3D图形效果"惊艳"——鱼类模型、潜艇、螺旋桨、水草的细节都远超Sonnet版本;但游戏操作手感明显更差、帧率更低,还堆砌了大量毫无必要的UI文字("喘口气""你的小世界可以等等"之类),足足二十多处。

"这个模型在UI上烂得无法接受……它没有品味,你得自己带品味来。"不过它在Blender建模上表现出色——给张截图让它通过CLI建3D模型,它能做到。考虑到整个游戏生成只花了约5美元,测评者认为这预示着"游戏开发即将天翻地覆",因为模型终于开始理解三维空间和相关工具链。
结论:绝佳的辅助,尚非新的主力
测评者的最终判断很清晰:6.1 Sol是一款"该死的好模型",价格惊人,完全可以成为你的默认编码模型。它几乎彻底取代了Sonnet的位置——"我基本没有理由再用Sonnet了"。但它还不足以取代Opus 5.5作为日常主力:Opus是更愉快的协作者,在不被卡住地持续实现代码方面明显更强。
理想的用法是二者协同——让Opus 5.5负责实现和长程构建,让6.1 Sol负责审查、根因分析、代码库调查和任务分诊。测评者已经在Cloud Config里配置好让Opus能调用Sol来审查自己的工作。
最后一层隐忧值得所有开发者注意:这次"惊人的价格"或许标志着补贴时代开始走向终结。OpenAI主动切入自己的利润空间、调整订阅计算方式,都在暗示未来这类模型的"极致性价比"可能不会长久。
相关推荐

Opus 5.5实测:一个Skill把PDF变成交互式动画电子书
开发者基于 Claude Opus 5.5 打造开源 Skill「Papermorph」,通过 PDF→规划→分镜→旁白→动画测验的流水线,把静态 PDF 自动转化为带交互测验的动画网页电子书,且暂未使用图像模型。本文拆解其工作流与技术亮点。

Perplexity押注垂直整合:Vera芯片替代x86背后的Agent基建野心
Perplexity宣布垂直整合其智能体基础设施,自建沙箱并押注Vera架构替代x86,开始部署Perplexity Computer。本文解析这一战略背后的技术逻辑与行业意义。

Extra Big Ass Intelligence:一场对AI炒作的幽默反讽
Extra Big Ass Intelligence是一个在Hacker News走红的恶搞项目,用幽默反讽调侃AI行业的过度炒作与命名通胀,引发技术社区对AI营销泡沫的集体反思。