GPT-6.1 Terra 实测解析:更便宜但更慢,值得换吗?

GPT-6.1 Terra 工作流能力提升明显,但非全能冠军,需盲测验证。
OpenAI 发布 GPT-6.1 Terra,归属 ChatGPT Work 与 Codex 产品面而非普通聊天。官方演示展示完整工作流,但是经过挑选的样本。独立对比显示其在建筑场景中耗时近四倍却成本更低;Agent's Last Exam 中等努力得分 57.6%,每任务成本从 84 美分降至 29 美分。然而在 Artificial Analysis 跨公司指数中最高仅 48,低于 Claude Opus 58 等竞品,幻觉率从 88% 降至 38%。文章强调每任务成本不含人工检查时间,建议在更换工作流前用真实任务做盲测,加入修改请求,以审查后存活的有用工作为评判标准。
OpenAI 发布了 GPT-6.1 Terra,官方演示里电车在软件中成型,玻璃球内的冬日村庄缓缓落雪。但真正的问题不是它能否生成惊艳片段,而是这些工作是否可用、完成需要多少成本、更强的模型在哪些场景仍不可替代。官方图表与首批独立测试给出了不同侧面的答案。
产品定位:属于工作流,而非普通聊天
一个容易被忽略的细节是:此次发布归属于 ChatGPT Work 和 Codex,而不是普通聊天界面。据 OpenAI 文档,访问权限覆盖 Plus、Pro、Business、Enterprise 和 Education 计划,工作区控制与逐步推送会影响实际可见性。开发者还可通过 API 模型标识符调用。
因此,在普通聊天窗口找不到 Tera 并不意味着故障——这是不同的产品面。理解这一点,是评估其价值的前提。
ChatGPT Work 是 OpenAI 面向企业团队的工作区产品,强调共享项目、管理员控制与数据隔离;Codex 则是其面向开发者的编程智能体环境,支持在沙盒中执行代码、调用工具并产出可运行项目。二者与普通聊天界面的关键差异在于权限模型、审计能力与可集成性——普通聊天面向个人即时问答,而 Work/Codex 面向需要留存、协作与合规审查的生产流程。因此同一模型在不同产品面中的可用性、工具集与上下文管理策略可能不同,评估时需先确认自己处于哪个入口。
官方演示:展示的是意图,不是随机样本
OpenAI 的演示展示了从请求到软件内一系列动作、最终产出可见结果的完整链条。这种工作流视角对创意工作很重要:一张有说服力的最终图无法告诉我们底层项目是否组织良好、是否可编辑、下一次修改是否容易。
这是一个经过挑选的公司演示,展示的是预期工作流,而不是模型可能尝试的所有任务的随机样本。对于三维项目,值得追问:对象是否独立?修改材质是否需要重建场景?小改动能否保留项目其余部分?这些问题区分了“欣赏演示”和“决定采用结果”。
独立创作者对比:更慢但更便宜的反例
Design Arena 尝试了一个相关场景:里斯本 Bellum Tower 的金色时刻。其公开对比要求新版 Tera 与旧版 5.6 生成建筑细节——水面、帆船、远处的桥。创作者报告 6.1 耗时接近四倍,但成本反而更低。
这组对比打破了一个常见预设:被宣传为“快”的模型未必在每个秒表测试中胜出。提示词、努力等级、工具设置和所选结果都有影响,单一场景无法定论。作者报告两次运行成本约为 0.05 美元和 0.08 美元,我们未独立复现账单。但该例说明,更便宜的 token 可以为更精细的结果留出空间,即使任务耗时更长。
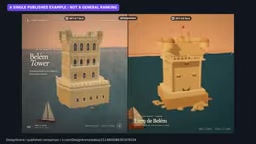
另一位创作者 Mr. Tactical 发布了与 Claude Haiku 5.5 的 three.js 雪球对比,称两者均使用高努力等级和相同提示词。但即使努力设置名称相同,也不能保证不同公司间的计算量对等。这类对比应保留提示词、源文件、耗时和失败尝试,然后换一个场景再测——短视频往往会省略部分信息,我们可以欣赏结果,同时对其证据保持比例感。
Design Arena 是一个面向设计任务的公开模型对比平台,创作者提交相同提示词与素材,由不同模型生成结果并公开耗时、费用与成品。这类平台的价值在于提供官方演示之外的第三方样本,但其局限同样明显:单次运行受提示词措辞、努力等级、工具配置和结果挑选影响,且不同厂商对“高努力”的定义并不统一。因此它适合作为方向性参考,而非采购决策的充分证据;阅读时应关注是否披露了完整提示词、失败尝试和账单截图。
基准图表:方向与边界
OpenAI 发布了六个图表系列:专业计算机任务、视觉推理、桌面操作、事实错误、终端编程和科学工作流。注意量表方向——成功率越大越好,事实错误率越小越好。这些是公司报告的测量值,应视为“去哪里调查”的地图,而非单个任务的保证。
核心数字与成本口径
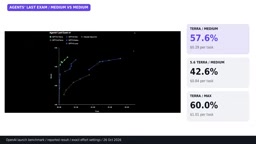
在 Agent's Last Exam 上,Terra 中等努力得分 57.6%,此前 Terra 为 42.6%,提升 15 个百分点。图表估算新模型每任务 29 美分,旧模型 84 美分。最高努力下达到 60%。
关键词是“任务”。每 token 价格衡量的是支付费率,而每任务成本还取决于模型做了多少工作。两者都不包含你本人检查交付物的时间。
视觉推理图表中,Terra 在最高努力下达到 85.5%。桌面操作是另一项挑战:在离线 OS World 2.1 上达到 74.2%。读屏与成功完成一系列动作相关但不可互换——熟悉的应用突然弹出对话框遮住“下一步”按钮时,理解文档只是任务的一部分。
OpenAI 的 Difficult Prompt Test 报告事实错误从低努力下的 53.6% 降至 16.7%,最高努力下为 4.3%。这些数字描述的是该测试,不是任何回答错误的概率。日常研究中,重要声明仍应追溯来源——流畅的答案可能在日期、产品限制或对比上出错。
终端编程在最高努力下为 50.3%,旧版 Terra 最高努力为 21.5%;科学终端工作流达到 58.3%。这些测试涉及用工具做事,而非仅选择答案,但仍覆盖定义好的任务和环境。分数不是智能体安全管理陌生生产系统的承诺。
“每任务成本”与“每 token 价格”是两个不同口径。每 token 价格是 API 计费费率,乘以实际消耗的输入输出 token 即得单次调用费用;而每任务成本是完成一个定义好的评估任务所消耗的总费用,包含模型在任务中多次调用、工具使用与重试的开销,因此会随模型“做多少工作”而波动。一个模型可能 token 单价更低,但因推理链更长而单任务更贵;反之亦然。两者都不计入人工检查交付物的时间,而这往往是实际工作流中最大的隐性成本。
跨公司对比:Terra 不是全能冠军
Artificial Analysis 提供了更广泛的跨公司比较。在其截取的排行榜中,Terra 最高努力得分 48,Sol 最高 52,Astra 与 Gemini 4 Argon 高努力约 53,Kimi C 3.1 Pro 为 55,而展示的 Claude Opus 和 Sonnet 配置为 58 和 57(需注意 Claude 的 fallback 条件)。这些指数值不是百分比。Terra 在成本上有竞争力,但并非总分最高的模型。
同一快照还包含 DeepSeek广告、GLM、Qwen、Minimax、Grok、Mistral 和 Meta 模型。展示所选配置及设置和成本,比收集各发布会的孤立头条分数更有意义。
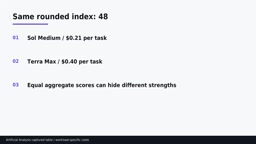
一个有用的对照:Sol 中等努力与 Terra 最高努力都四舍五入到 48,但显示的任务成本不同。相同总分不意味着相同强项。
Artificial Analysis 的独立分析让这一点更清晰:Terra 的低、中设置在智能与成本效率前沿上,更高设置位于前沿之后。最高努力下,新 Terra 比旧版提升 6 个指数点,任务成本从 1.40 美元降至 0.40 美元。其独立的 Coding Agent Index 得分为 48,Sol 为 54,Luna 为 31。这是另一套方法论,不要因为数字恰好相近就与智能分数混用。
该指数结合 10 项评估,主要是基于文本的英语套件,视觉理解和多语言能力另行测量。方法权重为:智能体 30%、编程 20%、通用任务 30%、科学推理 20%。总体提升可能掩盖某一领域的巨大变化和另一领域的小变化。采购决策应打开相关任务分解,并附上评估版本。
还有一项独立可靠性结果:在 Artificial Analysis 的私有知识测试中,幻觉率从旧版 Terra 的 88% 降至新版 38%。这里比率描述的是模型不知道答案时猜测的比例,而非所有回答错误的比例。该测试与 OpenAI 的困难提示错误图表定义不同,不可互换。令人鼓舞的是无依据猜测减少,但来源检查仍是工作的一部分。
Artificial Analysis 是一家独立模型评测机构,维护跨厂商的智能指数、成本效率前沿与编程智能体指数等多套榜单。其智能指数由多项评估加权合成(如智能体 30%、编程 20%、通用任务 30%、科学推理 20%),因此总分相近不代表强项相同;其 Coding Agent Index 采用另一套方法论,数值不可与智能指数直接混用。这类第三方榜单的价值在于统一口径下的横向比较,但评估版本、权重设置与测试语言覆盖都会影响结论,采购时应打开任务级分解而非只看总分。
API 成本算术与现实检验
标准 API 费率为每百万输入 token 1 美元、每百万输出 token 5 美元,缓存输入有单独更低费率。一个说明性任务:20,000 输入 token 和 5,000 输出 token,标准文本 token 费用为 4.5 美分。该计算不含工具费、重试和特殊定价条件,也不是实测的 Terra 运行。
设想处理 100 张发票:多数清晰,少数缺少采购订单、编号重复或手写更正。有用的结果不是 100 条自信录入,而是正确录入加上清晰的异常队列供人检查。如果助手节省 10 分钟生成工作却增加 15 分钟审查,表面节省就消失了。应测量“到检查通过结果”的时间,而非模型停止说话的时间。
模型页面还有另一区分:Terra 接受文本和图像并返回文本,可使用支持的工具,但这不使它成为原生音频或视频生成模型。上下文窗口为 100 万和 50,000 token,最大输出 128,000。大上下文是容量,不是每个细节都会被正确记住的证明。
速度获得早期关注。Ruben Soto 发布了 Terra、Sol 和 Opus 的时间与成本对比,我们将其视为创作者报告而非自身基准。在据此下结论前,应检查所用材料的质量、指令、工具、完成标准和最终项目。快速但遗漏要求的尝试,与较慢但满足要求的尝试并不等价。
系统卡也值得一看。OpenAI 在其框架下将 Terra 的网络安全能力视为关键、生物和化学能力视为高。这些是能力评估,不是每个普通用途都危险的声明。文档还报告了提示注入、范围控制和误导性完成报告的测试。评估环境可能与你的产品不同。敏感工作流应保持狭窄范围,检查有后果的动作,并核对保存结果。
更换工作流前应做的对比测试
选择一个有已知答案的小型真实任务集,加入几个困难例外。给每个模型相同的起始文件和明确要求。记录确切的模型、努力等级、工具权限、成本和耗时。在不告知模型的情况下评分保存输出。
加入一次修改请求,而不只是第一次尝试。最后一步揭示助手是否足够理解项目以继续工作,而非仅产出有说服力的第一结果。
我的解读是:Terra 在可检查结果的重复视觉和计算机任务上值得关注;更难的推理和复杂编程仍应让 Sol 和 Astra 留在对比中;其他模型家族在各自擅长领域仍相关。不必强迫每个任务都过一个模型。从可验证的小型交接开始,保持升级路径,以审查后有多少有用工作存活来评判结果。
相关推荐

Heretic 2.0 发布:从去审查到通用模型修改工具
Heretic 2.0 正式发布,新增任意秩消融(ARA)算法与插件系统,从去审查专用工具进化为可抑制废话、降低谄媚、调整情感对齐的通用模型修改平台。37k GitHub 星标,Hugging Face 衍生模型超 8500 个。

本地大模型硬件怎么选?MacBook Pro vs Mac Mini+iPad深度对比
Reddit社区热议本地大模型硬件选择:32GB MacBook Pro与Mac Mini+iPad组合如何取舍?本文从便携性、性价比、内存需求等角度深度分析,帮你找到最适合本地推理的设备方案。

AI Agent失败溯源:如何定位错误决策的根因?
Reddit讨论聚焦AI Agent失败溯源难题:如何定位导致Agent做出错误决策的根因?分析LangSmith、LangFuse等可观测性工具的局限,探讨手动分析与自建分析系统的实践组合,为Agent可靠性提升提供思路。