Heretic 2.0 发布:从去审查到通用模型修改工具

Heretic 2.0 以任意秩消融和插件系统,将去审查工具升级为通用模型行为修改平台。
Heretic 2.0 在近五个月开发后发布,GitHub 星标达 37k、衍生模型超 8,500 个、累计下载 8,800 万次。其定位从去审查专用工具扩展为通用模型修改平台,可抑制废话、降低谄媚、调整情感对齐,去审查仍为默认功能。核心技术是以任意秩消融(ARA)取代经典方向性消融,放弃拒绝行为对应单一方向的秩 1 假设,通过目标函数编码期望属性并用 L-BFGS 逐个修改矩阵。架构上围绕插件系统彻底重构,评分器插件定义优化目标、修改器插件实现引导方法,内置 BERT 分类器评分器识别拒绝行为更准确。2.0 与 1.x 配置不向后兼容,并支持非交互式运行与端到端测试。
从去审查工具到通用模型修改平台
据 Reddit 社区消息,开源项目 Heretic 在历经近五个月开发后正式发布 2.0 版本。这个最初专注于移除语言模型审查机制的工具,如今已积累 37k GitHub 星标,Hugging Face 上衍生模型超过 8,500 个,累计模型下载量达到 8800 万次。Heretic 2.0 的定位发生了显著转变:它不再只是去审查的专用工具,而是进化为可以抑制模型“废话”(slop)、降低谄媚倾向、调整情感对齐的通用模型修改平台。
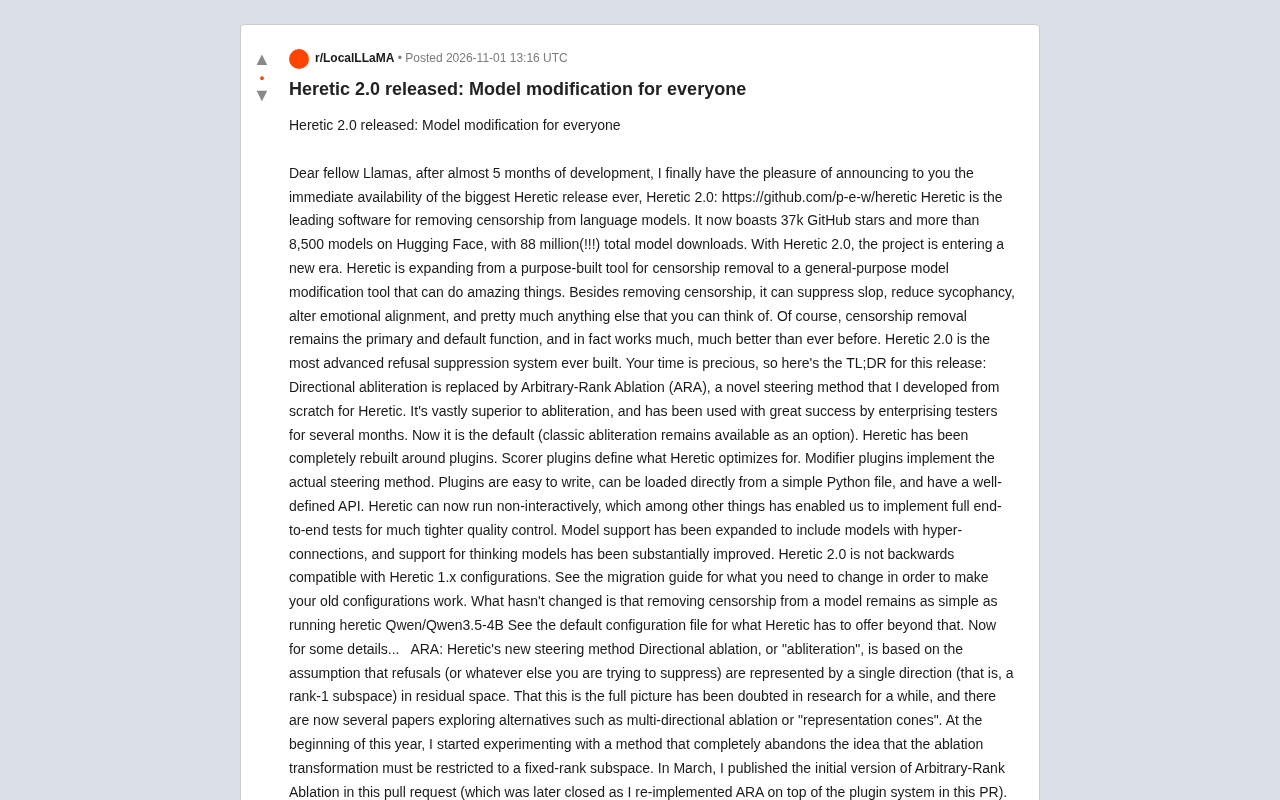
当然,去审查仍是默认且首要的功能。开发者称 2.0 是“迄今为止最先进的拒绝抑制系统”,且效果比以往版本好得多。使用门槛依然很低——运行 heretic Qwen/Qwen3.5-4B 即可完成一次基础的去审查操作。
核心技术:任意秩消融(ARA)取代方向性消融
Heretic 2.0 最核心的技术变化是用任意秩消融(Arbitrary-Rank Ablation,简称 ARA)取代了经典的方向性消融(abliteration)。传统 abliteration 基于一个假设:模型的拒绝行为在残差空间中表现为单一方向(即秩为 1 的子空间)。但这一假设近年受到研究质疑,多方向消融、表示锥等替代方案陆续出现。
开发者在今年初开始实验一种完全放弃固定秩限制的方法,并于三月发布 ARA 的初始版本。ARA 的核心思路是:通过目标函数编码期望的修改属性——有害提示在残差空间中的表示应接近无害提示,同时无害提示的表示变化应尽可能小——然后使用 L-BFGS 优化器逐个修改矩阵。这种“微训练”方式在不设秩限制的情况下引导模型表示。
据开发者介绍,ARA 在社区帮助下经过大量测试和调优。贡献者 kabachuha 使其兼容 Heretic 的 LoRA 系统,varunbln 则发现了显著的性能提升。目前 ARA 已成为默认方法,经典 abliteration 仍作为可选项保留。
方向性消融(abliteration) 是一种基于权重编辑的模型行为修改技术,最早由社区在 2023 年前后提出。其基本思路是:先构造一组有害提示与无害提示,提取模型在中间层残差流中对应的激活表示,计算两组表示均值之差作为“拒绝方向”,然后从模型的权重矩阵中减去该方向上的投影分量。由于只需一次前向计算和简单的线性代数操作,abliteration 成本极低,一度成为开源社区去审查的主流手段。
残差流与秩的直觉:在 Transformer 中,每一层的输出都会加回一条贯穿所有层的向量通道,即残差流。不同语义特征在残差空间中近似对应不同的方向,若某类行为(如拒绝)只由一个方向控制,则称其秩为 1。多方向消融的动机在于:拒绝行为可能分布在多个正交或近正交的方向上,仅移除单一方向会残留部分拒绝倾向,或过度损伤其他能力。ARA 放弃预先指定秩,而是让优化器自行决定在哪些方向上、以多大强度修改矩阵。
L-BFGS 优化器:Limited-memory Broyden–Fletcher–Goldfarb–Shanno 是一种拟牛顿法,利用最近若干步的梯度差近似 Hessian 矩阵的逆,从而在不需要存储完整二阶矩阵的情况下获得比朴素梯度下降更快的收敛速度。在 ARA 中,待优化变量是模型中各权重矩阵的修改量,维度可达数百万甚至数十亿,L-BFGS 的低内存特性使其成为可行选择。目标函数同时约束“有害提示表示靠近无害提示”和“无害提示表示尽量不变”,后者即 KL 散度正则项的作用,用以防止模型整体分布漂移。
插件系统:让 Heretic 按你的目标优化
Heretic 2.0 围绕插件系统进行了彻底重构。Heretic 的工作原理是寻找能优化评分的修改参数——1.0 版本以来一直使用两个硬编码评分:衡量去审查强度的拒绝计数和衡量质量保留的 KL 散度。2.0 则允许用户通过编写评分器插件自由定义评分标准,可以同时加载任意多个评分器并分别设置最小化或最大化。
评分插件系统由贡献者 red40maxxer 主导设计,开发者与其交换了数百条消息、经历数十轮评审才最终敲定。除默认的关键词计数和 KLD 评分器外,Heretic 还内置了基准测试评分器和 BERT 分类器。后者由长期贡献者 Vinay Umrethe 开发,可使用任意 ModernBERT 类型模型对 LLM 响应进行分类并评分。Vinay 还训练了一个拒绝分类器模型,实验表明其在识别模型拒绝行为上比默认的关键词匹配方法准确得多。虽然速度较慢,但更高的准确度有助于生成质量更好的修改模型。仓库中还提供了使用情感分类器的替代配置。
修改器插件则负责实现实际的引导方法,同样可以通过简单的 Python 文件加载,并配有明确定义的 API。
KL 散度(Kullback–Leibler divergence) 在这里用于衡量修改前后模型输出分布的差异。具体做法通常是:用原始模型和修改后模型分别对同一批无害文本计算下一个 token 的概率分布,再求两个分布之间的 KL 散度并取平均。KL 值越小,说明修改对模型原有能力的扰动越小。Heretic 将其作为质量保留评分,与拒绝计数评分共同构成优化目标,从而在“去审查强度”和“模型质量”之间寻找帕累托权衡。
BERT 分类器评分器:ModernBERT 是 2024 年底发布的一类编码器模型,支持长上下文并采用现代架构改进。Heretic 允许加载任意 ModernBERT 类型模型作为评分器,对模型响应做二分类(如拒绝/非拒绝)并输出概率作为分数。相比关键词匹配,分类器能识别“我无法协助”之外的隐式拒绝表达,代价是需要额外的推理时间,因此在大规模搜索中会显著拖慢优化过程。
工程改进与迁移注意事项
除核心算法和架构变化外,Heretic 2.0 还带来多项工程层面的提升。它现在可以非交互式运行,这使得端到端测试得以实现,质量控制更加严格。模型支持范围扩展到具有超连接(hyper-connections)的模型,对思考模型(thinking models)的支持也有实质性改进。
需要留意的是,Heretic 2.0 与 1.x 版本的配置不向后兼容。升级用户需要参照迁移指南调整旧配置文件。开发者表示,插件系统的文档在 README 和代码中都有完善说明;如果用户想实验自定义插件,一个智能体在消化 Heretic 仓库后应能轻松编写出插件及配套配置文件。
社区驱动的开源协作样本
Heretic 从 1.0 到 2.0 的演进过程本身就是一个值得关注的开源协作案例。核心算法 ARA 由项目发起人从零开发,插件架构由社区贡献者主导设计,LoRA 兼容性和性能优化来自其他贡献者,拒绝分类器模型则由另一位长期参与者训练。多个独立来源的贡献共同塑造了 2.0 的面貌,也解释了为何这个项目能在不到两年时间里积累起可观的社区规模。
对于关注模型行为修改、对齐调整和开源工具链的开发者而言,Heretic 2.0 提供了一个低门槛的 experimentation 平台。其插件化设计意味着去审查只是众多可能应用之一,模型行为的定制化修改正在变得更加平民化。
相关推荐

Cloudflare开源AI代码安全审计工具,获6万星
Cloudflare开源Security Audit,为AI编码Agent提供免费安全审计。三步工作流:应用测绘、多Agent对抗找Bug、三级分类报告,源自内部漏洞狩猎系统,近6万星标。

GPT-6 Astra读权重绝技:仅限小网络,实用靠写代码
GPT-6 Astra能直接读网络权重,但无工具设置仅限约17万权重的小网络。修复QUEN 3.5 0.8b推理循环靠写Python和50批练习,实测识别游戏耗时近一小时。本文梳理能力边界与两个安全提醒。

GPT-6 Astra 改写 Qwen 权重:7.9% 到 48.1%,是学会了数学还是学会了停?
MIT研究者用GPT-6 Astra直接编辑Qwen权重,数学得分从7.9%升至48.1%,全程无训练。但独立复现显示,提升主要来自修复循环、让模型学会终止作答,而非新增数学能力。