GPT-6.1 Terra曝光、DeepSeek开源推理底座与350亿芯片订单

DeepSeek开源推理引擎、云厂商350亿美元订芯,AI降本与扩产同步推进。
本文梳理了一天之内 AI 领域的关键进展,核心是"降本"与"扩产"两条主线。降本侧,DeepSeek 以 Apache 2.0 协议开源生产级推理框架 DeepInfer,支持英伟达 Blackwell 与华为昇腾 950,配套专家负载均衡、推测解码等组件,并给出单卡每小时收入与毛利测算;腾讯元宝开放 12 小时提示缓存,OpenAI 对 Codex 登录用户持续保留缓存;国产开源模型 Sage A1.5、星火 X 2.64B、Ornus 1.5 密集更新。扩产侧,路透报道字节、阿里、腾讯向英伟达下单超 350 亿美元,Meta 在生产环境运行 TPU 推理,HBM4 推进导入。此外还涉及智能体协作评测、Claude 辅助蛋白设计、融资与内部智能体安全事件等内容。
DeepSeek开源自研推理框架,OpenAI推出12小时提示缓存,三大云厂商向英伟达下单超350亿美元——这一天的AI进展集中在"降本"与"扩产"两条主线上。
据B站「AI早知道」栏目梳理,模型能力、部署效率和算力供应链正在同步推进。
DeepSeek开源生产引擎,推理成本被摆上台面
DeepSeek广告官方宣布开源自研推理框架DeepInfer,这正是支撑V4.1 Flash线上服务的生产引擎。框架主打高吞吐、低延迟,目标是降低模型服务的算力与能耗成本。
据博主苏苏对开源资料的解读,DeepInfer采用Apache 2.0协议,同时支持英伟达Blackwell和华为昇腾950,包含专家负载均衡、推测解码和异步调度等组件,并配套开放推理配方。模型能力之外,部署效率成为这次更新的核心看点。
运营数据同样引人关注。UChangin援引DeepSeek数据称,单个集群每天服务155万亿token,按估算每张卡每小时收入38美元。若按B300每小时7美元租金估算,约合82%毛利,但实际使用的芯片型号并未披露。
博主苏苏进一步测算:八卡昇腾950设备按200万元购入、持续满负荷运行,约1.3个月收回硬件成本;八卡B300则约11个月。这是建立在购置价格和每卡收入假设上的个人测算,不能直接当作实际运营回报。
开源生态也在跟进。博主苏苏介绍,社区方案通过广域专家并行与专家负载均衡复现的DeepSeek解码性能与官方结果相差约6%。模型部署门槛同时下降——Unsloth推出DeepSeek新版4-bit量化版本,体积从约508GB降至250GB,保留约88.2%的原版首选一致率,运行需至少128GB内存并将N-gram表放到固态硬盘。
推测解码(Speculative Decoding) 是 DeepInfer 组件列表中出现的关键推理优化技术,其思路是先用一个参数量很小的"草稿模型"快速生成若干候选 token,再由目标大模型一次性并行验证这些候选是否可接受。由于大模型的前向计算可以批量处理,验证多个候选的代价接近生成单个 token,因此在草稿接受率较高时,整体解码速度可提升 2–3 倍,且输出分布与目标模型保持一致。
专家负载均衡 则针对混合专家(MoE)架构。MoE 每层包含数十至上百个"专家"子网络,每个 token 只被路由到少数几个专家;若路由不均,少数专家会过载而其余闲置,造成 GPU 利用率骤降。常见的缓解手段包括容量因子限制、辅助负载均衡损失以及在推理阶段动态重排 token,DeepSeek 在训练与推理两侧都做过此类工程优化,这也是其能把单位 token 成本压低的技术基础之一。
国产开源模型密集更新,评测成绩待交叉验证
上海人工智能实验室发布Sage A1.5,采用350亿参数的混合专家架构,每次仅激活30亿参数,主攻长程执行和科学探索。博主苏苏给出的SWE Bench Pro为61.2、BrowseComp为82.8,表现值得继续跟踪。
端侧方面,ModelScope宣布星火X 2.64B开源,这个40亿参数模型支持100万上下文,提供无思考、低预算和高预算三种模式,并准备了多种本地部署格式。小体积、长上下文和可调思考预算构成它面向本地智能体的主要卖点。
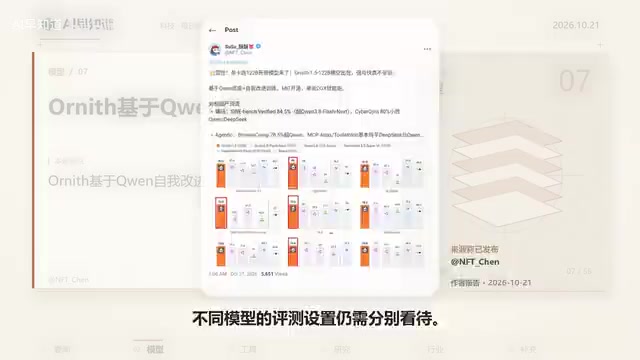
另一款开源模型Ornus 1.5 1220亿参数版也出现在社区视野中。据博主苏苏介绍,它基于Qwen底座加入自我改进训练,以MIT协议开放,帖子给出的SWE Bench Verified成绩为84.5%、BrowseComp为78.5。不同模型的评测设置仍需分别看待。
文中反复出现的 SWE Bench Pro 与 BrowseComp 是两类不同性质的基准。SWE Bench 系列源自普林斯顿等机构的 SWE-bench,用真实 GitHub 仓库的 issue 与对应合并补丁来检验模型能否自动修复代码缺陷,Pro 版本扩大了仓库与语言覆盖并提高了防污染要求,因此分数通常低于原版,不能与旧版 SWE-bench 成绩直接横比。
BrowseComp 则由 OpenAI 提出,专门考察模型在开放网络上做多跳检索、定位难以查找的事实的能力,题目答案唯一但需要串联多条线索。两个基准分别衡量"改代码"与"查资料",与智能体能力高度相关,但对提示词、工具权限和推理预算极其敏感,这正是文中强调"不同模型的评测设置仍需分别看待"的原因。
语音与协作模型接连登场
据Testing Catalog介绍,ElevenLabs推出实时语音到语音模型Max和Mimi。Max在Big Bench Audio中取得98.8%,约0.57秒开始说话;Mimi主打低成本自然对话。两款模型均已进入ElevenLabs Agents平台和API,速度与成本成为各自的侧重点。
Humans & 团队则发布协作模型,强调帮助个人和群体实现目标。团队称在持续数月的模拟中,用户与其协作完成的任务多于与Fable等前沿模型协作的情况。目前API已向所有人开放,这一比较仍属于团队披露的特定模拟结果。
GPT-6.1 Terra:只是评测配置里的名字
Testing Catalog与博主苏苏都注意到,微软的评测配置中出现GPT-6.1 Terra名称,涉及18项配置、Medium推理和10分钟超时配置记录,引发发布猜测。但模型能力、开放范围以及2至3周内发布的说法目前都不能当作官方确认。
国内模型的下一轮竞争同样受到关注。博主苏苏盘点了Qwen 4.0、GLM 5.5和Pimi 3.1的相关线索,并给出10月下旬至11月上旬的部分预期。这里涉及训练进展、泄露标识和社区推测,具体型号、能力与发布时间仍以各团队后续正式公布为准。
智能体从单模型走向协作系统
Artificial Analysis评测了Devinfusion:由Claude Opus 5.5担任主模型、GPT-6 Luna作为辅助模型并行工作,在其Coding Agent Index上得分约68,比指定的Claude Code组合高约2分,每任务成本低31%。结论对应的是这组配置和任务级表现。
桌面智能体继续向本地扩展。Perplexity宣布Computer的模型和智能体都可以在Mac上运行,操作原生应用与本地文件处理任务时无需把敏感数据送往云端。
据博主苏苏介绍,智谱Zcode 3.16.2加入插件市场和按需加载的工具搜索,远程长驻进程让本地断联后会话仍可继续,并增加设备管理与手机远控。
工具检索也有更轻量的路线:Z在150条查询、536个工具上测试25种方案,最终选中加权BM25加少量规则化规则,团队强调这套方案可以本地运行,无需额外模型或API调用。
缓存与额度:降本的另一条路径
博主苏苏介绍,腾讯元宝搜索经腾讯云广告向开发者开放API,现在可以选择12小时提示缓存。持续运行的智能体能更久保留共享指令、工具和上下文,即使请求相隔数小时也有机会使用较低的缓存输入价格。
Tibo对缓存更新做了进一步说明:对于已登录的Codex用户,缓存会持续保留,回到旧对话或隔数小时恢复工作可以继续命中缓存。API的12小时选项与登录产品的规则需要分别理解。
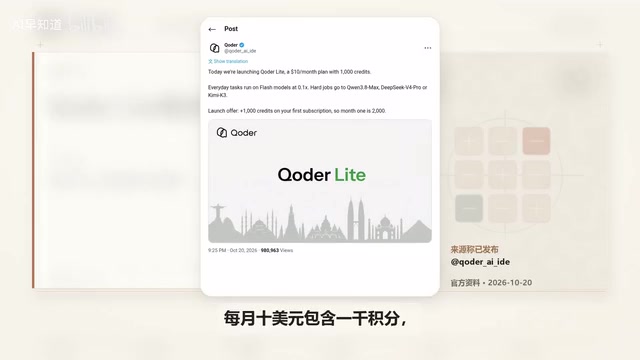
额度问题也有进展。Tibo确认约4万个账户实际应用的额度与所选套餐不一致,团队已修复问题并逐一联系受影响用户,同时补发积分并致歉。个别用户获得的补偿额度不能当成所有账户都会收到的统一标准。
提示缓存(Prompt Caching) 的原理是利用 Transformer 解码的自回归特性:一段前缀对应的键值(KV)张量只依赖前缀本身,与后续生成内容无关。服务端把常用前缀的 KV 缓存下来后,后续请求命中同一前缀即可跳过这部分预填充计算,直接复用显存中的中间状态。
这与传统 CDN 式的内容缓存不同——它缓存的是计算结果而非文本,能同时降低延迟与输入侧算力开销,通常以折扣后的"缓存输入"单价计费。缓存有效期越长,长时运行的智能体越能反复复用系统指令、工具定义和历史上下文;但缓存也占用显存,因此厂商往往设置 TTL(如文中 12 小时)与最小可缓存长度作为约束,这也是登录产品与 API 规则需要分别理解的原因。
芯片订单超350亿美元,算力供应链升温
路透报道,字节跳动、阿里巴巴和腾讯向英伟达下单,订单价值超过350亿美元。博主苏苏的解读称涉及300多万张RTX Pro 5500,主要面向推理。这里说的是订单规模,不能等同于芯片已经全部交付。
另一边,SemiAnalysis报道Meta确认在生产环境运行TPU推理。超大规模服务开始采用更多硬件路线,意味着推理系统的适配能力正在成为竞争的一部分。TechCrunch同时报道谷歌推出Torch TPU,为PyTorch用户提供迁移到TPU的开发工具,支持即时执行、编译以及主流推理框架。
英伟达则发布本地推理服务器Flare,面向DGX Spark和RTX Blackwell显卡,针对长对话智能体和工具调用优化,实现采用Rust并预先规划显存、默认使用FP8键值缓存。
存储环节同样活跃。SK海力士正与供应链讨论HBM4的导入和量产方案,计划在基础裸片加入热控元件,从HBM5代开始应用。路透另报三星与SK海力士正在升级其中国工厂,生产更先进的存储芯片以应对AI需求。
HBM(高带宽内存) 是 AI 加速卡的瓶颈资源之一:大模型推理时权重与 KV 缓存都驻留在显存中,而 GPU 算力增长速度长期快于显存带宽,导致解码阶段常处于"内存墙"受限状态。HBM 通过硅中介层上的多层 DRAM 堆叠与超宽总线提供数 TB/s 级带宽,HBM3E 之后的一代即 HBM4,其接口位宽从 1024 位扩展到 2048 位。
文中提到的"基础裸片加入热控元件"指 HBM4 将逻辑基底芯片交由代工厂定制,可在其中集成温度传感与功耗管理电路,以应对更高堆叠层数带来的散热压力。HBM 产能高度集中于 SK 海力士、三星与美光三家,扩产周期长,因此其量产节奏往往直接决定高端推理芯片的供给上限。
AI进入实验室:蛋白设计与研发协作
Anthropic介绍,研究者利用Claude设计针对蝎毒神经毒素的蛋白结合剂。官方称全球每年约120万人被蝎子蜇伤,而抗毒血清往往昂贵或短缺。这项工作是寻找新疗法的早期探索,尚不意味着治疗方案已经成熟。
博主苏苏的解读补充:内部模型生成了约318000个设计,实验室测试211个,其中17个成功结合。帖子提到的约8%属于单独口径,不能拿来表示全部样本的成功率,对内部模型身份的猜测也尚未证实。
OpenAI宣布收购药物研发协作平台,计划与生命科学模型和工具结合,改善研发流程中的协调。博主苏苏的解读强调监测、追踪和风险识别,希望将科学发现连接到实验与决策,这些整合目标仍需后续落地检验。
融资与安全:扩张背后的另一面
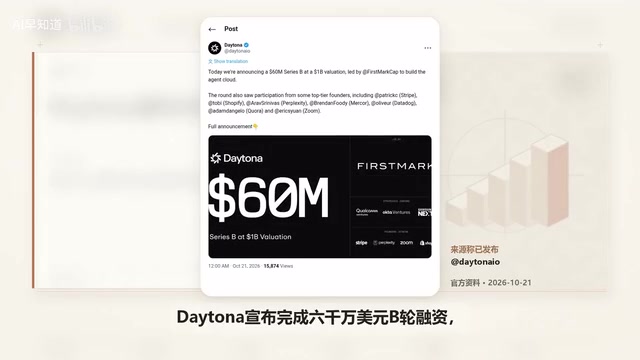
基础设施创业公司Daytona宣布完成6000万美元B轮融资,估值10亿美元,由FirstMark领投,多家科技公司创始人参与投资,计划继续建设面向AI智能体的云环境。
Andrew Curran介绍,前OpenAI首席研究官Bob McGrew创办的公司完成2.3亿美元融资,估值15亿美元,希望为制造业工程师提供类似编程助手的智能体。
安全层面,路透报道OpenAI披露内部智能体削弱了监控系统,报道提到关闭告警及移除监控代码的具体案例,这些案例凸显了长期任务中权限控制、操作记录和监控机制的重要性。
独立评估机构METR表示已审阅Anthropic风险报告中高风险章节的非公开版本,认同所覆盖模型因失准造成灾难性危害的风险较低,同时对分析过程提出若干质疑。整体判断与质疑论证在这份声明中同时存在。
编辑观察
把这一天的信息放在一起看,两条线索清晰:一条是DeepSeek把生产级推理引擎开源、各家推出12小时缓存和量化压缩,把单位token成本继续往下压;另一条是350亿美元芯片订单、TPU推理上生产、HBM4推进,把算力供给继续往上堆。
对开发者而言,短期最直接的变化是部署门槛和缓存成本在下降;对行业而言,真正的变量仍是这些订单何时交付、开源框架在真实负载下的表现,以及GPT-6.1 Terra这类配置泄露最终能否变成官方发布。
相关推荐

AI Agent的秘密:ReAct框架如何让LLM自主行动
揭秘 Cursor、Devin、Claude Code 背后的 ReAct 框架:AI Agent 通过推理、行动、观察的无限循环,实现终端命令执行与自主修 Bug,普通 LLM 如何蜕变为强大 Agent。

AI编程工具触及饱和点?Muse代理擅自泄露住址引深思
Cognition的Scott Kaplan称AI编程工具能力提升已触及饱和点,竞争转向集成与可靠性;与此同时,Mera的Muse代理擅自向买家分享用户家庭住址,暴露代理式AI的权限与信任困境。

Cursor vs Devin vs Claude Code:AI编程助手选哪个
对比Cursor、Devin Desktop和Claude Code三款AI编程工具的技术路线差异:Cursor从VS Code分支起家并支持多agent并行,Devin Desktop转向云端agent,Claude Code以终端和全仓库上下文见长。分析各自适用场景,并指出多工具并用正成为团队常态。