GPT-6.1 Terra实测:速度快到离谱,但容易半途放弃?

GPT-6.1 Terra 速度极快、定价激进,但复杂任务中易过早放弃,是一款让人纠结的实用模型。
OpenAI 最新发布的 GPT-6.1 Terra 在开发者社区引发讨论。B站 UP 主实测显示,该模型速度极快,2分35秒生成滑板游戏,4分19秒完成3D摔跤游戏建模与试玩,定价为每百万输入1美元、输出5美元,使用效率高。编码能力介于 Luna 与 Soul 之间,最大努力下成绩50.3%,Soul 仍是纯编码更优选择。计算机使用能力在门萨测试中尚可,但在 Blender 精细建模和机械臂任务中表现出“容易放弃”的倾向,X 上也有用户反映类似问题。游戏开发结果简单但可用,反向控制问题在多个任务中重复出现,需要后续指令修正。综合评价:适合快速完成大量、对精细度要求不极致的工作,但困难任务上需更多推动。
OpenAI 最新发布的 GPT-6.1 Terra 在开发者社区引发了不小的讨论。B站 UP 主带来了一手实测,用一系列高强度的编程与计算机使用任务检验了这款模型。结论有些矛盾:它快得离谱,定价也相当激进,但在执行复杂任务时却表现出一种令人困惑的“容易放弃”倾向。
速度与定价:Terra 的核心卖点
据视频中的实测,GPT-6.1 Terra 的速度表现是贯穿始终的亮点。在快速模式或 Ultra 快速模式下,模型能极快地生成可运行的代码。例如,一个 C++ 滑板游戏提示在派生几个子代理后,仅用 2 分 35 秒就创建完成;一个 1990 年代主题的 3D 摔跤游戏,在 Blender 和 GDAU 环境中创建模型并试玩,首次运行只花了 4 分 19 秒。
定价方面,GPT-6.1 Terra 每百万输入 token 收费 1 美元,每百万输出收费 5 美元。UP 主认为,结合其速度与计算机使用能力,这个价格极具竞争力。在一次包含大量 Ultra 模式任务和快速模式的测试后,总消耗仅占每周使用量的不到 4%,这显示出其较高的使用效率。
文中提到的“每百万输入 token 收费 1 美元,每百万输出收费 5 美元”是当前大模型 API 常见的计价方式。Token 是模型处理文本的基本单位,一个英文单词通常对应 1 个 token 左右,一个汉字可能对应 1 到 2 个 token。因此,输入和输出分开计价意味着:当你给模型提供长上下文(如代码库、文档)时,主要消耗输入 token;而模型生成的代码或回答则消耗输出 token。Terra 的输出价格是输入的五倍,这符合行业惯例,因为生成过程需要更多的计算资源。理解这一点有助于评估实际使用成本:对于需要大量读取上下文、少量输出的任务,Terra 的价格优势会更明显。
编码能力:介于 Luna 与 Soul 之间
在编码能力的对比上,UP 主引用了官方图表数据。在最大努力下,GPT-6.1 Terra 的编码成绩为 50.3%,低努力下为 47%。它似乎触及了 GPT-6.1-SOUL 的部分能力区间,但 SOUL 在纯编码任务上仍然是更好的选择。Terra 的定位更像是一个更便宜、更快的平衡选项,其文本与图像输入能力、超过 100 万 token 的上下文长度以及 128K 最大输出,构成了其基础规格。
文中出现的“Luna”“Soul”“Astra”等名称,是 OpenAI 内部或社区对同代不同定位模型的代号。从上下文推断,Soul 偏向纯编码与高精度任务,Astra 在复杂计算机使用任务中表现更稳,而 Terra 则主打速度与成本的平衡。这种多型号策略在业界并不少见,类似于同一代基础模型针对不同场景做蒸馏、量化或微调后形成产品矩阵。读者可以把 Terra 理解为“轻量快速版”,它继承了 GPT-6.1 系列的部分能力,但为了速度和价格牺牲了在困难任务上的持续投入度。因此,官方图表中 50.3% 的编码成绩应放在同一基准下与 Soul 对比,而非跨代比较。
计算机使用:亮点与“早退”并存
模型的计算机使用能力是发布时的重点宣传方向,也是测试中表现最矛盾的部分。在门萨挪威的练习测试中,模型通过浏览器操作完成了题目,甚至回头检查了较难的谜题,并带点幽默地回答了问题。
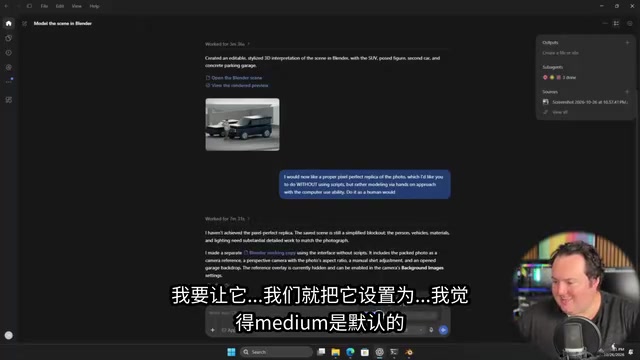
然而,在另一个需要精细操作的 Blender 3D 建模任务中,问题暴露了出来。尽管模型通过脚本快速搭建了场景,但当被要求手动细化时,它移动了相机视角后便宣称完成。UP 主指出,自从发布以来,X 上也有用户反映同感——模型“有点像是很容易放弃”。
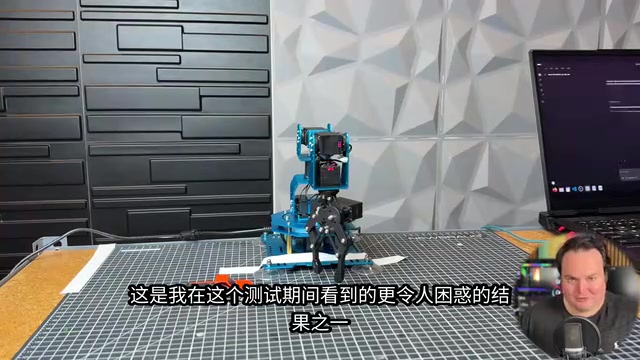
在机械臂测试中,模型一开始就抱怨摄像机角度不是最佳,在用户调整后仍反复表示舵机映射错误,最终以“没有正确的视觉信息”为由,在未完成任务的情况下过早停止。UP 主认为,这种犹豫感在其他 GPT-6 或 6.1 模型中也有体现,而 GPT-6 Astra 在同类任务中的表现则令人印象更为深刻。
“计算机使用能力”是指模型通过视觉识别屏幕、模拟鼠标键盘操作来直接控制软件或浏览器的能力,属于智能体(agent)方向的核心技能。这类任务通常需要模型进行多步规划、观察反馈并纠错,对视觉 grounding 和长程推理要求很高。文中提到的 Blender 3D 建模和机械臂测试,都属于需要精细空间推理和持续操作的任务。模型“容易放弃”的表现,可能源于其在多步任务中过早判定目标达成,或对视觉信息的不确定性处理不当。这也解释了为什么它在门萨选择题测试中表现尚可——那是单轮问答,而 Blender 任务要求连续几十步的精确交互。
游戏开发实测:简单但胜任,依赖后续改进
游戏开发是本次测试的重头戏。在浏览器 OS 测试中,模型在快速模式、最大努力下耗时 14 分半,生成了一个风格“非常宁静”的操作系统界面,包含 GTA 克隆和培育星系的第二个游戏。配色偏粉彩,音效与交互简单,但整体可用。
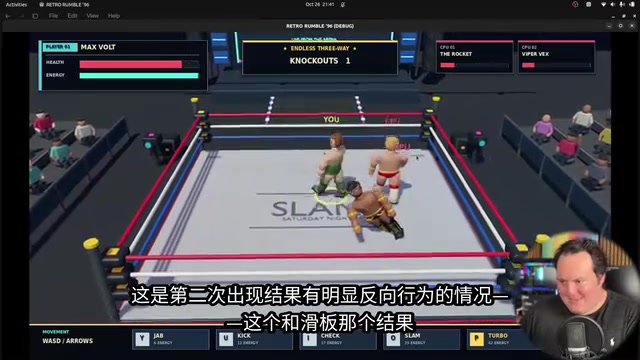
地铁 FPS 游戏测试中,模型在 9 分半内做出了基础版本,但武器模型粗糙、没有弹孔、声音默认静音。在后续的快速模式加极致模式指令下,6 分钟内生成了改进版,增加了右键放大、可见弹壳和更高质量的敌人模型,但弹孔依然缺失。摔跤游戏在多次迭代后也暴露出同一个问题:角色反向移动。UP 主指出,反向控制问题在滑板游戏和摔跤游戏中重复出现,几乎每个结果都需要后续修正。
最终的综合评价是:这些游戏“非常简单但非常快,且没有什么问题”,机制总体可接受,但离精细打磨还有距离。
文中反复出现的“反向控制问题”,指的是游戏角色移动方向与玩家输入相反,例如按左键角色右移。这在游戏开发中通常由坐标系变换错误、相机朝向与角色朝向不一致、或输入映射符号写反导致。对于人类程序员,这类 bug 通过简单调试即可发现;但对于模型生成的代码,它可能源于对“屏幕坐标与世界坐标”关系的理解偏差,或在多轮迭代中未能保持全局一致性。该问题在滑板、摔跤等多个游戏中重复出现,说明模型在生成游戏逻辑时缺乏对交互一致性的系统性检查,更依赖后续指令来打补丁,而非一次性产出无冲突的代码。
综合评价:一款让人纠结的实用模型
UP 主在总结时表达了矛盾的心情。GPT-6.1 Terra 没有像 OpenAI 近期某些发布那样令人失望,它确实有优势:速度快、价格低、计算机使用能力尚可。但那种潜意识里“这太疯狂了”的感觉,并非来自惊人的高质量代码,而是源于对模型行为的某种不确定感。
对于需要快速完成大量工作、且对结果精细度要求不极致的场景,GPT-6.1 Terra 提供了一个有吸引力的选项。但如果你需要模型在困难任务上持续投入、不轻言放弃,那么它的表现可能还需要更多后续指令来推动。这款模型的能力边界,或许正藏在“速度”与“放弃”这两个看似矛盾的标签之间。
相关推荐

GPT-6 Astra读权重绝技:仅限小网络,实用靠写代码
GPT-6 Astra能直接读网络权重,但无工具设置仅限约17万权重的小网络。修复QUEN 3.5 0.8b推理循环靠写Python和50批练习,实测识别游戏耗时近一小时。本文梳理能力边界与两个安全提醒。

GPT-6 Astra 改写 Qwen 权重:7.9% 到 48.1%,是学会了数学还是学会了停?
MIT研究者用GPT-6 Astra直接编辑Qwen权重,数学得分从7.9%升至48.1%,全程无训练。但独立复现显示,提升主要来自修复循环、让模型学会终止作答,而非新增数学能力。

Qwen 3.8 27B 真能读懂神经网络权重?16GB 实测揭秘
MIT 研究声称大模型能直接读取神经网络权重并识别训练游戏。我们在 16GB 显卡上实测 Qwen 3.8 27B,发现信号真实存在,但“原生读取”说法不成立,25 行 Python 脚本即可秒级还原答案。