GPT-6.1 Terra实测:一句话建站,速度与成本如何取舍
实测 GPT-6.1 Terra:一句话可建站,但商用仍需人工复核,成本结构待观察。
文章通过一位 YouTube 创作者的一手测试,评估 OpenAI GPT-6.1 Terra 对普通用户的实用价值。测试中,一句提示词即生成了虚构咖啡店 North Star Coffee 的可交互网站原型,含菜单、营业时间、位置与移动导航,但商用前仍需检查文案、链接与布局。OpenAI 重点宣传的 computer use 能力与 Agents Last Exam 基准(57.6% 对 42.6%)显示进步,但官方也承认最复杂编程任务仍应交给 Sol 或 Astra。第三方对比显示 Terra 更快更便宜,但结果可能需要多跑几遍;创作者在视频项目中额度消耗远超预期,最终改用 Luna 6。结论是按任务分配模型,账单与返工次数比基准分数更能决定其价值。
OpenAI 在介绍 GPT-6.1 Terra 时用了一段动画地球,但真正值得关注的问题很朴素:对一个只想把活干完的普通用户来说,这个模型到底能带来什么?一位 YouTube 创作者做了个直接测试——给 Terra 一句提示词,让它从零搭建一个虚构咖啡店的网站,并把整个过程和感受放进了视频。
一句话建站:North Star Coffee 实测
测试设定很具体:虚构的社区咖啡店 North Star Coffee,需要欢迎主页、带示例价格的菜单、营业时间、位置信息,以及可用的移动端导航。创作者只给了一句提示词,Terra 通过 ChatGPT Work Insights 完成了设计、菜单和到店信息,并生成了一个可以直接交互的预览页面。移动端菜单也做了检查。
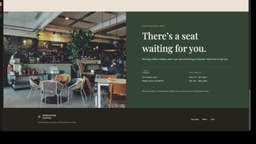
创作者的第一印象是:对单条提示词而言,这是一个有用的起点,尤其对非开发者友好。但他也明确提醒,真正用于商业站点前仍需检查文案、链接和布局并做修改。这个判断很关键——一句话建站的价值不在于直接交付成品,而在于把"想法"到"能看到、能点击的东西"之间的时间压缩了。
计算机使用能力与基准成绩
OpenAI 在这次发布中重点强调的是 computer use:模型能观察屏幕内容并与软件交互,包括点击按钮、填写表单、跨应用推进任务。你给一个目标,它自己规划步骤去完成。
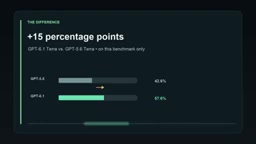
支撑这一点的是一项名为 Agents Last Exam 的基准测试,考察智能体在专业任务上的表现。据 OpenAI 公布的数据,在中等推理强度下,GPT-6.1 Terra 得分 57.6%,GPT-5.6 Terra 为 42.6%,提升了 15 个百分点。
需要看清的是,这是 OpenAI 自己报告的全局性结果,不代表 Terra 在所有场景都更强。OpenAI 同时表示,在最复杂的编程任务上,GPT-6.1 Sol 或 GPT-6 Astra 仍是更好的选择。
Computer use(计算机使用) 是当前智能体模型的一类核心能力:模型通过视觉理解屏幕截图,并输出鼠标点击、键盘输入、滚动等操作,像人一样在图形界面中完成任务。与调用 API 或生成代码不同,computer use 不要求目标软件提供接口,因此适用范围更广,但也更容易因界面变化、弹窗干扰或渲染延迟而出错,通常需要更长的步骤规划和容错机制。OpenAI 在本次发布中把它作为重点,意味着模型的能力边界从“生成内容”延伸到了“操作软件”。
Agents Last Exam 是一个面向智能体的评测基准,名称呼应“人类最后的考试”(Humanity's Last Exam),但考察对象是智能体在专业、多步骤任务中的实际完成能力,而非单轮问答。这类基准通常包含跨应用操作、信息检索与整合、长流程规划等任务,评分依据最终结果是否正确交付。需要注意的是,基准分数反映的是特定任务集上的平均表现,与真实工作流的复杂度和容错要求仍有差距,厂商自报数据尤其应结合第三方复现来看。
第三方对比:快和便宜,但要多跑几遍
在 X 上,Ruben Soto 分享了他对 Sol 和 Claude Opus 的早期对比。在他的那次测试中,Terra 的运行明显更快、成本更低,但他也提到 Terra 的结果"可能还需要再跑几遍"。创作者的回应很实在:快是有用的,但结果得真的能交差。
这正好点出了当前智能体模型的一个共性张力——速度与成本优势往往伴随着需要人工复核和多次迭代。
视频制作中的真实消耗
比起基准分数,创作者在视频制作环节的体验更有参考价值。他用 GPT-6.1 Terra 制作了这条视频,但消耗使用额度的速度远超预期。在一次额度重置后,他改用 Luna 6 的 extra high 档位完成剪辑。按他的说法,Luna 6 在 extra high 下比低推理强度的 Terra 6.1 效果更好,成本也低得多,他打算以后固定用这个组合。
另外,视频里的动画是经过多次迭代才调好的;在类似项目上,Claude Sonnet 给过他更好的结果。这些都是一手使用感受,样本单一,但揭示了官方基准之外的真实成本结构。
推理强度(reasoning effort) 是 OpenAI 模型提供的一档可调参数,通常分为低、中、高、extra high 等等级,决定模型在回答前进行多少内部推理计算。档位越高,模型在复杂任务上的表现通常越好,但消耗的 token 与使用额度也越多、响应越慢。文中创作者提到“低推理强度的 Terra 6.1”与“Luna 6 的 extra high 档位”,正是在比较不同模型与推理强度的组合在效果与成本上的取舍。
可用范围与实用判断
根据 OpenAI 的发布说明,Plus、Pro、Enterprise 和 Edu 用户可以在 ChatGPT Work 和 Codex 中访问 Terra。对非开发者而言,一句话生成可交互原型的能力确实降低了起点门槛;但如果目标是生产环境,内容审核、链接检查、布局调整这些人工环节一个都省不掉。
比较务实的策略是按任务分配模型:复杂编程交给 Sol 或 Astra,成本敏感、需要大量迭代的任务考虑更低成本的档位,Terra 则适合快速出原型的场景。基准分数说明趋势,但账单和返工次数才决定它是否值得留在工作流里。
相关推荐
从零构建MCP服务器:让AI应用调用你的Agent工具
手把手教你从零构建MCP服务器,让Claude Desktop等AI应用调用你的Agent工具。涵盖协议版本协商、工具发现与调用、错误处理及测试验证,基于YouTube教程实战。
在Claude和Cursor中验证邮箱:Email Verification MCP实战
如何在Claude和Cursor中通过MCP接入邮箱验证工具,让AI代理在发送外联邮件前自动检查地址。包含Claude Desktop配置步骤、Cursor批量清洗线索名单的实战演示,以及catch-all地址为何不能当作安全信号的分析。
提示注入如何让GitHub Issue劫持AI代理
安全研究者演示提示注入攻击:攻击者将恶意指令藏在公开GitHub Issue中,诱导AI代理从私有仓库窃取薪资并公开泄露。本文解析攻击原理,并给出最小权限、不可信输入、人工审批三层防御策略。