GPT-6.2 Astra演示泄漏,谷歌Gemini 4新模型线索浮现

GPT-6.2 Astra 演示与基准泄漏显示能力跃升,但安全对齐延迟与谷歌、腾讯的效率竞赛同步升温。
文章梳理了近期 AI 模型竞赛的多条线索。OpenAI 的 GPT-6.2 Astra 通过非官方中转服务流出演示,单提示词即可生成完整可交互的地牢游戏,Web 与前端能力提升尤为明显;BioBasics Bench 隐藏条目泄漏显示其得分 89,前代仅 67。与此同时,OpenAI 与四家独立机构达成安全合作,模型延迟被认为与对齐难度和过度谨慎有关,Altman 关于接近 RSI 的表态加剧了"能力被按住"的猜测。谷歌 Gemini 4 Neon 与 Oxygen 现身日志,命名已扩展到元素周期表级别。腾讯 HY4 Flash 以近 18 倍成本优势逼近 Claude Haiku 5.5,Hugging Face 与 OpenRouter 整合简化了开源模型调用。工程侧,Anthropic 强调验证与生成同等重要,Codex 容量错误下降约 99%。
OpenAI 的旗舰模型节奏正在出现一个明显的空档期。距离 GPT-6 Astra 发布已经过去约 75 天,这期间虽有 Sol、Luna、6.1 Sol 与 Terra 等型号陆续登场,但真正意义上的 Astra 级升级迟迟未到。话说回来,通过非官方渠道流出的 GPT-6.2 Astra 早期演示和基准数据,让这款未发布模型的能力轮廓第一次变得清晰。
GPT-6.2 Astra:从 API 中转服务流出的"非官方预览"
据多位获得访问权限的用户反馈,GPT-6.2 Astra、Sol 乃至 Terra 的模型标识曾在 Azure 相关访问入口出现,随后有中转服务据称在数小时内提供了可用接口,用户可以直接把这些模型接入 Codex 等官方工具链使用。这一渠道的合法性存疑,但演示结果本身值得关注。
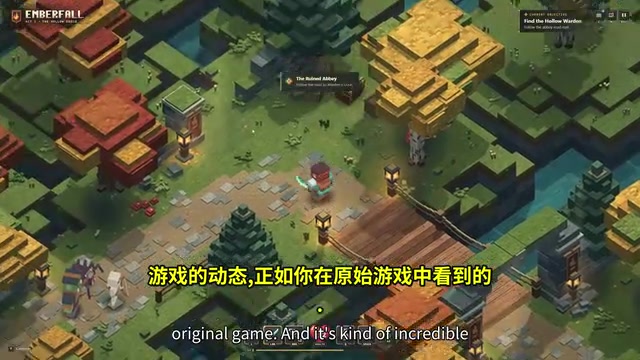
最引发讨论的是一个由单条提示词生成的"地牢探索"类游戏。从贴图质感、宝箱交互、怪物行为到关卡细节,整体完成度远超以往 GPT 系列在游戏开发任务上的表现。关键在于,这些资产并非调用外部素材,而是模型用纯代码从零构建——此前用 GPT 模型做游戏时常见的"先摆占位方块再替换 3D 资产"的做法,在这里被直接跳过了。
另一个可对比的案例是"鹈鹕骑自行车"生成测试。在 3D 版本中,GPT-6.2 Astra 的生成质量明显优于前代,鹈鹕翅膀甚至能自然地伸出画面边界。反馈中较一致的判断是:这款模型在 Web 开发与前端任务上的提升幅度最为显著,而这恰恰是 OpenAI 模型过去相对吃力的领域。
基准泄漏:89 对 67 的分差
更硬的证据来自一次基准数据泄漏。据 Binkji 的调查,OpenAI 在新的 BioBasics Bench 基准交互图表中意外暴露了一个隐藏的第八个模型条目,通过浏览器开发者工具执行 JavaScript 命令即可显形。该条目显示 GPT-6.2 Astra 在最高设置下取得 89 分,而 GPT-6 Astra 为 67 分,相差 22 分。
需要说明的是,这一发现尚未被独立验证,相关漏洞据称也已被修补。但若数据属实,这将是 Astra 系列在科学类基准上一次相当可观的跃升。
BioBasics Bench 是一个面向科学基础能力的评测基准,其具体构架未在文中详述,但从命名与分数区间(67 至 89)可推断其评分体系采用百分制或类似归一化标准。与常见的静态知识问答不同,这类基准往往通过多步推理、图表解析或实验设计等任务来区分模型的科学素养层级,因此 22 分的差距通常意味着一个代际级别的能力跃迁,而非微调带来的波动。需要注意的是,基准分数的高度依赖题目分布、提示词设置与评分脚本,单一泄漏条目缺乏完整评测卡(model card)与复现细节,只能作为方向性参考。
安全对齐:被推迟的旗舰,还是被"扣下"的能力
性能之外,另一条线索指向延迟的原因。有报告称 OpenAI 在 GPT-6.1、6.2 乃至 6.5 上遭遇了对齐与安全方面的实质困难:模型本身具备大规模预训练的能力,但把它们转化为可安全公开发布的形态,导致了以周计的延期。甚至有说法认为,OpenAI 在安全上的谨慎程度已超过 Anthropic,并因此取消了 GPT-6.1 Astra 的初始发布。
OpenAI 同期宣布了一项四方安全合作:与 Meter、Apollo Research、Goodfire 和 Transluce 四家独立机构合作,向它们开放内部模型的更深层访问权限,用于调查对齐风险与评估安全问题。此外,有据称被删除的工程师推文暗示,公司在某次安全事件后变得格外谨慎。
这两条线索——能力跃升与安全延迟——很可能是同一枚硬币的两面。Sam Altman 在一次访谈中据称表态"我们之前没有 AGI,现在有了",并提到本可以更靠近递归自我改进(RSI)的区间。这类表述缺乏完整上下文,但它与"模型太强所以先按住"的猜测形成了呼应。
递归自我改进(Recursive Self-Improvement, RSI)是 AI 安全讨论中的核心概念,指系统具备改进自身代码、架构或训练流程的能力,且改进后的版本能继续加速下一轮改进,形成正反馈循环。Altman 所称"更靠近 RSI 区间"并不等于系统已实现自主迭代,而更可能指模型在 AI 研究与工程任务上的辅助能力已足以显著压缩研发周期。这一表述之所以与安全延迟关联,是因为 RSI 被视为能力失控的关键阈值之一:一旦改进速度超出人类审查节奏,对齐与评估窗口会被急剧压缩。因此,业界对任何接近 RSI 的信号都保持高度敏感,这也解释了为何能力跃升与发布推迟常被放在同一框架下解读。
谷歌的模型名录正在变成元素周期表
Google 这边的节奏则完全是另一个方向。后端日志中出现了 Gemini 4 Neon 与 Gemini 4 Oxygen 两个新标识,与已有的 Argon、Carbon、Krypton 并列。Neon 的定位尚不清楚,它既作为模型名出现,也作为独立的订阅层级出现——存在与 Gemini Ultra 关联的 Neon 分级,以及与 Gemini Plus 关联的 Helium 分级,还有针对视频生成低用量预算的告警系统。
Oxygen 的轮廓更清晰一些:它被认为是 Gemini 4 家族中的 Flash 级模型,在 Web 开发与前端任务上表现突出,速度极快,多项测试中输出质量优于 Carbon。在 VoxelBench 的城堡生成对比中,Oxygen 的细节与整体质量明显好于 Neon 的产出。
发布密度已经高到让"用元素周期表命名"从玩笑变成了现实描述。这种节奏本身也引出一个问题:Google 是否已经触碰到某种自我加速的临界点?从现有信息看,更合理的解释是工程与产品团队的密集迭代,而非 RSI。
效率战:腾讯 HY4 Flash 与开源路由的整合
在旗舰模型之外,成本与速度的竞争同样激烈。腾讯发布了 HY4 Flash,其自测数据显示:在 85 名用户、259 个真实任务的盲测中,HY4 Flash 在最高思考模式下与 Claude Haiku 5.5 的用户满意度几乎持平(2.79 对 2.81),但平均任务成本为 4 美分,对比后者的 71 美分,便宜近 18 倍,同时也是测试中最快的模型,平均每任务约 6.7 分钟。
规格上,HY4 Flash 总参数 2240 亿、激活参数 120 亿,支持 100 万 token 上下文与原生多模态,生成速度超过每秒 150 token。API 定价为每百万输入 token 7 美分、输出约 28 美分,腾讯称其单任务成本比自家更大的 HY4 低 24.5 倍,并计划开放模型权重。
实际能力上,这款 Flash 模型有明显短板:在"女士骑自行车"的 SVG 生成对比中,它输给了 Coin4Max,即便在更高推理档位也出现了错误。但在 Web 开发类任务(如模拟蜜蜂采粉的交互页面)上,它出得快、做得对、价格低。定位很清楚——不是替代 Haiku 5.5 的智能上限,而是用更低的成本承接高频日常任务。
对开发者更实用的变化来自 Hugging Face 与 OpenRouter 的整合:Hugging Face 上的模型现在可以经由 OpenRouter 路由,后者依据价格、速度和可靠性自动选择最优供应商,并在供应商不可用时自动故障转移,开发者沿用现有的 Hugging Face token 与 API 即可,无需管理多个供应商。

配套的 Hugging Face Broadcast 功能允许把请求轨迹直接存入 Hugging Face 存储,让模型交互记录与项目一起留在 Hub 上,便于后续的评估、调试与微调。
模型路由(Model Routing)是一种在推理请求层面做动态分发的架构:网关根据任务类型、上下文长度、延迟预算与实时价格,将请求转发给不同供应商或不同规模的模型,并在主供应商超时或报错时自动切换到备用节点。OpenRouter 即提供此类聚合层,开发者用统一 API 接入多家模型,按 token 计费并享受故障转移。Hugging Face 与其整合后,Hub 上的模型可直接经路由调用,省去逐一申请密钥与维护多套 SDK 的成本。这类中间层的价值在于把"选模型"从静态配置变成运行时决策,但也引入了对路由策略透明度和数据流向的额外依赖。
工程侧:验证正在变得和生成同样重要
Anthropic 公布的一篇博文提供了一个值得关注的视角:Claude 目前编写并审查了 Claude Code 团队近 90% 的代码。问题随之而来——谁来保证这些 AI 生成的代码真的能跑?
他们的答案是验证工作流:让 Claude 运行真实应用、测试数千种输入、比对结果,并在提交前自动修复缺陷。团队还建立了 slash verify 技能,在 Claude 三次尝试仍无法解决问题时引入人工介入,并维护了 39 项基于历史缺陷的检查规则,每次变更时由 Claude 挑选最相关的一项执行。
这个思路的意义在于,当数十个 AI 编码代理并行工作时,瓶颈不再是能生成多少代码,而是能否证明代码可用。生成与验证的权重正在重新分配。
同类改进也出现在其他工具上。Codex 修复了长期困扰用户的"模型容量已满"错误:根据 10 月 15 日至 11 月 12 日的数据,高峰期有 6.89% 的日活用户至少遇到一次容量相关错误,而在 11 月 6 日的更新后,该比例到 11 月 12 日降至 0.085%,降幅约 99%。这一改善主要来自重试指令、自动延迟和 WebSocket 错误处理的优化,而非算力扩容。
OpenCode Browse 0.1.0 用 Rust 重写,内存占用降低 25 倍、体积缩小 23 倍,并彻底移除了对 Playwright 的依赖,浏览器操作直接暴露给 AI 代理。Claude Code 桌面版则进入公测,支持在 iOS 模拟器中运行 iPhone Duo 应用,能自动折叠与展开模拟设备以测试不同布局。
AI 编码代理的验证瓶颈,根源在于生成成本与审查成本的不对称。当模型能以极低边际成本产出大量代码时,人类评审者的注意力成为稀缺资源,传统"生成后人工 review"的流程会迅速堆积。Anthropic 的做法是把验证也交给代理:让模型在真实运行环境中执行测试、比对预期输出、自动修复失败用例,仅在多轮尝试无效时升级给人工。这实际上是把软件工程中的持续集成与自动化测试思想移植到代理工作流中,用可执行的检查规则替代主观判断。其局限也很明显——验证规则本身由模型挑选和执行,若规则覆盖不足或模型对失败原因误判,仍可能漏放缺陷。
医疗、科研与 AGI 话语
OpenAI 在应用层的推进同样密集。一项覆盖 1800 多名参与者的"ChatGPT 学术研究者"项目显示,科学家自报生产力接近翻倍,用途涵盖头脑风暴、复杂数据集分析、写代码与加速科研流程。这些是自报数据,但方向值得留意。
医疗方向,OpenAI 推出了能力更强的计算机使用代理、改进的临床响应,以及 20 多个医疗插件。Abridge、Ambience、Cigna 与 CVS Health 等机构已将其用于保险事前授权、患者转诊、出院规划和患者触达等行政任务。
Google 方面,Gemini Notebook 支持把资料源转化为可交互、可分享的网站,用户只需在对话中描述需求即可生成仪表盘或项目追踪器,该功能面向 18 岁以上用户全球开放。Antigravity 中 Gemini 的 Carbon、Hydrogen、Argon 上下文窗口从 256k 翻倍至 512k token,上下文压缩频率据称降低至原来的约 3.5 分之一。
行业情绪层面则出现拉扯。上周末,六个国家超过一千人参与了据称是史上规模最大的 AI 安全游行,呼吁达成 AI 条约;Anthropic 的一位研究员在访谈中给出"约 1.3 年后出现广泛超越人类的 AI"的时间线,即大约 2027 年底。
把这一切放在一起看,OpenAI 面对的真正难题或许不是模型够不够强,而是这些越来越强的系统能否被安全地交到公众手里。GPT-6.2 Astra 的演示越惊艳,这个问题就越难回避。
相关推荐

小模型微调逆袭:2B/4B参数击败GPT-6 Luna
用Shopify商品分类任务实测:20亿和40亿参数的Qwen 3.5微调后准确率分别达69.8%和73%,超过GPT-6 Luna的68.2%。完整拆解数据准备、LoRA超参数、serverless微调与评估流程。

Beni跟拍摄像机器人上手:4K 60p HDR+智能避障
Beni 跟拍摄像机器人亮相 YouTube:4K 60p HDR 成像、17.9 英里/小时最高速度、智能避障可跨越 10 英寸台阶,支持并行追踪、宠物尾巴追踪与 Orbit 环绕运镜,配手表遥控器,重新定义自动跟拍体验。

Gemini 4 Krypton曝光:性能逼近Fable 5.2价格更低
谷歌Gemini 4 Krypton曝光,性能逼近Fable 5.2而成本更低;Claude Code新增主题定制与多线程项目协作;Anthropic官方指南揭示选型真相:Opus 5.5日常使用性价比高于Fable 5.2。