GPT-6.5爆料与Claude Fable 5.5、Gemini 4 Carbon齐曝光

多源爆料勾勒下一代模型密集发布期,可信度需按证据分级判断。
本文梳理了一周内集中出现的AI模型爆料与早期测试信息,涉及OpenAI GPT-6.5与GPT-6.1 Terra、Anthropic Claude Fable 5.5、谷歌Gemini 4 Carbon,以及MiniMax M3.1 Flash、Kimi K3.1、GLM Omni/5.3、DeepSeek 4.1 Flash等中国厂商动向,并附带英伟达vLLM推理优化与Dreamlabs机器人基础模型的消息。文章对每条线索给出可信度评估:微软代码PR、官方发布与论文支撑的信息较为可靠;神秘网站倒计时已被证伪为恶搞,Gemini 4 Carbon“媲美Opus 5.5”的说法也被多位测试者实测否定。核心结论是,在模型密集发布期应以可验证的代码与官方数据为准,对单一爆料保持审慎。
一周AI爆料潮:下一代模型集体浮出水面
最近一段时间,AI圈几乎被一系列密集爆料与早期测试信息淹没。从OpenAI的GPT-6.5线索,到Anthropic的Claude Fable 5.5、谷歌的Gemini 4 Carbon,再到中国厂商MiniMax、Kimi、智谱的新动向,多个独立来源共同描绘出一幅“下一代模型集中发布期”的图景。据The Information报道,本月可能迎来一波密集的大模型发布潮,涵盖Anthropic、谷歌与OpenAI的新模型;而来自微软代码仓库、神秘网站、以及社交平台的多条线索,则为这些传闻提供了不同程度的佐证。
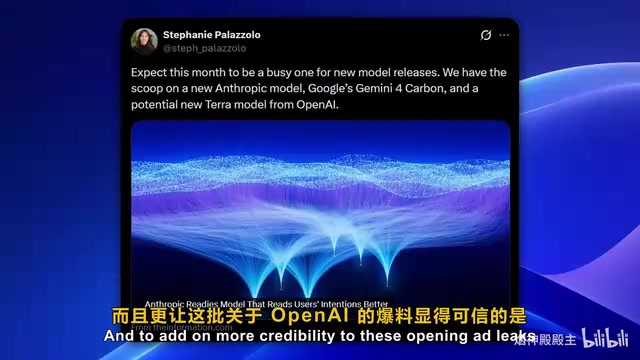
GPT-6.5:神秘网站与微软代码的双重信号
关于GPT-6.5的最早线索来自一个由Tibo买下的神秘网站OpenCLoli,其HTML原码中暗藏“6.5”字样,并配有指向旧金山时间11月1日上午10点的倒计时。耐人寻味的是,这个时间恰好与Tibo此前“28天倒计时”的最后一天完全重合,引发不少人猜测OpenAI可能用一款重磅新模型为连发计划压轴收官。
不过,这条线索存在明显反转:有用户深挖网站历史存档发现,9月23日的记录显示该域名曾被描述为“待售的独立OpenAI恶搞网站”,因此它并非官方权威消息。但另一条线索相对硬核——据报道,GPT-6.1(代号Terra)已出现在微软的代码拉取请求中,其中18项评估配置从“GPT-5.6 Terra”更新为“GPT-6.1 Terra”。代码变动比网站倒计时更具可信度,暗示微软可能已在准备测试或接入OpenAI的下一代Tera模型。
代码拉取请求(Pull Request,简称PR)是GitHub等代码托管平台的核心协作机制:开发者完成一段修改后,向主仓库发起PR,请求将自己的改动合并进去。PR中会清晰展示新增、删除或替换的具体代码行,以及涉及的配置文件和评估条目。因此,当微软的PR里出现“GPT-5.6 Terra”被更新为“GPT-6.1 Terra”的18项评估配置改动时,这类信息通常反映的是真实工程行为——微软在Azure或相关产品中接入、测试OpenAI模型的内部流程。与营销页面或倒计时网站不同,PR是内部开发流程的副产品,伪造或恶搞的成本很高,这也是它比神秘网站线索更可信的根本原因。
Claude Fable 5.5:从修bug到主动发现一类问题
据The Information报道,Anthropic正在筹备的新模型很可能就是Fable 5.5,其推理与直觉能力显著提升。一位匿名测试者透露,该模型不会只按用户要求修复单个bug,而是能识别出该bug可能属于某一类更大隐患,并主动询问是否一并解决。这种“举一反三”的能力,对自主编程智能体来说是一大突破——现有模型的最大痛点之一,就是用户必须明确指定要排查什么、修复什么。
报道还指出,Fable 5.5更擅长打破思维定势,而不是复述常规方案或常识性建议。在遵循指令方面,现有模型已经相当出色,但面对全新未知问题时拿出有创意的解法,仍是巨大挑战。
Gemini 4 Carbon:早期检查点被高估?
关于谷歌的Gemini 4 Carbon,此前商业内幕曾援引消息称其编程能力“足以媲美Opus 5.5”。但多位测试者——包括本文原始视频作者——亲自测试了Carbon B与Carbon C两个检查点后,认为这一说法完全不实。该测试者表示,这些检查点的实际代码质量不仅与Opus 5.5差距明显,甚至相比谷歌现有的Gemini 4 Argon模型也几乎看不到实质性提升,速度虽略有加快,但代码质量反而有所下降。
提一嘴,这些只是早期检查点,随着后续迭代仍有很大提升空间。但“媲美Opus 5.5编程性能”的说法在当前阶段站不住脚,谷歌要追上这一水平可能还需数月时间。
“检查点”(checkpoint)是模型训练过程中的中间快照,包含某一时刻的全部权重参数。大模型训练往往持续数月,团队会定期保存检查点,以便评估进展、回滚实验或用于内部测试。早期检查点通常只完成了部分训练数据或训练阶段,能力与最终发布版本存在明显差距。文中所说的Carbon B、Carbon C即谷歌Gemini 4训练过程中的两个不同阶段快照。测试者基于早期检查点得出的结论,只能反映“当时那一刻”的水平,不能直接等同于最终产品;但反过来说,如果早期检查点已明显落后于竞品同期水平,也说明谷歌要追平差距需要额外的迭代时间。
MiniMax M3.1 Flash:极致性价比与基准表现
中国厂商方面,MiniMax M3.1 Flash已结束预览阶段正式发布,官方确认此前横扫榜单的神秘模型“SpaceMoney Alpha”正是其早期版本。据称该模型已处理超过200万亿个Token,生成速度超过每秒200个Token,比上一代M3快近三倍,价格还便宜约70%。
基准测试数据尤其引人关注:在自动化评测中,M3.1 Flash据称拿到62.2%的成绩,对比Claude Opus 5.5的50.3%和GPT-5.6 SO的45.8%;在DeepSway测试中拿下74%,足以与贵得多的模型在编程评测中平起平坐。价格方面,每百万输入Token仅0.15美元、输出0.60美元,缓存输入更低至每百万0.15美元;对比Claude Opus 5.5每百万输入5美元、输出25美元,以及GPT-5.6 SO的4美元与20美元,成本优势非常明显。
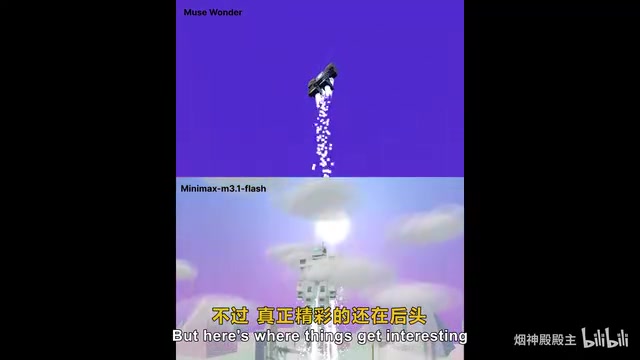
在实际测试中,M3.1 Flash复刻太空兔仙岛预告片的画质胜过Muse和DeepSeek广告 4.1 Flash;复刻特斯拉警车追逐场景仅花费2.34美元,比DeepSeek的约3.07美元便宜近24%;为硬件新品发布制作落地页仅花费1美分,比Opus 5.5的1.22美元便宜近88倍,速度快4倍。当然,成本低不代表效果更好——Opus 5.5生成的实际效果确实更好,但MiniMax可以作为低成本打底框架,再用更强模型完善。
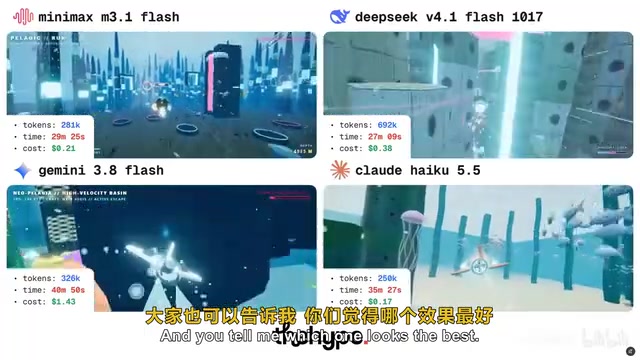
在潜艇追逐场景的复杂视觉代码测试中,MiniMax耗时约29分钟、成本约21美分,比Gemini 3.8 Flash便宜近7倍,比DeepSeek 4.1 Flash便宜1.8倍,生成速度也更快。测试者个人认为Haiku效果最好,但MiniMax M3.1 Flash排在第二。综合多项基准与提示词测试,该模型综合排名位列第18位,对一款Flash急速版模型而言已相当惊艳。
另据报道,MiniMax正准备推出性能更强的M3.1 Pro版本,参数量可能高达2.7万亿,有望成为迄今体量最大的AI模型之一。消息来自The Information早期爆料及路透社报道。
中国厂商多点开花:Kimi、GLM与DeepSeek
Kimi K3.1:PR中闪现的推理档位
据爆料,有人在相关PR中发现了Kimi K3.1的踪迹,但该请求在短短7分钟后被神秘关闭。在消失之前,测试数据显示其已在DeepInfra上线部署,记录最早可追溯至10月18日。该模型采用相同分词器以及与Kimi K3完全一致的对话格式,但新增四档推理级别——低、中、高和最高档,默认设为最高档,并支持图像输入。
GLM Omni与GLM 5.3:多模态与后训练潜力
智谱AI在等待GLM 5.4和5.5亮相之际,旗下代码平台Zcode引入Git工作流模式,开发者可同时协同调度多个AI智能体,演示中展示了10个独立运行的子智能体并实时追踪进度。
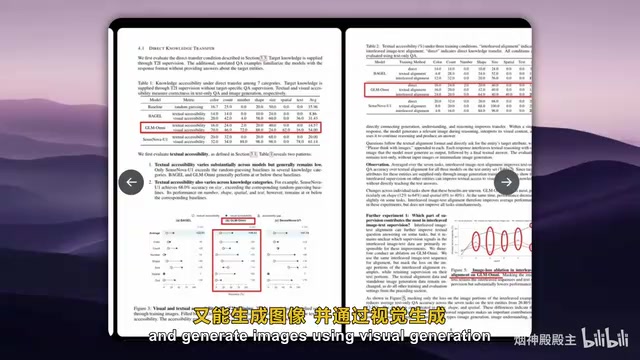
最新曝光的论文透露其内部有一款名为GLM Omni的多模态模型,可理解图像并生成图像,通过视觉生成真正吸收新信息。据介绍,研究人员将图文对齐准确率从12.57%提升至26.86%。
另一项进展来自GLM 5.3:据报道其仅凭后训练就取得重大提升,无需改动基础架构或增加参数,在Terminal Bench测试中得分从4.6飙升至28.3。这说明巨大的性能潜力可以通过更出色的后训练激发,而不必从头训练全新模型。
后训练(post-training)指基础模型完成大规模预训练之后的所有训练阶段,通常包括监督微调(SFT)、基于人类反馈的强化学习(RLHF)、拒绝采样、以及针对推理与工具使用的专项强化训练等。它的特点是不改变模型的基础架构,也不增加参数规模,而是通过更高质量的数据、奖励信号和训练策略,把预训练阶段已经潜藏的能力“激发”出来。GLM 5.3在Terminal Bench上从4.6跃升至28.3,正是后训练价值的典型例证:同一套底座权重,经过更精细的后训练流程,在终端命令行任务上的表现可以发生数量级变化。这也意味着,模型能力的竞争不只发生在参数量和预训练算力上,后训练方法论同样是关键战场。
DeepSeek 4.1 Flash免费开放
据原始内容,DeepSeek 4.1 Flash(1017模型)在OpenCode中已完全免费,无需繁琐设置,后台已全部更新完毕。
英伟达推理优化与机器人新进展
英伟达方面传来一条引人注目的消息:据传达成了单用户每秒423个Token的推理速度,且是在参数量高达2.8万亿的Kimi K3模型上实现,在完全相同的硬件架构下实现了1.68倍的速度提升。这归功于一项新的vLLM优化,由英伟达SendML团队开发,核心是基于QDSL编写的深度优化解码内核,利用“巨型内核融合”技术大幅降低推理开销,背后凝聚了约1.2万行经过深度优化的底层内核代码。这意味着无需增添硬件、无需改动模型,仅靠更优秀的软件就能大幅释放性能。据悉英伟达正着手将类似优化应用于DeepSeek 4.1及其他模型。
机器人领域,Dreamlabs携Dreamman正式走出隐秘期,这是一套全新的机器人基础模型,专门操控此前从未接触过的机器人。据官方介绍,DreamE能让双臂机器人执行未经专门训练的任务,甚至完成此前从未做过的操作,且使用成本每小时仅需3美元,目前DreamAPI已面向开发者开放。其在现实环境中的泛化可靠性仍有待观察,但基础模型直接适配不同机器人、无需大量重训的前景值得期待。
vLLM是当前主流的开源大模型推理引擎,其核心创新是PagedAttention——借鉴操作系统虚拟内存分页的思想管理KV Cache(键值缓存),从而大幅减少显存浪费、提升吞吐。推理过程中的解码(decoding)阶段需要逐个Token生成,每次都要调用大量小算子,算子启动与调度开销会显著拖慢速度。“巨型内核融合”(mega-kernel fusion)就是把多个细粒度算子合并进一个更大的GPU内核中一次性执行,减少内核启动次数与内存往返,从而在相同硬件上释放更高吞吐。文中基于QDSL编写的解码内核与约1.2万行底层优化代码,正是这一思路的工程落地:不增加GPU、不改动模型权重,仅靠软件层优化就把单用户生成速度提升1.68倍。
多源交叉下的判断
综合来看,本周爆料中可信度较高的是微软代码仓库中出现的GPT-6.1 Terra引用、MiniMax M3.1 Flash的正式发布与定价、以及GLM 5.3后训练带来的基准提升——这些信息有代码、官方发布或论文作为支撑。相对不确定的是GPT-6.5的神秘网站线索(已被历史记录证伪为恶搞网站)以及Gemini 4 Carbon“媲美Opus 5.5”的说法(多位测试者实测不认可)。在模型密集发布期,保持对单一爆料的审慎、关注可验证的代码与官方数据,仍是判断下一代模型真实水平的关键。
相关推荐

奥特曼称本地部署不如数据中心,开源AI路线之争再起
奥特曼称开源大模型本地部署不如数据中心集中运算,B站UP主瓜熟迪落拉拆解这一表态背后的技术路线之争与中美AI业态差异,讨论本地部署是否真的该被放弃。

MiniMax H3开源工作流:低显存也能打造呼吸感皮肤
本文介绍B站UP主分享的MiniMax H3双采样工作流,通过融合模型、破线LoRA和低显存节点,解决AI人物面部油腻问题,并让12G显存设备也能运行。包含模型搭配、双采样逻辑与参数设置详解。

手机本地大模型+ESP32:自制热量提醒器
B站UP主开源了一个热量摄入提醒器项目:手机APP用miniCPM开源模型本地拍照识别食物并估算热量,ESP32小屏幕同步数据,用绿黄红圆环展示摄入状态,可磁吸在冰箱门上随时提醒。