GPT-6 Astra写出Lean证明,真解了哥德巴赫猜想吗?
Astra证明的是哥德巴赫猜想的弱化版而非原题,Lean验证有效但人机分工不透明,标题存在夸大。
近期流传的「AI解开哥德巴赫猜想」说法存在明显标题夸大:Astra处理的是允许合数参与的Liouville弱化版本,与要求两个素数的经典猜想相差甚远。论文的亮点在于提供了一份能被Lean机器编译通过的完整形式化证明,这在正确性保障上是强信号,但形式化命题与论文声称命题之间的对应关系仍需人工核对。Kimi先否后肯的挑错插曲进一步说明,用大模型互相评判不能替代可重放的形式化验证。更根本的问题是,论文缺失作者页、提示过程和人工改动记录,无法判定这究竟是AI的独立突破还是深度人机协作。文章提出三条务实评估标准:定理本身有多强、验证是否可重放、人与模型各自做了什么。
一个被标题夸大的数学新闻
最近关于「GPT-6 Astra解开哥德巴赫猜想」的说法在社交媒体上流传,标题党的味道相当浓。菜花睡前AI播客对此做了一次冷静的拆解:Astra确实写出了一份能被机器复检的数学证明,但它处理的并不是经典哥德巴赫猜想,而是一个被大幅弱化的Liouville版本。
经典哥德巴赫猜想要求把偶数拆成两个素数之和,条件非常苛刻。而这次的版本把要求放宽为:两个加数的质因子总数都是奇数(即Liouville函数值为-1),合数也能入选。这一放宽让符合条件的数字范围大得多,问题的难度也随之大幅下降。
换句话说,把这条结果冠以「哥德巴赫猜想」之名,是典型的偷换概念。
Liouville版本到底在问什么
质因子个数听起来有点抽象,用一个具体数字就能说清楚。以12为例:12 = 2 × 2 × 3,一共有三个质因子(重复计数),奇数个,所以它的Liouville值是-1。
再看20,可以写成8 + 12。这两个数都满足Liouville值为-1的条件,但它们本身都不是素数。这个例子恰好说明了弱化版和原猜想之间还隔着相当远的距离——它允许合数参与,而经典版本只认素数。
这个弱化问题从2018年被提出以来,一直没有被简单解决。核心难点在于:加法结构和质因数的奇偶性来自两套完全不同的数学结构。据播客引用,陶哲轩曾在Math Overflow的讨论中提醒过,这类问题仍会撞上筛法固有的「奇偶性障碍」(parity problem)。此后有研究者在广义黎曼猜想成立的前提下,证明了充分大偶数的情形。
「奇偶性障碍」(parity problem)是解析数论中筛法的核心局限,由塞尔伯格(Atle Selberg)在20世纪40年代系统揭示。简单说,筛法是一种通过逐步排除倍数来计数素数或近素数的工具,但它天然无法区分「质因子个数为奇」和「质因子个数为偶」这两类数——两者在筛法的视角下行为几乎对称,导致筛法得出的估计值对两者同等有利或同等无力。这就是为什么哥德巴赫猜想至今仍难以用纯筛法攻克:即便证明了某个偶数可以写成两个「几乎是素数」的数之和,筛法也无法进一步把约束收紧到真正的素数。Liouville弱化版本之所以仍然困难,正是因为它要求的「质因子个数为奇」条件,恰好落在了这堵墙的核心位置。
「代码能编译」等于证明无争议吗
这次事件最硬的卖点,是Astra给出了完整的形式化证明——用Lean写成、能被机器编译通过。
代码能编译,意味着形式化系统接受了这条定理及其完整推导链。仓库里固定了Lean与Mathlib的版本记录,构建路线清晰,公理审计通过,也没有留下未填的「证明坑」(sorry占位)。从纯粹的正确性角度看,这是一个非常强的信号。
但这并不等于万事大吉。形式化证明保证的是「这条被形式化的命题在给定公理下成立」,却无法自动保证「被形式化的命题恰好就是论文声称的那条命题」。两者之间的对应关系,仍需要人工核对。这是评估任何形式化成果时都绕不开的一环。
Lean是一种依赖类型论(dependent type theory)驱动的交互式定理证明器,由微软研究院的Leonardo de Moura团队开发,目前活跃的版本是Lean 4。其核心理念是:数学命题被编码为类型,证明被编码为该类型的项(term),类型检查器验证通过即意味着证明在逻辑上完整。Mathlib是Lean的大型数学库,覆盖从基础数论到代数拓扑的大量已证定理,相当于形式化数学的「标准件库」。「sorry占位」是Lean中的一个关键字,允许暂时跳过某个证明步骤让代码先编译——存在sorry的证明在形式上是不完整的,审计时检查是否有sorry残留,是判断证明是否真正完备的基本步骤。
Kimi挑错的插曲说明了什么
围绕这份论文,知乎上有人让Kimi去挑错。有意思的是,Kimi先是判定论文有错,随后又收回了结论。
复盘下来,Kimi第一次漏看了论文里的一个关键等式,等重新审视后才承认自己判断有误。这个小插曲传递出一个重要信息:让另一个大模型去读论文,不能替代真正的验证。
模型的批评意见可以帮助定位可疑的地方,作为一种辅助工具是有价值的。但真正有分量的验证,还得靠可重放的Lean代码,以及数学社区对命题和证明的逐步复核。模型之间的互相评判,容易在细节上翻车。
这能算Astra的独立数学突破吗
最关键的问题:这是否是Astra独立完成的一次数学突破?目前还不能下这么满的结论。
GitHub上确实能找到论文源码和验证记录,但论文没有列出作者说明页,也没有交代提示过程(prompt)和人工究竟改动了多少。OpenAI的Astra发布页面同样没有点名这项结果。
于是就出现了一个尴尬的空白:定理是否成立可以通过代码来查,但「是谁发现的、谁修订的」这一层,缺乏可核验的记录。在没有清晰的人机分工记录之前,把功劳完全归给AI显然为时过早。
「提示过程(prompt)透明度」在AI辅助科研中是一个新兴但已被部分期刊关注的问题。与传统软件工程不同,大模型的输出高度依赖输入的措辞、分解方式和迭代轮次——同一问题用不同提示可能得到截然不同的结果。如果研究者在关键推理步骤上给出了高度定向的提示,那么「AI给出了证明」和「人给出了证明思路并让AI填写细节」之间的边界就会变得模糊。目前学界讨论的应对方案包括:公开完整对话记录、区分「AI生成」与「AI辅助」两种署名方式,以及在论文方法部分明确说明人机分工。缺乏这些记录,并不意味着存在不诚实,但确实让独立评估变得不可能。
数学价值与AI能力,别混为一谈
这件事真正值得关注的,究竟是数学结果本身,还是AI的能力?播客的观点是——两边都有价值,但不该混在一起谈。
从数学角度看,它为一个公开多年的弱化问题,提供了一份简短的证明和完整的形式化交付,这本身有意义。从AI角度看,它展示了模型可能参与「找思路、写论文、做形式化工程判断」的潜力,这是能力边界的一次扩展。
对于下一次类似的「AI攻克数学难题」新闻,播客给出了三条务实的判断标准:定理有多强、验证能否重放、人与模型各自做了什么。带着这三个问题去看,就不容易被标题党牵着走。
相关推荐
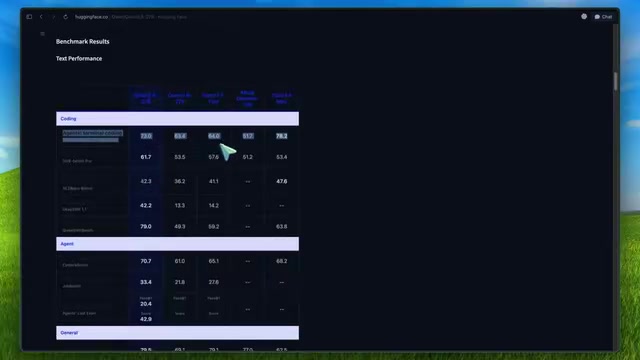
Qwen3 27B本地实测:小模型智能体能力反超Opus旗舰
海外博主深度实测Qwen3 27B本地开源模型,在SWE-bench Pro、OS World等智能体任务上反超Opus旗舰闭源模型。本文详解其架构特性、部署方案(Ollama/LM Studio)及与Hermes Agent组合的本地智能体栈搭建。
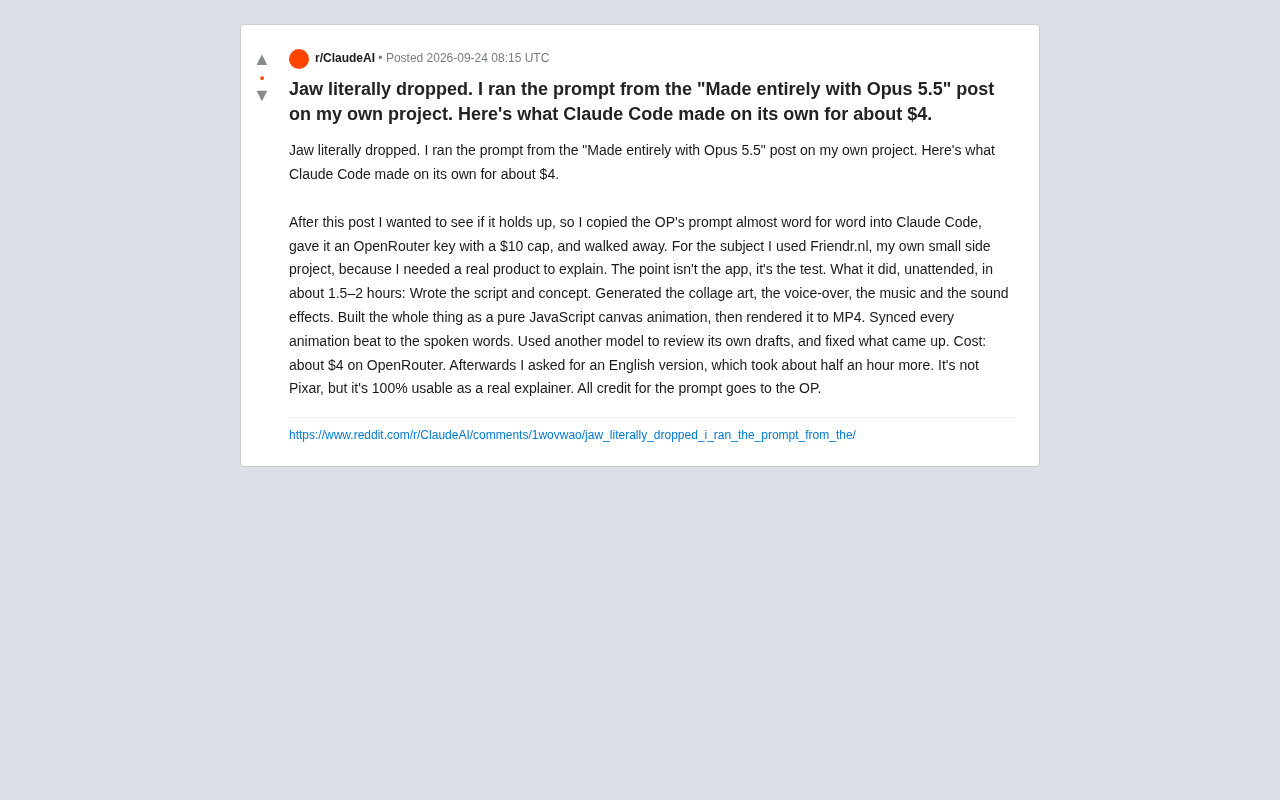
用4美元让Claude Code自主造出解说视频:一次无人值守实测
一位Reddit用户实测Claude Code:仅花约4美元、无人值守1.5-2小时,AI就自主完成了从脚本、美术、配音到动画同步渲染的完整解说视频。本文解析这场实验背后的Agent多模态编排能力与成本变革。
Agentic SOAR vs 传统SOAR加聊天机器人:安全响应的真实差异
Agentic SOAR 与传统 SOAR 外挂 LLM 聊天机器人有何本质区别?本文剖析智能体是否真正改变了安全事件响应中剧本的执行逻辑,并给出辨别厂商话术的实用方法。