GPT-6 Astra只改0.016%权重,数学分数暴涨6倍

AI改权重让数学成绩涨6倍,但只是拆了路障而非变聪明。
文章通过一个引人注目的案例探讨AI模型能力提升的两种逻辑。研究者让前沿模型GPT-6 Astra直接修改Qwen小模型仅0.016%的权重,使其在MATH500上的成绩从7.9%跃升至48.1%,涨幅约6倍。但作者承认,这只是修掉了模型的推理循环,让原本算得出的答案能写完,而非真正提升数学能力。对照实验中,Gemma 3 270M因缺少明显的循环路障,同样操作下提升不到1个百分点,差距约45倍。文章由此提出「空手度」概念区分实验条件,并引用Simon Willison的笔记本测试,说明该能力已下放到本地小模型但过程缓慢如黑盒。最终结论是:改权重能移除障碍却加不出新能力,评估AI成绩应先问工具条件、起点瓶颈和对照验证三个问题。
一个令人不安的涨分案例
最近,一个AI模型在数学测试中从7.9%跃升到48.1%——涨幅约6倍。更让人意外的是,这个提升只靠修改了另一个模型极微小的权重比例(0.016%)。这究竟是模型变聪明了,还是它原本卡住的地方终于通了?YouTube频道「卖爆」用这个例子拆解了两种截然不同的升级逻辑,而答案可能直接影响你如何看待AI的每一次「突破」。
实验:模型改模型,只动一根「嗡嗡响」的方向
这个例子出自一篇研究者Rikiya Techie等人发表的论文,Simon Willison在博客中介绍了它。论文的核心主张很大胆:前沿模型(如OpenAI宣称能力最强的GPT-6 Astra)既能解读也能修改另一个模型的原始权重。
原始权重本质上是一份塞满数字的文件,描述模型会什么。Astra直接修改这些数字,相当于在不动训练流程的情况下,触碰模型的本事。
具体到数学实验:研究者让Astra修改Qwen某个小模型的权重,目标是修复一个具体毛病——该模型容易陷入「思考循环」,官方模型卡也承认它比其他Qwen模型更容易反复想、话讲不完。Astra把循环追溯到一个权重中的方向,把它减掉。
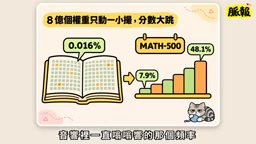
最终只动了0.016%的权重——用一本10万字的书换算,大概只改了16个字。但MATH500数据集上的成绩从7.9%升到48.1%。
分数背后的真相:路障被拆了,还是能力长了?
论文作者自己承认:修掉循环不等于数学变好,只是让模型能把本来算得出来的答案写完。两组数据能说明问题:在碰到试跑次数上限的回答占比从93%降到33%的同时,成绩从7.9%升到48.1%。没撞上限的回答变成原本的9.6倍,成绩约为原本的6.1倍——讲得完的比例涨得比成绩更猛。
所以这个案例更合理的解读是第二种:原本卡住的地方不卡了。「卖爆」把这种差别称为「空手度」——工具越少,空手度越高。改权重就像拆路障,Qwen有路障可拆,而对照组Gemma 3 270M没有这么明显的路障。
MATH500 是衡量大模型数学推理能力的常用基准之一,包含 500 道竞赛风格的数学题,覆盖代数、几何、数论、组合等类别,答案通常为可精确匹配的数值或表达式。由于题量适中、难度分层明显,它常被用来快速对比不同模型或同一模型改动前后的数学表现。需要注意的是,MATH500 的题目往往要求完整的多步推理,模型若在推理中途陷入循环或超时,即使最终答案本可算出,也会被判为错误——这正是本文案例中「成绩跃升」的关键背景。
权重(weights) 是神经网络中通过训练学到的参数,以海量浮点数形式存储,决定了模型对输入的响应方式。所谓「修改原始权重」,是指不重新训练、也不调整提示词,而是直接编辑这些数值。由于权重规模巨大,改动极小比例(如 0.016%)在数值上微不足道,却可能恰好作用于某个被反复激活的方向,从而改变模型行为。这也解释了为何「改权重」更像精准拆除某个局部障碍,而非系统性提升能力。
推理循环(thinking loop) 指模型在生成回答时反复回到相似的思路或表述,无法收敛到最终答案,常见于需要长链推理的任务。表现为同一句话被改写多次、步骤来回跳跃、迟迟不给出结论。在评测中,这类回答往往因超出试跑次数或生成长度上限而被截断,直接计为失败。本文中 Qwen 小模型有 93% 的回答撞上上限,说明其瓶颈主要不是「不会算」,而是「算不完」。修掉循环后,原本能算出的答案得以写完,成绩自然大幅回升,这也是作者强调「修掉循环不等于数学变好」的原因。
对照实验:为什么换一个模型就不灵了
研究者也做了对照:让Astra修改Gemma 3 270M的权重。Gemma系列体量小,很少陷入循环,只有8.5%的回答碰到上限(对比Qwen的93%)。结果Astra改完之后,Gemma在MATH500上的表现提升非常有限,Astra报告的最优改动也只带来微弱增益,且它自己把这次改动标记为「未能确立」——还不能算数。
差距有多大?Qwen提升了40.2个百分点,Gemma只提升了不到1个百分点,差了大约45倍。Astra看到的错误是算数错误、代数步骤不成立等普通推理问题,没有单一元件可以关掉。
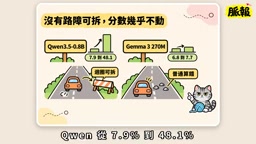
作者的结论很清晰:改权重能移除遮住能力的障碍,却加不出模型本来没有的能力。这条路叫「拆路障」,没有路障的时候,工具就失效了。
Gemma 3 270M 是 Google 发布的 Gemma 系列中的超小规模模型,参数量约 2.7 亿,主打轻量与本地部署。相比更大的模型,小模型在长链数学推理上更容易出现算数错误或步骤不成立等普通推理问题,而不一定表现为明显的重复循环。对照组的意义在于:如果改权重只是「拆路障」,那么当模型本身没有明显路障、瓶颈分散在大量普通错误上时,同样的操作就难以带来大幅提升。Gemma 仅 8.5% 的回答撞上上限,恰好说明它缺少一个可被单点移除的循环障碍,因此 Astra 的改动只能带来微弱增益,并被标记为「未能确立」。
这个能力已经下放到笔记本
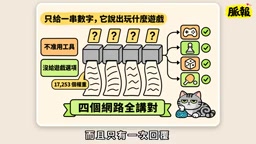
Simon Willison做了一个更接地气的测试:把论文在GitHub上公开的提示词直接喂给自己笔记本上的Qwen 3.8B模型。这个模型只有17句说明文件,开放下载。结果它认出了Pac-Man(46分12秒)、Pong(1小时4分54秒)、Breakout(52分25秒),但Freeway答错了——Simon把它归因于这款游戏比较冷门。
Simon的评价是「令人佩服」,但他也指出代价是等待很久。在等待过程中,模型留下大量推理记录,手算第381个输入落在哪一格、算到一半回头修改。作者认为这种「重重预测」行为对几乎所有人来说实际上不可能,目前看起来像黑盒方法。不过Simon相信,有经验的人拿纸笔花够力气也能走到同样答案,他更倾向「苦功」这一边。
两个需要分开看的问题
Simon认为这篇论文混了两个题目:第一,模型不跑工具、不执行程式时,能拿原始权重做什么;第二,模型拿到程式之后,能多有效地更新和改进别的模型。他只追第一题,并觉得这题更有意思。
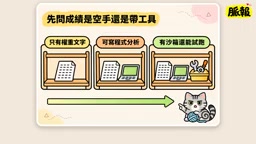
「卖爆」用「空手度」来区分各实验:猜游戏实验什么都不能跑,空手度最高;修改数学模型的实验里Astra可以写Python分析权重,但不准真正跑起网络,像拿着计算器研究设计图却不能发动试车;围棋实验中Astra有Python沙箱,权重能读能写,还能给试跑次数反复练习。
对你的工作意味着什么
论文作者预测,未来网络权重很快会由会推理的语言模型直接优化。Simon觉得这个方向很酷,但认为在外围评论站不住脚。他不准备宣告原始代码时代结束,也不接受「未来是看不懂的机器用看不懂的方式改自己权重」这种说法。
如果你担心现在学的方法很快被取代,这篇论文不必当成警报。「卖爆」的结论是:这周要改的工作方式一件都没有,要更新的是看AI成绩标题的眼光。
下次看到AI又做出惊人成绩,可以先问三个问题:
- 它当时手上有什么工具?
- 起点本来卡在哪里?
- 换一个对照模型还成立吗?
分数依然可以让人兴奋,但先把这三句问完。
相关推荐

Ollama选模型完全指南:从配置到量化避坑
Ollama选模型完全指南:从查看电脑配置到逛官方模型库,详解Tools、Thinking、Vision、Decision等标签含义,以及参数规模、量化精度与上下文缓存的取舍策略,助你避开卡死闪退的坑。

Ollama默认安全吗?显卡被白嫖的真相与自查指南
Ollama 默认只绑回环地址,但改一句环境变量或照抄 Docker 命令就可能让显卡暴露。本文解析显卡被白嫖的原理、扫描规模与 DNS 重绑定路径,并给出自查与修复的三层方案。

Cherry Studio+MCP实战:搭建自动化AI智能体与本地知识库
基于B站Cherry Studio教程,详解如何配置MCP环境、搭建网页抓取与报告生成等自动化AI智能体,并用Ollama+千问3搭建本地知识库,附实际操作中的踩坑经验。