GPT-6 Luna实测:性价比最高的干活模型
GPT-6 Luna以极低价格完成绝大多数任务,关键在于用对使用姿势:做执行者而非调度者。
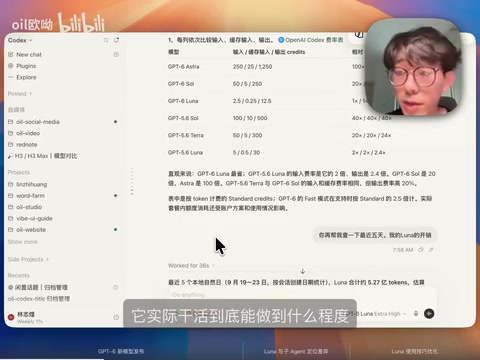
OpenAI新发布的GPT-6 Soul与GPT-6 Luna在性能上提升有限,但定价策略令人眼前一亮:三档模型(Astra/Soul/Luna)价格比例达1:20:100,Luna相比上代输入降价50%、输出降价58%。作者通过实测5亿Token、消耗仅3%额度,验证了Luna几乎能胜任PPT制作、视频剪辑、自动化发布、项目开发等日常主流任务。Luna唯一的短板是在长上下文场景下的Skill精准调用能力弱于高价模型,但浏览器自动化和Computer Use表现反而出色。更重要的认知是使用方式:Luna适合作为「执行者」接收明确指令,而多Agent调度和任务拆解建议交给Claude;同时可在项目级配置中将上下文窗口调至80万以获得更好体验,但需避免全局生效导致高价模型额度消耗过快。
GPT-6双模型发布,惊喜藏在价格里
GPT家族新增了两款模型——GPT-6 Soul与GPT-6 Luna。从实际表现看,顶配的GPT-6 Astra相较于GPT-5.6 Soul的能力提升并不算大,尤其在不涉及计算机自动化和建模的场景中差距更小。真正让人眼前一亮的,是这两款新模型的定价策略。
GPT-6 Luna的价格相比上一代GPT-5.6 Luna,输入便宜了50%,输出便宜了58%;GPT-6 Soul相比GPT-5.6 Soul也直接砍半。经过这轮调整,GPT-6三档模型(Astra / Soul / Luna)之间的价格比例已经拉开到 1 : 20 : 100。
这个比例意味着什么?简单换算一下——如果重度使用GPT-6 Astra只能坚持一天,那么换成GPT-6 Luna,同样的额度可以支撑约100天。对于按额度付费的用户来说,这几乎是数量级的差别。
5亿Token实测:Luna能干几乎所有活
作者本人正是被高额度消耗逼到了墙角。前几天重度使用GPT-6 Astra,用掉了两三张重置卡额度还不够,三四天前额度只剩4%。为了继续使用Codex(视频中称CloudX/Corel X),他把所有任务都切到了成本更低的Luna级模型来干活,顺便测试Luna到底能做到什么程度。
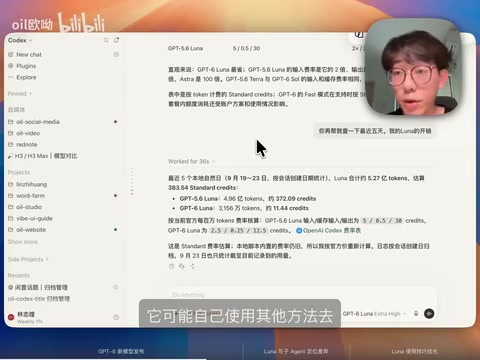
结果相当出乎意料。累计使用GPT-5.6 Luna加上GPT-6 Luna,大约消耗了5亿多Token,跑了三四天,额度才扣掉3%。更关键的是产出质量——Luna几乎能完成他此前用GPT-5.6 Soul做的所有事情:
- 制作PPT
- 视频剪辑加字幕
- 制作封面
- 自动化发布流程
- 一系列复杂Skill的修改
- 简单项目开发
- 新技术调研
作者坦言,很多时候根本感觉不出自己在用一个「低配」模型。比如前几天做某模型介绍,让Luna去做调研,整个流程非常流畅,没有明显掉链子的地方。
Luna的短板:长上下文下的Skill调用
唯一暴露Luna身份的场景,是当任务上下文过长、需要触发某个Skill时。此时Luna的指令遵循能力和上下文召回能力明显弱于Soul或Astra。
举例来说,一句含糊的命令,GPT-6 Astra或GPT-5.6 Soul往往能精准调用到正确的Skill;而Luna在上下文太长时召回不到之前Skill传入的信息,就会转而用其他方式硬完成任务(比如自己另想办法做封面)。这是它作为轻量模型必然存在的能力边界。
值得一提的是,Luna在浏览器自动化和Computer Use(计算机自动化操作)方面反而表现得心应手,且消耗极低——这一点打破了「便宜模型做不了复杂交互任务」的固有印象。
Skill(技能)在这里指AI工作流平台(如Codex)中预先定义的功能模块或工具调用接口,类似于函数或插件。当用户下达指令时,模型需要从已注册的Skill列表中识别并调用最合适的那一个,这要求模型具备准确的语义理解和上下文检索能力。随着对话轮次增加、上下文长度膨胀,较轻量的模型往往难以在海量历史信息中精准定位到之前传入的Skill参数,转而采用「自己想办法」的降级策略完成任务——结果是任务完成了,但不一定走了预期的路径,可能造成流程不可控或输出格式不符合预期。这是轻量模型在复杂自动化工作流中的典型能力边界,并非通用任务能力的缺失。
一个关键认知:Luna适合当执行者,不适合当调度者
作者过去对GPT-5.6 Luna印象不佳,复盘后给出了一个很有价值的判断:问题不在模型本身,而在使用方式。
此前他把Luna作为Codex里的子Agent来调用。而无论是GPT-6 Astra还是GPT-5.6 Soul,虽然编码能力强、长程任务执行出色,却存在一个通病——任务分配能力差、交流感弱、容易钻牛角尖。当用这类模型去派发子任务时,它无法宏观清晰地拆解业务,在没有人介入的情况下会派发出一堆乱七八糟的任务。这样一来,不管子Agent是Luna还是Astra,效果都不理想。
反过来,如果有人介入、把模型作为对话中的主力,用简单清晰的话直接下达具体任务,那么即便是Luna也能作为执行者干得很好。
结论很清晰:
- GPT系列更适合做「干活的执行者」
- 多Agent调度、任务拆解、编排这类工作,作者的经验是Cloud(Claude)比GPT做得更好
这是一个对多Agent工作流搭建者很实用的分工思路。
多Agent架构中「调度者」与「执行者」的分工是当前AI工程实践的核心议题。调度者(Orchestrator)负责理解用户意图、拆解任务、分配子任务并整合结果,要求模型具备强大的指令理解力、宏观规划能力和上下文连贯性;执行者(Executor/Sub-Agent)则只需在明确边界内完成单一具体任务,对规划能力要求较低,但需要稳定的指令遵循能力。Claude系列模型因其训练方式更注重对话质量与任务拆解的清晰度,在充当调度者时表现更稳;而GPT系列虽然编码和执行能力突出,但在自主规划和任务分发上容易出现「钻牛角尖」或任务边界混乱的问题。这一分工思路与业界「Router + Worker」的多Agent设计模式高度吻合,对希望搭建自动化工作流的开发者而言是非常实用的架构参考。
实用配置技巧:拉高上下文窗口
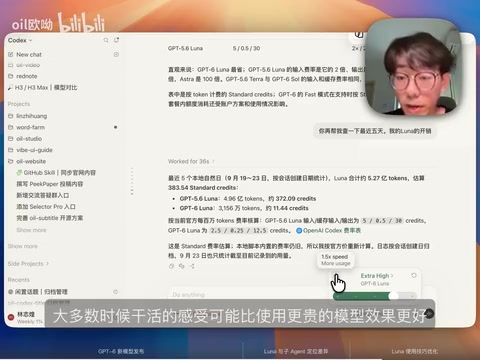
因为GPT-6 Luna成本极低,作者前几天甚至一直开着Extra High思考强度,偶尔还开Fast模式。到了GPT-6 Luna这一代,开销比GPT-5.6 Luna更低,完全可以长期开启Fast模式,实际干活体验有时比用更贵的模型还好。
最后一个值得收藏的tips:调高上下文窗口。Codex默认的上下文窗口偏小,可以在项目级别添加一个局部配置文件,指定默认模型为GPT-6 Luna,并把Model Context Window调到80万。
之所以强调用项目级而非全局配置,是为了避免副作用:一旦全局把上下文抬得很高,当你偶尔切到GPT-6 Soul或Astra时,可能一天就把全部额度用光。
上下文窗口(Context Window)指模型在单次对话或任务中能够同时处理的Token总量,直接影响模型在长文档处理、多轮对话记忆和复杂代码项目中的表现。窗口过小时,模型会「遗忘」早期输入的信息,导致Skill调用失败或逻辑断层;窗口足够大时,模型能持续感知整个任务上下文,减少重复澄清和错误累积。将GPT-6 Luna的上下文窗口调至80万Token,意味着即便是较大的代码库或多步骤任务,模型也能在单次运行中保持完整上下文感知。需要注意的是,更大的上下文窗口会消耗更多Token,对高价模型(如Astra)的额度影响尤为显著,这正是文中建议仅在项目级配置而非全局生效的原因。
谁最该用GPT-6 Luna
对于200美元档订阅的用户,GPT-6 Luna当前价格基本等于无限使用。而作者认为真正的利好群体是GPT-Plus用户——凭借极低的单位成本,这个模型能撑很长时间。
经过多天重度使用,作者给出的最终判断是:GPT-6 Luna足以胜任日常大多数任务。如果你的工作流以「明确指令下的执行」为主,而非依赖模型自主调度多Agent,那么用Luna替代高价模型,几乎是当前最划算的选择。
相关推荐
GPT-6 Sol与Luna实测:建模、游戏、写作全面对比
B站UP主实测GPT-6 Sol与Luna Max在3D建模、小游戏、写作三大场景的表现,并与Opus 5.5横向对比。Sol降价带来Codex额度利好,但创意生成能力仍不及Opus 5.5,Luna小模型也有清明上河图贴图惊喜。
GPT-6 Soar对比GPT-5.6 Soar实测:更快更省的真实差距
GPT-6 Soar与GPT-5.6 Soar实测对比:从SVG绘图、代码理解到3D场景生成,记录耗时、额度消耗与完成质量。简单任务难分高下,复杂任务中GPT-6 Soar在速度、成本和方位准确性上明显占优。
GPT-6攻克孪生素数猜想新上限:从张益唐到AI的接力
GPT-6在孪生素数猜想上取得突破,将相邻素数间隔上限压缩到186。本文梳理孪生素数猜想的百年历程,从哈代猜想、GPY定理到张益唐7000万的传奇突破,再到陶哲轩、施塔德尔曼与AI的接力压缩。