GPT-6 Soar对比GPT-5.6 Soar实测:更快更省的真实差距
用SVG绘图、代码理解、3D城市生成三类任务实测GPT-6 Soar vs GPT-5.6 Soar,结论:差距只在复杂任务中显现。
本文记录了B站UP主对GPT-6 Soar与GPT-5.6 Soar的对比实测,从耗时、额度消耗、完成质量三个维度评估两代模型的真实差异。SVG绘图等简单任务中,两款模型完成度趋同,代际差距被能力天花板掩盖;代码理解任务中,GPT-6 Soar表达更精炼,速度约为前代一半,成本也更低;3D长沙城市场景生成是差距最大的场景——GPT-5.6 Soar耗时近45分钟、消耗65%额度却出现地理方位完全颠倒的结构性错误,而GPT-6 Soar仅用26分钟、31%额度完成了方位准确、交互完整的成品。综合结论是:官方「更快、更强、更便宜」的说法在复杂任务上有据可查,但测试样本有限、评判带有主观性,结论仅供参考。
OpenAI发布的GPT-6 Soar和GPT-6 Lula两款模型,官方宣称比GPT-5.6 Soar「更快、更强、更便宜」。但在此前的实测中,仅凭截图复刻网站这类简单任务,两代模型的完成度几乎没有差别——因为这个场景已经触及能力天花板,测不出真实差距。于是B站UP主换了一批更有区分度的任务重新测试,从耗时、额度消耗、完成质量三个维度记录数据,试图还原两代模型的真实差异。
简单任务:差距被天花板掩盖
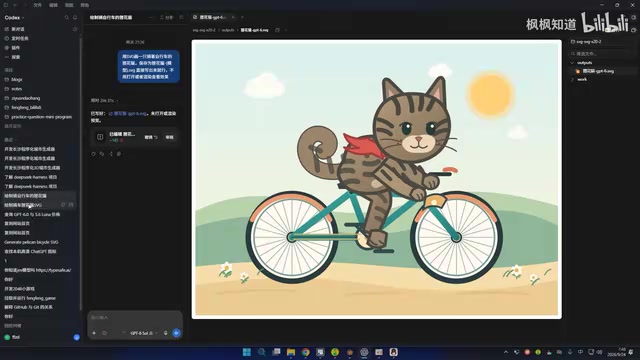
第一个测试项是「SVG画一只骑自行车的梨花猫」(原题是提壶骑车,为规避模型的记忆识别做了改写)。这类任务足够简单,两个模型都能完成,主要看视觉呈现的精细度。
从结果看,GPT-6 Soar画出的梨花猫在细节上略胜一筹,观感更好一些。但两者耗时几乎相同,都在两分多钟。额度消耗方面,GPT-5.6 Soar几乎可以忽略不计,GPT-6 Soar消耗约1%——UP主认为这1%更可能是统计误差,而非真实的成本差异。
这类任务的问题在于:当两个模型都能轻松完成时,能力上限被拉平,很难看出代际提升。这也解释了为什么上一期视频引发争议——不少观众质疑GPT-6 Soar「更强」的说法缺乏依据。要验证代际差异,必须用更复杂、更接近能力边界的任务。
代码理解:谁更「通俗易懂」
第二个测试是让模型熟悉GitHub上的项目(使用了Lipstick Harness这类项目),要求用最通俗的语言说明「这个项目是做什么的」以及「学习该从哪里入手」。这里的评判标准不是把项目讲得多透彻,而是能否把事情讲清楚、让人一看就懂。
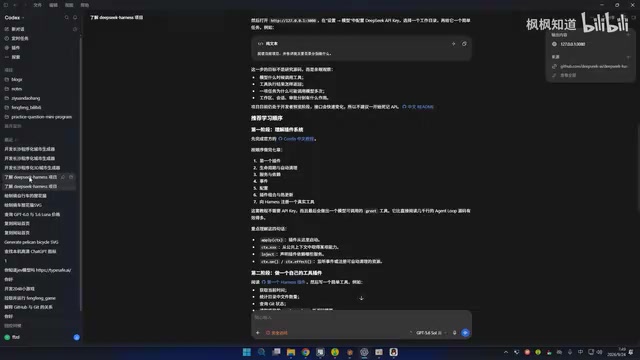
GPT-5.6 Soar给出的说明较长、内容详尽,但表述相对繁复;GPT-6 Soar则用一句话说清项目用途,并给出简洁的学习建议。从「通俗易懂」这个维度上,GPT-6 Soar的表达更精炼。
耗时和成本对比更能说明问题:GPT-5.6 Soar用了3分4秒、消耗3%额度;GPT-6 Soar仅用1分14秒、消耗2%额度。同样的理解质量下,新模型的响应速度接近前代的一半,成本也更低。这印证了官方「更快、更便宜」的说法——至少在中等复杂度的代码理解任务上是成立的。
3D场景生成:方位准确性成关键
真正拉开差距的是第三个测试——3D城市层次生成器。同一套提示词,两代模型分别用不同强度档位生成一个包含橘子洲头、岳麓山、五一广场等长沙地标的3D城市场景。
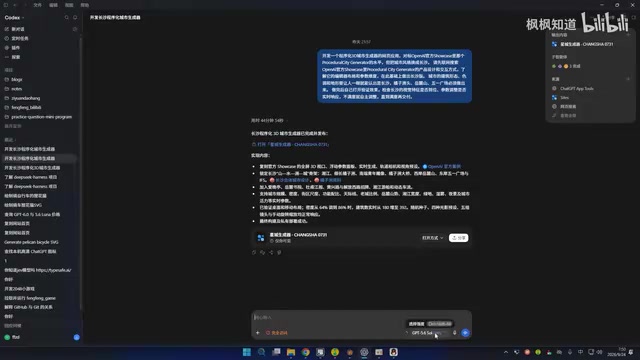
GPT-5.6 Soar(使用Auto档)的成品第一眼看上去还不错,城市总览、地标分布都有模有样。但仔细核对方位就会发现致命问题:整个地理方位被搞反了。按照橘子洲头的实际位置推算,岳麓山和五一广场的相对方向完全颠倒。UP主指出,配色、楼高这些细节都可以后期调整,唯独方位错误是结构性的硬伤。
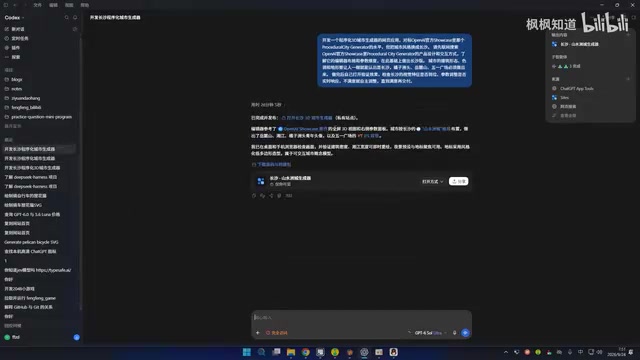
GPT-6 Soar(使用Ultra强度)在同样的提示词下,把地理方位搞对了——以橘子洲头为基准,左边是岳麓山、右边是五一广场,符合真实地理关系。成品还提供了天气切换(晴天、夜晚、暮色)、城市规模、平均楼高、湘江宽度、绿地覆盖、阳光高度等可调参数,交互完整度更高。
耗时与成本对比同样悬殊:GPT-5.6 Soar(Auto档)耗时44分54秒、消耗65%额度;GPT-6 Soar(Ultra档)耗时26分5秒、消耗31%额度。也就是说,新模型不仅结果更准确,还用更短的时间和不到一半的额度完成了任务。
3D城市层次生成器(3D City Layer Generator)是一类基于代码(通常为 HTML/JavaScript + Three.js 或 WebGL)的程序化场景生成任务,要求模型根据文字描述输出可运行的三维城市可视化程序。这类任务对模型的能力要求是多维叠加的:既要理解地理拓扑关系(哪个地标在哪个方向),又要生成结构正确、可执行的三维渲染代码,还要实现交互参数(如天气切换、楼高调节)。正因如此,它是检验大模型「空间推理 + 代码生成」综合能力的高区分度场景——任何一个环节出错,最终产物都会出现肉眼可见的结构性错误,而不像纯文本任务那样错误容易被模糊表达掩盖。Auto档与Ultra档的区别,通常对应模型在生成过程中投入的推理深度与迭代次数,Ultra档一般会消耗更多算力换取更高质量输出。
实测结论:差距藏在复杂任务里
综合三轮测试,可以得出几个清晰的结论:
- 简单任务看不出代际差距,因为两代模型都已触及能力天花板,视觉和完成度趋同;
- 中等复杂任务开始显现优势,GPT-6 Soar在代码理解上表达更精炼,速度和成本明显占优;
- 复杂任务差距最大,在3D场景生成中,GPT-6 Soar不仅在方位准确性等结构性问题上胜出,还在耗时和额度消耗上大幅领先。
这也回应了上一期视频的争议:GPT-6 Soar「更强」的说法在简单场景下确实难以验证,但一旦任务复杂度提高,代际提升就变得可感知。对于依赖大模型完成复杂生成任务的用户来说,速度更快、成本更低、结构准确性更高,这三点叠加起来的实用价值不容忽视。
需要说明的是,本文测试为单一UP主的实测记录,样本数量有限,评判标准(如「通俗易懂」)也带有一定主观性,结论仅供参考。真正的能力评估还需要更系统、更大规模的基准测试来支撑。
「能力天花板效应」在大模型评测中是一个常见陷阱:当任务难度低于模型的能力下限时,所有模型都能轻松完成,横向比较失去意义;当任务难度高于模型的能力上限时,所有模型都会失败,同样无法区分优劣。真正有区分度的评测需要将任务难度控制在「部分模型能完成、部分不能」的区间内,即所谓的「甜蜜区」。这也是为什么学术界的标准基准测试(如 MMLU、HumanEval、MATH)会持续迭代更难版本——随着模型能力提升,旧基准会逐渐饱和,区分度下降。本文测试从简单到复杂的任务设计,在一定程度上复现了这一逻辑,但系统性仍不足,复杂任务仅有一个样本,结论的稳健性有待更大规模测试验证。
相关推荐
GPT-6 Sol与Luna实测:建模、游戏、写作全面对比
B站UP主实测GPT-6 Sol与Luna Max在3D建模、小游戏、写作三大场景的表现,并与Opus 5.5横向对比。Sol降价带来Codex额度利好,但创意生成能力仍不及Opus 5.5,Luna小模型也有清明上河图贴图惊喜。
GPT-6 Luna实测:性价比最高的干活模型
GPT-6 Luna实测评测:价格比GPT-5.6 Luna再降50%以上,5亿Token只扣3%额度。本文分享Luna的实际干活能力、Skill调用短板、执行者定位以及上下文窗口配置技巧,帮你找到性价比最高的AI模型使用方式。
GPT-6攻克孪生素数猜想新上限:从张益唐到AI的接力
GPT-6在孪生素数猜想上取得突破,将相邻素数间隔上限压缩到186。本文梳理孪生素数猜想的百年历程,从哈代猜想、GPY定理到张益唐7000万的传奇突破,再到陶哲轩、施塔德尔曼与AI的接力压缩。