GPT-6 Sol对决Opus 5.5实测:价格砍半,编码能打吗?

GPT-6 Sol以半价挑战Opus 5.5,但实测完成度与长周期任务中差距明显,隐藏修复成本抵消价格优势。
OpenAI的GPT-6 Sol与Anthropic的Opus 5.5几乎同期发布,两者定价相差一倍(输入2美元 vs 4美元/百万Token)。第三方基准Artificial Analysis显示Opus全面领先,单次评估成本约为Sol的5.4倍。在UP主自建的KingBench 3八项测试中,Opus以93.75%对82.5%胜出,差距主要来自3D建模穿模、交互机制缺失等完成度问题;四个长周期应用开发任务中Opus几乎全面胜出,尤其在前端呈现和功能完整性上表现突出。UP主的核心结论是:Sol赢在单价,Opus赢在完成度,而"修复结果所需的额外时间"这笔隐藏成本往往被忽略——对追求一次到位的开发者,Opus 5.5是当前更稳的选择;对预算优先、任务边界清晰的批量场景,Sol仍有竞争力。
OpenAI推出的GPT-6 Sol与Anthropic的Opus 5.5几乎前后脚发布,两者都主打编程与Agent场景,但走的路线截然不同:一个把价格砍到对手的一半,另一个继续在复杂任务上堆能力。一位B站UP主用自建的KingBench 3基准做了一轮系统实测,从电梯模拟到3D隐形眼镜盒,再到长周期应用开发,给出了相当直观的结论。
定价与规格:Sol的性价比牌
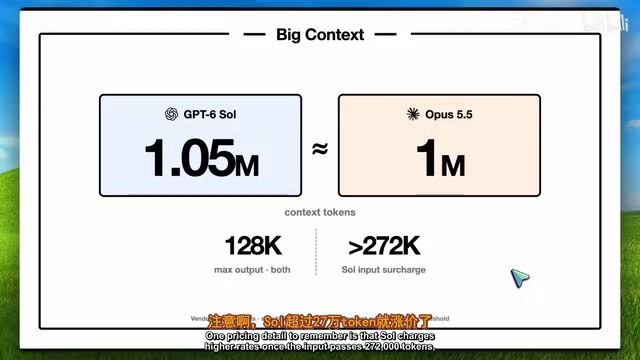
这轮对比里,价格是GPT-6 Sol最有杀伤力的一张牌。按UP主整理的数据,Sol标准输入约为每百万Token 2美元、输出10美元,恰好是上一代GPT促销价的一半;而Opus 5.5的API定价约为每百万输入4美元、输出20美元,正好是Sol的两倍。两者的缓存读取都压到了每百万0.2美元的水平,对于Agent反复读取同一份说明和上下文的场景,重复请求的成本能明显下降。
上下文方面,两者都在百万级别徘徊,标准配置下的有效上限则各有差异(Sol约128K、更高档位可达更大区间)。OpenAI宣称Sol在内部SLA测试中的犯错率只有其他模型的一半、稳定性翻倍;Anthropic则称Opus 5.5比上一代快30%以上,默认设置下可省约40%算力。这些都是厂商自测数据,方向可参考,但不宜当作绝对结论。
第三方基准:Opus领先但成本高
在Artificial Analysis的智能指数(4.32版)中,两者差距被拉开。GPT-6 Sol中档得约40分,Opus 5.5中档51分;全力档下Sol约58分,Opus依旧领先。更关键的是成本对比——Sol每次评估约0.25美元,Opus约1.34美元,Opus单次评估成本约为Sol的5.4倍。需要说明的是,Opus的评估条目里还包含安全机制触发时回退到其他Claude模型的开销,且不同供应商的“中档”并不代表相同算力,横向数字仅供参考。
单项测试进一步印证了Opus的能力优势:
- Terminal Bench 4.0(中等强度):Opus 53% vs Sol 19%,编码类终端任务差距巨大
- CICS/编码类:Opus 59% vs Sol 54%
- 人类考试类:Opus 55% vs Sol 41%
- Automation Bench:Opus 61% vs Sol 58%,这里差距最小
整体看,公开数据里Opus表现更强,而Sol的核心优势集中在成本端。
Terminal Bench 是专门评估大语言模型在命令行/终端环境下完成编程任务能力的基准测试,任务通常包括调试脚本、修复代码错误、操作文件系统等,得分反映模型在"真实开发者工作流"中的实际可用性,而非单纯的代码生成能力。53% vs 19% 的悬殊差距意味着在这类场景下,Opus 5.5 能独立完成的任务数量接近 Sol 的三倍,对于以 Agent 方式自动化执行终端任务的开发者来说,这是一个实质性的能力鸿沟而非微小差异。
Automation Bench 则侧重评估模型驱动多步骤自动化流程的能力,例如跨工具调用、状态追踪和错误恢复,这与 Agent 场景直接相关。两者在这一项上差距最小(61% vs 58%),暗示 Sol 在结构化自动化流程上的短板相对较小,更多的差距集中在需要创造性判断和复杂推理的任务上。
KingBench 3实测:完成度决定胜负
UP主的KingBench 3包含八项任务,每项满分10分,两个模型都用中等力度运行。结果显示,完成度和交互细节成了拉开差距的关键。
在3D隐形眼镜盒任务中,Opus做出了带盖子、内含隐形眼镜的完整模型,细节到位;Sol(走Codex路线)的建模则出现盖子穿模、部件互相穿透的问题,直接影响可用性,最终Opus 10分、Sol仅6分。弓箭模拟器同样明显——Sol版本箭矢没有弧线、机制过于简单,Opus则加入了更复杂的互动机制,9分对6分。
不过Sol并非全面落后。在熊猫SVG图、组合数学题、Panda数据集微调等任务上两者打平,各得满分;尤其是熊猫数据集任务,是Sol表现最亮眼的一项。

最后的3D手表任务中,两者都做出了带指针、日期、星期和双时区的完整时钟,各得10分——UP主此前常吐槽Codex,但这次四道相关题它全对。
八项累计,Sol得66/80(82.5%),Opus得75/80(93.75%),领先11.25个百分点。在UP主现用的KingBench 3榜单上,Opus 5.5排名居首,超过了Fable 5.1、GRM 5.3乃至GPT-6本体。
长周期任务:Opus的完胜区
UP主还单独设计了四个“Long Horizon”长提示任务,考察模型处理多数据、构建完整应用的能力,这部分与八项评分分开计算。
第一个是基于TMDB接口的终端电影追踪器。Sol版本出现字号问题、海报加载不出来,而海报渲染本是核心功能,整个应用像没做完;Opus版本功能正常、体验完整,差距相当明显。第二个海报生成打印APP中,Sol再次回到那种“千篇一律的AI风格”前端,Opus的视觉呈现更讨喜,不过这次差距没有电影追踪器那么大。
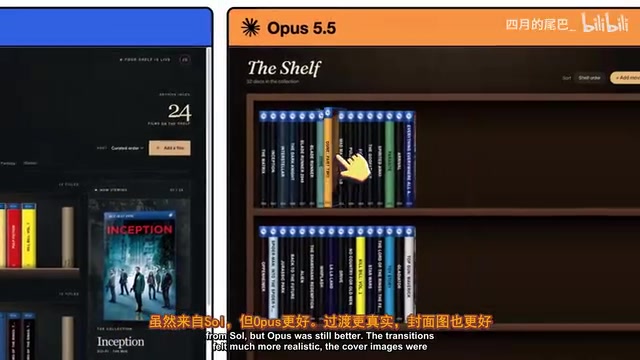
3D蓝光合集任务里,Sol其实做得不错,3D位置和实用性都到位,UP主也给了肯定;但Opus的过渡更真实、封面图更清晰、细节运用更到位,被UP主称为“前端界面的王者”。最后的现代版Obsidian仿制品(含Markdown、动画、OpenCode SDK Agent)中,Sol功能齐全不算烂尾,但视觉又回到通用风格,Opus整体更接近预期。四个长任务,Opus基本完胜。
"Long Horizon"(长周期)任务是当前 AI 评估领域的一个重要维度,指需要模型在单次对话中维持长时间、多步骤的连贯工作,例如从需求分析、接口设计、前端实现到错误处理全链路完成一个可运行的应用。与单一问答或代码片段生成不同,长周期任务会放大模型在中途"迷失"或遗忘早期约束的缺陷——越复杂的任务,越容易在后期出现功能遗漏、风格前后不一或关键特性缺失的问题。这也是为什么即便在短任务上两者差距可控,在这四个长任务中 Opus 几乎全面胜出:更强的指令跟随能力和更高的完成度,在任务链条变长后会形成复利效应。
该怎么选?修复成本才是隐藏账单
UP主的最终结论很务实:做这类开发工作,他个人更偏好Opus 5.5,因为总能拿到更完整的结果,省下大量后期修复时间。他强调选工具看的不只是哪张截图更好看——Opus的电梯模拟并不惊艳,但机制好用;Sol的蓝光APP整体浑然一体,也值得肯定。
对Sol的价格,UP主并不否定其吸引力:如果任务简单、需要通过API批量跑、成本敏感,Sol的半价确实值得考虑。但他也点出关键——当前端不达标或漏掉关键互动时,再便宜的Token也帮不上忙,因为修复结果要花更多时间,而这笔“总修复成本”往往没被算进对比里。
换句话说,Sol赢在单价,Opus赢在完成度和稳定性。对追求一次到位、减少返工的开发者,Opus 5.5是当前更稳的选择;对预算优先、任务边界清晰的批量场景,Sol的性价比仍有一战之力。
"总修复成本"(Total Cost of Repair)是软件工程中评估工具实际价值时常被忽视的维度,指开发者在获得模型输出后,为使其达到可用状态所需投入的额外时间和精力。在 API 定价对比中,通常只计算 Token 消耗;但如果输出结果存在穿模、功能缺失或前端不达标,开发者需要额外调试、重新提示甚至手动修改,这部分时间成本在批量任务或紧急交付场景下可能远超节省的 Token 费用。这一视角将模型选型从"每百万 Token 多少钱"转向"完成同等质量的工作实际花了多少",对于追求开发效率的团队,后者才是更贴近实际的衡量标准。
相关推荐

Opus 5.5实测:一个Skill把PDF变成交互式动画电子书
开发者基于 Claude Opus 5.5 打造开源 Skill「Papermorph」,通过 PDF→规划→分镜→旁白→动画测验的流水线,把静态 PDF 自动转化为带交互测验的动画网页电子书,且暂未使用图像模型。本文拆解其工作流与技术亮点。

Perplexity押注垂直整合:Vera芯片替代x86背后的Agent基建野心
Perplexity宣布垂直整合其智能体基础设施,自建沙箱并押注Vera架构替代x86,开始部署Perplexity Computer。本文解析这一战略背后的技术逻辑与行业意义。

Extra Big Ass Intelligence:一场对AI炒作的幽默反讽
Extra Big Ass Intelligence是一个在Hacker News走红的恶搞项目,用幽默反讽调侃AI行业的过度炒作与命名通胀,引发技术社区对AI营销泡沫的集体反思。