GPT-6模型怎么选?四档策略打败15种组合

用Intelligence与真实成本两个维度,将GPT-6的15种模型档位组合简化为四个实用选择。
面对GPT-6三个主力模型(Astro、Soar、Lula)各五档推理强度所形成的15种组合,本文基于第三方评测平台Artificial Analysis的Intelligence综合指数与真实任务成本数据,提炼出四个核心档位:日常任务用Lula Max(Intelligence 37,仅0.07美元),稍有难度的任务用Soar High,真正的硬核难题交给Soar Max,关键方案的审核与debug则使用Astro Media。选择升级的唯一判断标准是能否带来Intelligence的质变——价格上涨却智能几乎不动,则升级毫无意义。这套框架提供了一个可复用的决策逻辑,而非一个绝对答案,具体取舍仍需结合个人场景持续验证。
15种选择的困境
GPT-6系列的三个主力模型——Astro、Soar、Lula——全部发布之后,很多人面对的第一个难题不是能力够不够用,而是选哪个。每个模型都提供五档推理强度,三个模型乘以五档,就是整整15种组合。日常使用时,没人愿意在每次提问前对着15个选项反复权衡。
这篇指南给出的方案很直接:抛开复杂的决策树,只保留四个真正有用的档位。日常任务用 Lula Max,需要思考和规划的用 Soar High,真正的难题交给 Soar Max,而关键方案的审核与 debug 则留给 Astro Media。这套结论并非凭感觉拍脑袋,而是建立在第三方评测数据之上。
数据从哪里来
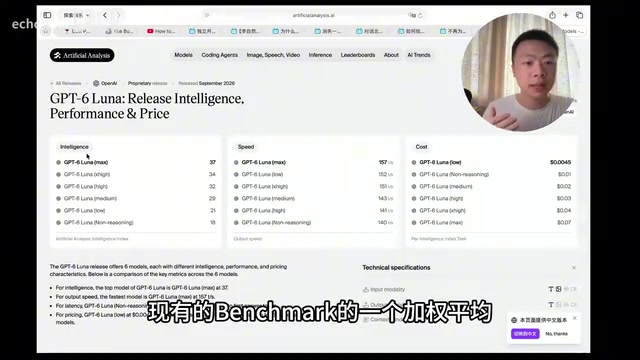
整套选择逻辑的核心依据来自 Artificial Analysis 这个第三方评测平台。它提供两个关键指标:Intelligence 和 Cost。
Intelligence 指数并不是单一测试的结果,而是对一系列现有 Benchmark 做加权平均得到的综合分数,可以粗略理解为模型的整体智能水平。Cost 的计算方式则更贴近真实场景——它不是直接套用 API 的标价,而是让模型去完成一系列真实任务,统计任务实际完成所消耗的 Token,再折算成价格。这意味着一个单价高但效率高的模型,综合成本未必真的贵。
把 Intelligence 和 Cost 两个维度,结合各模型的不同档位画在一张图上,模型之间的性价比关系就一目了然了。
Artificial Analysis 是一个专注于 AI 模型独立评测的第三方平台,其核心价值在于提供不依赖模型厂商自述的横向比较数据。它的 Intelligence 综合指数整合了 MMLU、HumanEval、MATH 等多个学术与工程 Benchmark 的得分,通过加权平均消除单一测试的偏差。这种方法的局限在于,Benchmark 成绩与真实业务场景的相关性并不总是线性的,但作为跨模型横向比较的基准,已被业界广泛引用。Cost 指标的设计则尝试弥补另一个常见误区:API 标价往往按百万 Token 计费,但不同模型完成同一任务所需的 Token 数量差异显著——一个需要大量"思考 Token"的推理模型,哪怕单价便宜,实际账单可能远高于预期。Artificial Analysis 通过统一任务集测量实际 Token 消耗,使成本比较回归真实使用场景。
四个档位的拆解
Lula Max:性价比之王
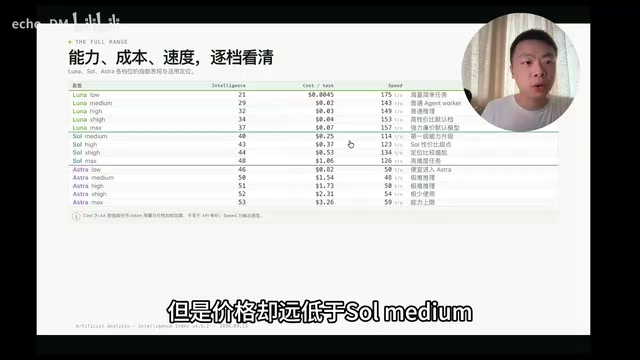
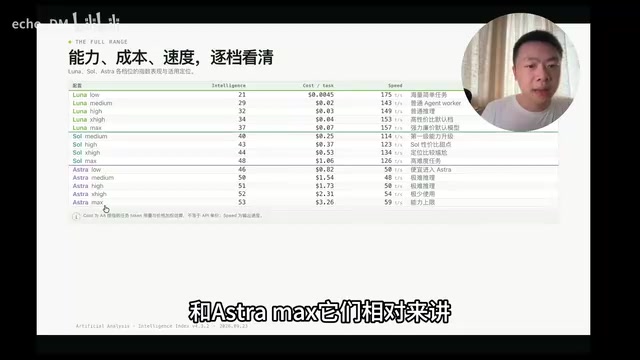
Lula Max 的 Intelligence 为 37,价格仅 0.07 美元。它的智能水平远高于 Lula 系列的其他档位,和 Soar Media 基本持平,但价格却远低于后者。对于绝大多数日常任务来说,这个档位已经完全够用,而且花费极低。换句话说,日常场景根本没必要动用更贵的选项。
Soar High:中间的过渡选择
当任务稍有难度、需要一定思考却又不至于是硬核难题时,Soar High 是合适的中间档。它的 Intelligence 介于 Lula Max 和 Soar Max 之间,表现尚可,而价格只有 0.37 美元,远低于 Soar Max 的 1.06 美元。它填补了从日常到高难度之间的空白地带。
Soar Max:真正难题的解法
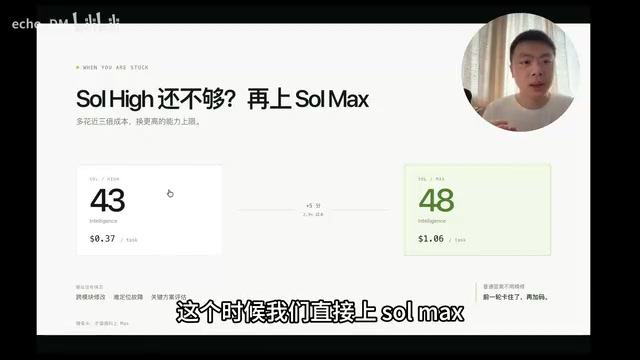
从 Lula Max 到 Soar Max,Intelligence 出现了一次明显的质变,直接高出约十分。代价是价格也随之翻了好几倍。正因如此,Soar Max 不该被日常滥用,而应该专门用来攻克那些 Lula Max 和 Soar High 都搞不定的真正困难的问题。
所谓"推理强度档位",本质上是对模型生成答案前内部"思考步骤"深度的调节。OpenAI 等厂商通常通过控制思维链(Chain-of-Thought)的长度或强化学习训练出的"慢思考"模式来实现这一机制——更高档位意味着模型会花费更多计算资源在回答前进行自我推敲和验证,因此 Token 消耗和延迟都会相应增加。这也解释了为什么同一基础模型的 Max 档与 Low 档在 Intelligence 上会产生可测量的差距:提升的不是模型权重本身的能力上限,而是每次推理时实际调用的计算深度。理解这一机制有助于判断何时值得付出更高成本——对于有明确答案的事实性问题,额外的推理深度收益有限;而对于需要多步推导、假设验证的复杂问题,高档位的价值才能真正体现。
Astro Media:审核与 debug 专用
从数据对比看,Soar Max 的 Intelligence 其实高于 Astro 系列的 load 档位,相应价格也更高。而 Astro Media 和 Astro Max 之间,每提升一个推理档位,Intelligence 的涨幅都不算大。对大部分人而言,遇到需要对关键信息复核审查、或是 debug 挑错的场景,直接用 Astro Media 就足够,没必要再往上堆推理强度。
升级逻辑:看有没有质变
把上面的结论串起来,升级路径其实非常清晰:
- 日常任务 → Lula Max
- 任务稍有难度、需要思考 → 升到 Soar High
- Soar High 也搞不定的真正难题 → 直接上 Soar Max
- 关键方案复核、挑错、debug → 交给 Astro Media
对多数人来说,日常使用其实只在 Lula Max 和 Soar High 两档之间切换,Astro 系列并不常用。
选模型和选推理档位最关键的判断标准只有一个:这个升级能不能带来质变。如果升一档只是价格涨了而智能几乎没动,那就没有升级的意义;只有当 Intelligence 出现明显跃升时,才值得为更高的成本买单。Lula Max 到 Soar Max 的那一跳,正是典型的质变节点。
写在最后
这套方案建立在 Artificial Analysis 的公开数据之上,同时结合了实际使用体验。它的价值不在于给出一个绝对正确的答案,而在于提供一个可复用的决策框架——用 Intelligence 与真实成本两个维度去衡量每一次升级是否划算,而不是盲目追求最强模型。不同人的使用场景差异很大,具体档位的取舍仍值得在实践中持续验证和调整。
相关推荐

iPhone Duo续航实测:一天一充跑不掉,大屏是耗电元凶
iPhone Duo续航实测:重度使用一天需至少充电一次,6.5小时亮屏约剩30%电量。大屏展开频率是耗电关键,MagSafe电池背夹可救场,长期衰减同样值得关注。

Kimi K3.1 Pro开源发布:2.8万亿参数逼近Opus
Moonshot发布开源MoE模型Kimi K3.1 Pro,2.8万亿总参数、1040亿激活参数,Terminal Bench 4.0仅落后Opus 5.5不到1分,单任务成本约三分之一,API价格减半,开源权重11月4日开放。

Costco科技产品价格竞猜:显示器、键鼠、Bose音响值不值?
YouTube博主在Costco竞猜科技产品价格:2K 180Hz显示器、罗技键鼠、Bose音响和CyberPower UPS实测估价,揭示仓储会员店的选品定价逻辑与品牌溢价真相。