GPT-Next泄露、Gemini 4 Argon提速,Fable 5.5或今日发布

OpenAI、Google、Anthropic密集更新,GPT-Next泄露与订阅性价比成焦点
本周AI圈更新密集:OpenAI的GPT-Next早期Alpha版意外泄露,部分测试优于GPT-6.1,且早期数据显示推理成本可能极低,或将成为Tibo“28天连续发布计划”的一环,首日已把GPT-6 Extra与6.1 Soul提速约50%。Google内部Gemini 4 Argon测试加快、可能提前发布,NanoBanana 2.1已上线但表现中规中矩,RSI传闻仍只是推测。Semi Analysis实测显示200美元档Claude Max的等效API价值约为ChatGPT Pro的5倍,但API成本不等于订阅优劣。此外OpenAI将在欧盟推出TextScreen文本水印,ReflectionAI发布5010亿参数MoE开源模型BIM,Claude Code与Projects也有实用更新。
OpenAI的"28天连续发布"计划刚拉开帷幕,一个名为GPT-Next的神秘模型就提前泄露;Google的Gemini 4 Argon内部测试节奏加快,NanoBanana 2.1已悄然上线;Anthropic的Fable 5.5则可能随时开放。这一周AI圈的更新密度,比很多人预期的要高。
OpenAI:GPT-Next泄露与28天发布计划
GPT-Next的曝光方式颇为意外——因为生成内容的速度异常而被外界注意。据B站UP主的分析,这个模型目前仍是早期Alpha版本,但在部分测试中表现优于GPT-6.1,差距不算巨大,却能感受到投入度和创造力上的细微差异,尤其在3D环境搭建和网络开发任务中较为明显。
真正让这个模型值得关注的是成本。早期预估显示,约4万积分可提供约50亿次元(含缓存次元)。如果这组数据成立,GPT-Next将是一个极其高效的检查点,很可能作为OpenAI产品经理Tibo所承诺的"28天发布计划"的一部分推出。
Tibo在X上宣布,未来28天OpenAI每天至少推出一项重要改进,方向集中在四件事:简化产品、提升效率、增加使用限制的合理性、发布新模型。第一天的动作已经落地——GPT-6 Extra与6.1 Soul默认速度提升约50%,从每秒30词元提到50词元,使用ChatGPT登录的合作伙伴(OpenCode、Pi、Amp、Devin等)同步受益。
这里有个值得玩味的背景:Anthropic的新模型在效率和额度上正给OpenAI施加压力。Tibo的"28天挑战"与其说是产品节奏,不如说是对竞争态势的正面回应。至于他发帖称"6.1将至",随后澄清指的是6.1 Soul的快速版而非已取消的6.1 Extra——这个细节说明OpenAI的模型命名体系本身正在经历一轮梳理。
关于“次元”与“积分”计费口径
文中反复出现的“次元”(token 的谐音)即大模型处理文本的基本单位,一个英文单词约对应 1–2 个 token,中文则通常按字计算。“积分”则是 OpenAI 面向部分产品线(如 API 或特定订阅层级)的预付费计量单位,用户先充值积分,再按调用量扣减。所谓“4 万积分可提供约 50 亿次元”,本质是在描述单位积分的产出效率,即每积分约可换取 12.5 万 token 的推理量。若该数据成立,意味着 GPT-Next 在推理成本上比现有模型低一个数量级,这正是“极其高效的检查点”的含义。需要提醒的是,这类早期泄露的换算数据往往来自非官方测试环境,缓存命中率、上下文长度和输出长度都会显著影响实际消耗。
Google:Gemini 4 Argon提前,NanoBanana 2.1上线
Google内部服务器的活动明显增多,多个新内部模型名(含LSP与Barium检查点)出现在日志中。这些是不同配置的测试版本,包含修复、摘要和实验性变体,推进速度很快。
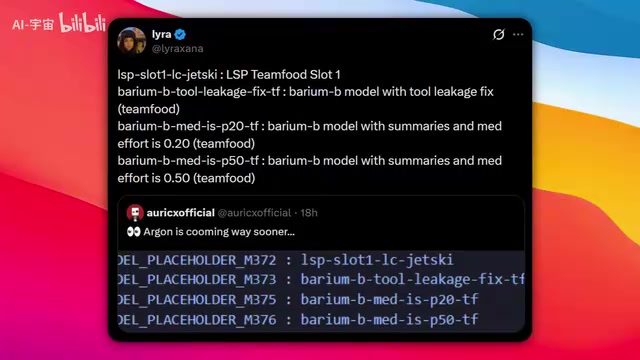
从现有基准表现看,质量差异已经相当显著,但日志中没有迹象表明这是Ergon之上的又一次重大更新。结合测试推进的密度,模型公开发布的时间可能比预期更早——甚至就在本周。一个可供参考的演示:同一款Gemini 4 Argon在模拟信用卡交易的SVG测试中击败了Fable 5.5,生成的界面包含付款、打印收据和小段动画。
NanoBanana 2.1则已经出现在Gemini网页版和移动应用中。它的发布过程相当混乱:最早的检查点是Instant Ramen,6月在Arena出现时被认为是NanoBanana 2 Lite;8月发布Instant Ramen 2,预计命名为NanoBanana 2.5 Lite;两天后检查点改名为Spicy Mayo;9月合作伙伴通过Vertex访问时标示为NanoBanana 2.5;10月2日移动应用中出现GemPix图像生成器。最终网页版和移动应用里的NanoBanana 2.1,用的都是同一个GemPix2 Flash ID——Google不仅改了版本号,还把它从Lite分类改成了Flash。
实测表现只能说中规中矩。在与腾讯HY Image 3.5的对比测试中,两个模型收到5个相同查询、各一次机会、不做编辑,NanoBanana 2.1在保持角色与原图相似度上明显更好,一致性扎实;HY Image 3.5则在光照氛围和整体情绪上更胜一筹,创意功能更多。NanoBanana 2.1还出现过完全忽略"不要添加文字"指令的问题。价格方面,HY Image 3.5每张2K图像约2美分,NanoBanana 2.1通过Google Flow运行则消耗订阅积分。
RSI传闻:巧合还是信号
关于Google进行递归自我改进(RSI)实验的传闻,最初被认为是假的,但日志中确实出现了神秘的新内部模型标记。这不足以证明Google解决了RSI问题——仅凭内部模型或占位符说明不了什么,可能只是个名字,也可能是某种模拟。
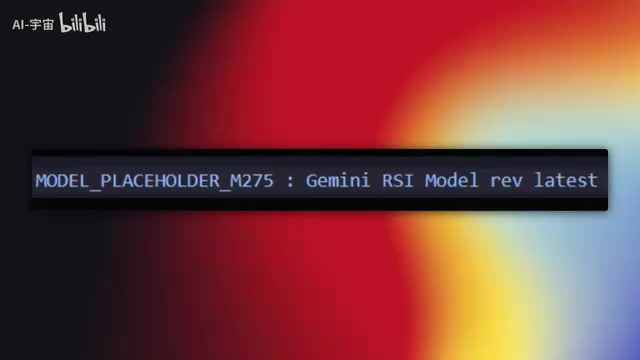
但结合Google近期的模型开发速度,这个发现补上了一块拼图:如果存在某种能加速模型迭代的系统,它或许能解释为什么Google能在短时间内推进这么多变体。这只是推测,不是结论。
什么是“检查点”(Checkpoint)与 Arena 测试
在大模型开发流程中,检查点指训练过程中周期性保存的模型权重快照。团队会在不同检查点上做评测、对齐和内部试用,因此日志里出现多个命名各异的检查点,通常说明模型正处于密集迭代阶段,而非已经定稿。文中的 Instant Ramen、Spicy Mayo 等代号,就是 Google 给不同训练阶段或不同配置变体起的内部名称。
Arena 指 LMArena 一类的大模型盲测竞技场:用户对两个匿名模型的回答投票,模型以代号形式出现。新模型常先在 Arena 上匿名试跑,收集人类偏好数据后再正式发布,因此“在 Arena 出现”往往被视为发布临近的信号。这也是文中据检查点改名、出现在 Arena 等线索推断 NanoBanana 版本演进的依据。
递归自我改进(RSI)的含义与争议
RSI(Recursive Self-Improvement)指 AI 系统参与改进下一代 AI 自身,形成“能力提升—改进方法—能力再提升”的正反馈循环。在极端设想中,这种循环可能带来智能爆炸;但现实中的 RSI 更多体现为用模型辅助数据筛选、评测设计、代码编写和训练调参,从而缩短研发周期。
判断 RSI 是否发生,关键不在于是否出现神秘模型名,而在于改进闭环是否可量化地加速:例如单位人力投入带来的基准提升是否持续变快。仅凭内部模型标记或占位符无法证明任何事,它可能是实验分支、评测桩,甚至只是命名残留。因此文中把这一线索定位为“补上一块拼图”的推测而非结论,是恰当的处理方式。
订阅性价比:Semi Analysis的实测结论
Semi Analysis发布了一份针对主流AI订阅限额的实测报告,覆盖Anthropic、OpenAI、Meta、Cursor及Cognition,结论在社区引发了不少讨论。
核心数字是这样的:在约200美元的同等订阅价格下,Claude Max估计可提供约1.25万次Sonnet使用量、约1.2万次Opus或2500次Fable;ChatGPT Pro估计约有2000次GPT-6.1 Soul或3000次GPT-6 Extra。换算成等效API价值,Opus 5.5约为GPT-6.1的5倍。报告还指出,OpenAI近期将200美元套餐限额削减了约一半,理由是GPT-6.1本身更高效——这在为IPO铺路的解读下并不意外。
但API等价成本只能说明一半问题。它展示的是钱能换来多少计算量,不直接等于哪个订阅更好。模型质量、速度、上下文限制、智能体编程能力、工具集成和生态适配,都会影响实际体验。Anthropic在API成本比例上占优是事实,但这不意味着Claude Max对所有人都自动优于ChatGPT Pro。真正的分野在于使用强度:如果你每天运行智能体、写代码、消耗海量词元,这个差距会非常惊人。
水印、开源模型与工具更新
OpenAI正在响应欧盟AI法案要求,未来几周内欧盟地区通过ChatGPT和Codex生成的文本将包含不可见水印,技术名为TextScreen。它不在文本中插入可见标记,而是在模型选词中嵌入统计信号,之后可被检测。OpenAI称其效果媲美或超越Google的SynthID,且未导致结果质量明显下降,并计划开源这项技术。全球API客户即日起可在指定模型中使用。OpenAI也承认局限明显:文本被改写或篡改后,水印识别会失效。
新实验室ReflectionAI发布了开源模型BIM:总参数约5010亿,活跃参数仅230亿,采用MoE架构,单次仅激活部分参数以提升推理效率。官方称其专为推理、编程和分析设计,在这些领域引领西方开源模型发展——客观说,美国目前的开源模型并不多,这个定位有一定空间。值得注意的一点是,BIM完全从头预训练,而非基于已有开源模型构建,完整模型将于本月晚些时候公开发布。
工具层面还有几处更新:Google AI订阅用户现在可直接使用Opus 5.5 Medium与Sonnet 5.5 Medium,但额度限制严格;Claude Code新增Mods功能,其中Cache Control这个Mod值得推荐——它提供可视画面板显示查询缓存的5分钟窗口并发送通知,帮你在长时间会话中保持缓存活跃,减少重复处理相同词元,从而延长会话时长;Claude Projects则新增了直接连接本地文件夹的能力,云端的Claude会话可以按需读取或编辑你电脑上的文件,不必反复下载。
最后是一个Fable 5.5的演示:有人给模型一个请求,要求创建宝可梦风格的游戏(宝可梦与Balatro的结合),大约一小时后得到了包含画面、音乐和完整游戏机制的成品。从基础原型到连贯精致的完成度,这个演示的分量不轻。Fable 5.5最早可能今天发布,值得保持关注。
统计式文本水印与 MoE 架构
TextScreen 这类方案属于统计水印:模型在生成每个 token 时,依据一个只有服务方掌握的密钥,对候选词做轻微偏置,使输出中隐含人类难以察觉、但检测器可统计识别的模式。它的优点是肉眼不可见、对文本质量影响小;缺点是脆弱,一旦文本被改写、翻译、摘要或大幅编辑,统计信号就会被破坏。这也是 OpenAI 承认局限的原因,实际部署通常需要配合内容凭证等来源标注机制。
MoE(混合专家)架构把前馈层拆成多个“专家”子网络,并由路由网络为每个 token 只选择少数专家参与计算。因此总参数可以很大以容纳知识,而单次推理只激活一小部分参数,从而在效果与算力之间取得平衡。文中 BIM 的 5010 亿总参数、230 亿活跃参数就是典型配置,活跃参数才更直接决定单次推理成本。
相关推荐

Workbuddy零基础入门:桌面AI智能体如何落地工作流
Workbuddy桌面AI智能体零基础教程解读:从安装、积分领取到文件管理与自动化工作流搭建,对比CodeX的适用场景与成本差异,帮助职场人完成从AI提问者到AI管理者的思维转变。

OpenAI智能体新栈:计算机操作、决策API与超速工作流
OpenAI Dev Day发布智能体新栈:Computer Use操作速度超越普通人,Decisions API基于Luna实现极低延迟分类,Agents API开放同源计算机操作能力,GPT-6.1 Sol成本仅为Astra七分之一。本文梳理核心更新、实测数据与开发者落地要点。

梁文峰开源推理框架DeepInfo,硬刚美国禁令
DeepSeek在开源模型后再开源推理框架DeepInfo,包含GPU/CPU交叉流水线、小模型预判大模型复核、华为昇腾与英伟达芯片全面适配等技术,直面美国联邦禁令。本文解析其对AI产业落地的意义与开源策略。