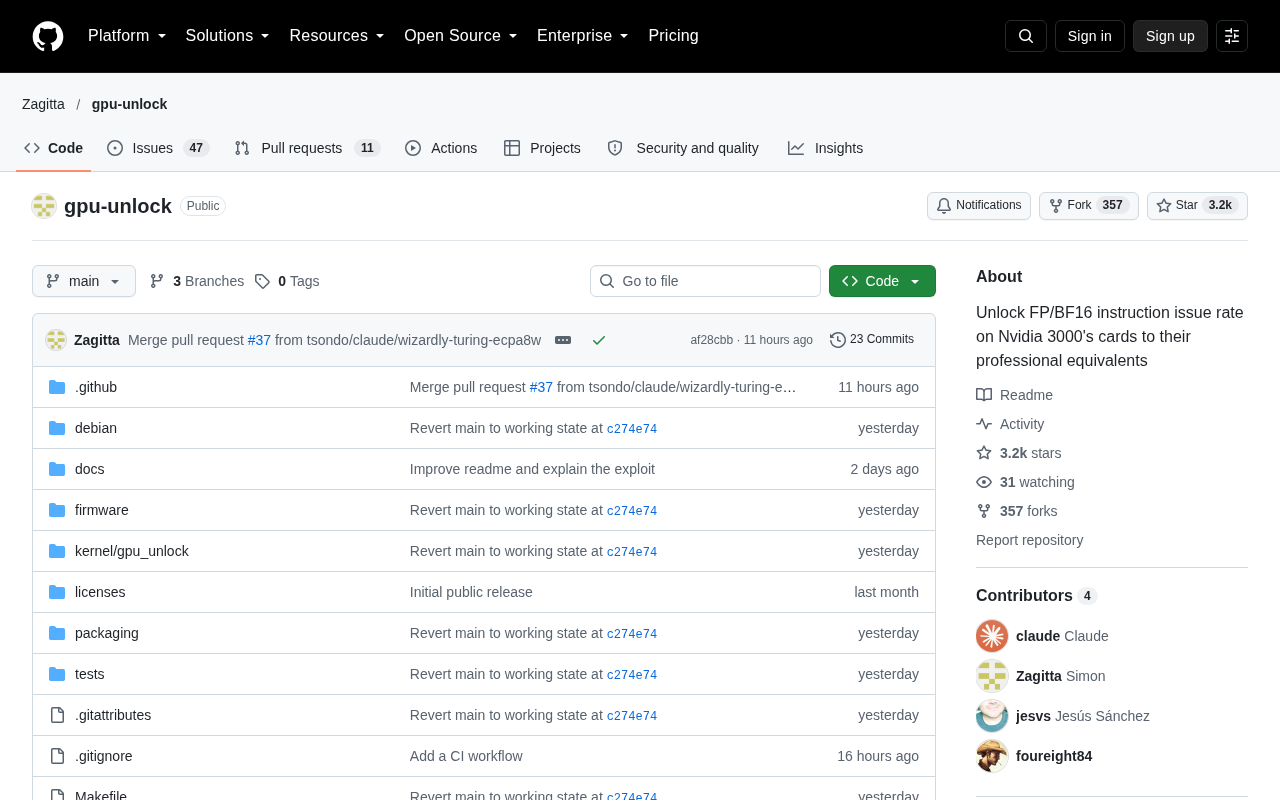
GPU-unlock:解锁 Nvidia 3000 系显卡的 FP/BF16 指令发射率

gpu-unlock 项目探索 Nvidia 3000 系显卡 FP16/BF16 指令发射率的测量与解锁,社区对其实际收益存疑。
gpu-unlock 是一个 GitHub 项目,旨在通过底层手段测量并可能解锁 Nvidia 3000 系列显卡(Ampere 架构)在 FP16 与 BF16 计算上的指令发射率潜力。文章解释了指令发射率对 GPU 实际浮点吞吐的重要性,指出官方规格表通常忽略这一指标,而厂商可能通过固件或驱动区分专业卡与消费卡。项目提供了微基准测试方法和解锁探索,但属于高风险操作,可能导致系统不稳定。Hacker News 社区讨论呈现分歧:一方认为解锁收益可能被内存带宽等瓶颈抵消,另一方认为逆向工程本身具有技术价值。文章强调,微基准改善未必能转化为端到端加速,项目的主要价值在于帮助开发者理解 GPU 微架构约束,而非提供生产级方案。
在 Nvidia 的 GPU 架构中,不同计算单元的指令发射能力往往被官方规格表所忽略。近期在 GitHub 上出现了一个名为 gpu-unlock 的项目,专门探讨如何通过底层手段释放 Nvidia 3000 系列显卡(基于 Ampere 架构)在 FP16 与 BF16 计算上的指令发射率潜力。这一话题在 Hacker News 上获得了 195 分和 61 条评论,说明不少开发者对消费级显卡的隐藏算力抱有浓厚兴趣。
为什么指令发射率值得关注
在 GPU 执行模型中,指令发射率(instruction issue rate)决定了每个时钟周期内 SM(流式多处理器)能够向执行单元派发多少条指令。对于矩阵乘加等密集计算而言,理论浮点峰值不仅取决于 CUDA 核心数量,还受限于指令能否被持续、足量地喂给执行管线。Nvidia 在专业卡与消费卡之间常常通过固件或驱动层面的配置做出区分,使得规格相似的芯片在实际吞吐上出现差距。
FP16 与 BF16 是深度学习推理和混合精度训练中最常用的数据格式。3000 系显卡的 Tensor Core 对这两种格式都有硬件支持,但面向消费市场的产品是否在指令发射层面被刻意限制,一直是社区讨论的灰色地带。gpu-unlock 项目正是从这个角度切入,尝试通过逆向与实验来量化并可能绕过这类限制。
SM(Streaming Multiprocessor)与子分区:在 Nvidia 的 GPU 架构中,SM 是基本的计算单元,每个 SM 包含多个子分区(sub-partition),每个子分区拥有独立的指令调度器和执行单元。指令发射率通常以每个子分区每个时钟周期能发射的指令数来衡量。Ampere 架构的每个 SM 包含四个子分区,每个子分区有 32 个 FP32 核心,但指令发射能力并不完全与核心数量成正比。理解 SM 的内部结构有助于分析为何某些指令流会遭遇发射瓶颈。
FP16 与 BF16 格式:FP16(半精度浮点)使用 16 位存储,包含 1 位符号、5 位指数和 10 位尾数,动态范围较小但精度尚可,广泛用于推理。BF16(Brain Floating Point)同样为 16 位,但采用 8 位指数和 7 位尾数,动态范围与 FP32 相同,更适合训练。两者在 Tensor Core 上均有硬件支持,但指令发射策略可能因数据格式而异。
项目做了什么
gpu-unlock 仓库的核心工作围绕两个层面展开:其一是测量,其二是解锁。在测量侧,项目提供了微基准测试方法,用于观察特定 SM 子分区在连续 FP16/BF16 指令流下的发射行为,从而判断是否存在人为的速率瓶颈。在解锁侧,项目探索了通过修改设备配置、调整驱动参数或利用未公开的寄存器接口来改变发射策略的可行性。
需要强调的是,这类操作属于典型的底层折腾,风险与收益并存。修改固件或驱动行为可能导致系统不稳定、计算结果不可靠,甚至影响保修。项目本身更像是一份研究记录和工具集合,而非一键式解决方案。对于希望复现结果的读者,建议先在隔离环境中进行测试。
微基准测试(Microbenchmark):指专门设计用于测量特定硬件行为的小型程序,通常通过循环执行大量相同或相似的指令来观察吞吐量、延迟等指标。在 GPU 上,微基准可以精确控制指令流、线程块大小和内存访问模式,从而隔离出指令发射率等微观架构特性。gpu-unlock 项目中的测量脚本很可能采用了这种技术,通过对比不同配置下的指令吞吐来推断是否存在人为限制。
社区反应与争议点
Hacker News 的讨论呈现出两种典型态度。一部分评论者认为,消费级显卡在指令发射率上的限制是厂商细分市场的常规手段,解锁它相当于在灰色地带游走,实际收益可能被内存带宽和缓存层级所抵消。另一部分人则从纯技术角度出发,认为搞清楚硬件真实能力本身就是有价值的逆向工程实践,即便最终无法稳定用于生产。
从已有讨论来看,社区对“解锁后能否在真实工作负载中转化为可观的性能提升”尚未形成共识。微基准测试中的差异能否在 PyTorch 或 cuBLAS 等高层框架中体现,取决于内核调度、占用率和数据局部性等多重因素。这也是此类项目常见的局限:底层指标的改善不等于端到端加速。
内存带宽与缓存层级的影响:即使指令发射率提升,GPU 性能也可能受限于内存带宽或缓存命中率。Ampere 架构的 GA102 芯片拥有大容量 L2 缓存,但消费级显卡的显存带宽通常低于专业卡。在密集计算中,如果数据供给跟不上,再高的指令发射率也无法转化为实际性能。因此,社区质疑解锁的实际收益被其他瓶颈抵消是合理的。
对开发者和研究者的意义
即便不打算实际动手修改,gpu-unlock 也提供了一个理解 GPU 微架构的窗口。它提醒我们,官方规格表中的 TFLOPS 数字是理想化的上界,真实性能由指令发射、寄存器压力、共享内存 bank 冲突等一系列微观机制共同决定。对于从事高性能计算和深度学习系统优化的开发者而言,了解这些底层约束有助于写出更贴合硬件的内核。
另一个值得关注的信号是,随着开源推理框架对低精度格式的支持日益成熟,BF16 在消费级硬件上的实际吞吐会越来越受重视。如果社区能够系统性地量化不同型号显卡在指令发射层面的差异,就能为用户选型和内核调优提供更可靠的依据。
TFLOPS 与真实性能的差距:TFLOPS(每秒万亿次浮点运算)是理论峰值,基于核心数量和时钟频率计算得出,假设所有执行单元始终满负荷工作。然而,实际应用中指令依赖、分支 divergence、内存延迟等因素会导致利用率远低于 100%。指令发射率是影响利用率的关键因素之一,官方规格表通常不披露这一细节,使得理论峰值与实际性能之间存在显著差距。
实践建议
如果你对这类底层实验感兴趣,合理的路径是先阅读仓库中的测量脚本,理解其观测的是哪个层级的指标,再在可控环境中复现基线数据。不要直接在生产机器上应用任何未经验证的修改。同时,建议将微基准结果与真实模型推理的端到端数据对照,避免被局部指标误导。底层折腾的价值在于加深理解,而非追求纸面数字。
相关推荐
LangChain Agent事件流解析:Event Streaming实战指南
深入解析LangChain 1.3引入的Event Streaming特性,详解Raw、Messages、Tool Calls、Values、Custom、Interleave六大事件类型的使用方法与实战要点,帮助Agent开发者实现精准的事件级流式输出。
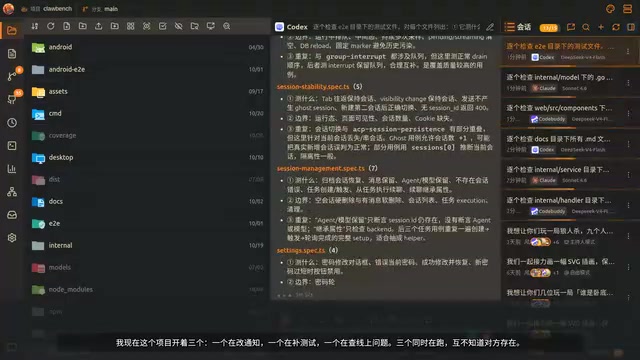
ClawBench多线并行开发:三层维度让AI并行不打架
ClawBench如何实现多线并行开发?B站UP主龙泽演示同时开六个AI会话、跨项目切换与Worktree分支隔离的三层并行机制,以及服务端执行架构如何让手机也能跑AI任务。

英伟达Astra与Isaac工具链:一个人也能造机器人?
英伟达GPT-6 Astra结合Isaac Lab、Newton与Isaac Lab Arena,让开发者用提示词构建机器人仿真世界、训练技能并大规模评估,配合Agile One SN参考机器人,机器人开发门槛大幅降低。