GRAC:基于图检索增强的手术场景描述新框架

GRAC用图表示手术场景并结合检索增强生成,显著提升描述的事实准确性。
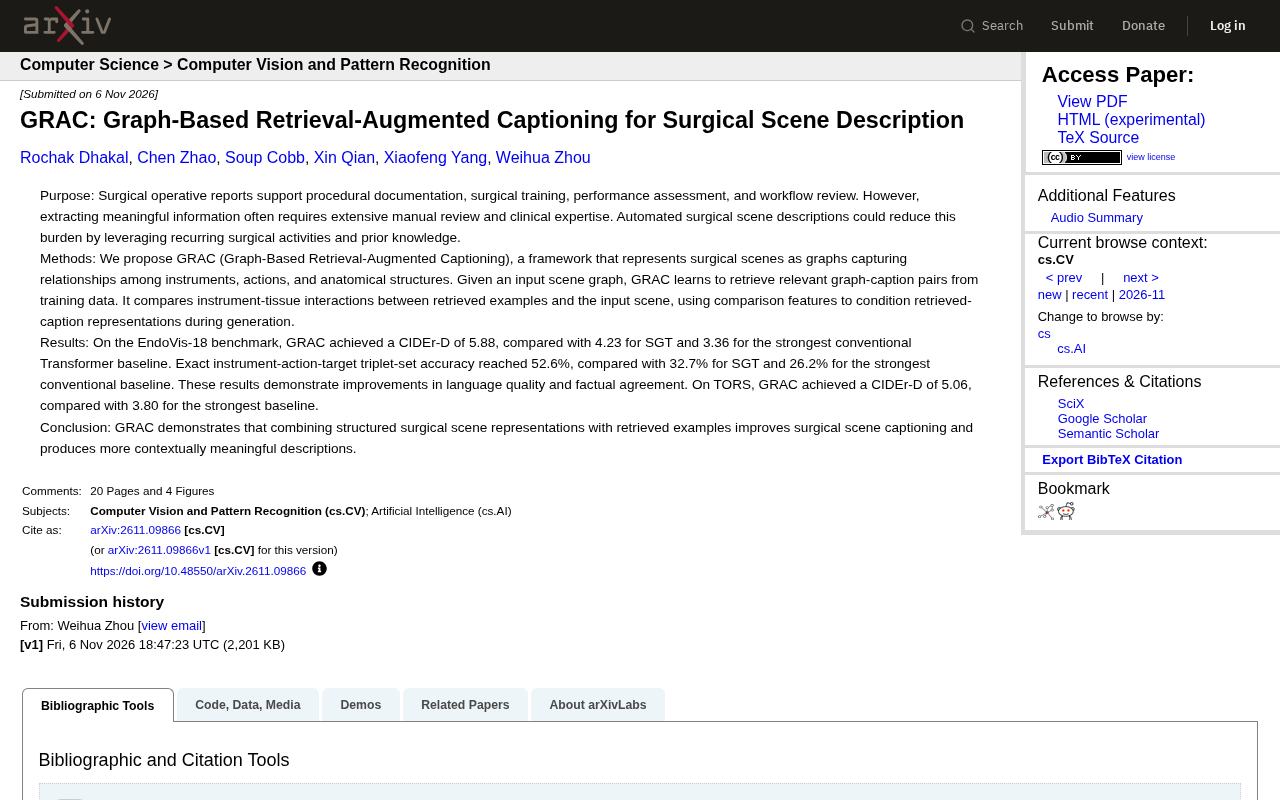
GRAC 是一个面向手术场景描述的新框架,它将手术场景建模为图,节点表示器械、动作和解剖结构,边表示交互关系,并在此基础上引入检索增强生成。给定输入场景图,模型先从训练数据中检索相似的图-描述配对,再通过对比器械-组织交互特征来校正检索到的描述表示,最终生成当前场景的文本。在 EndoVis-18 基准上,GRAC 的 CIDEr-D 得分为 5.88,器械-动作-目标三元组准确率达 52.6%,均大幅超越 SGT 和传统 Transformer 基线;在 TORS 数据集上 CIDEr-D 达 5.06,验证了跨数据集泛化能力。该方法的价值在于将手术描述从黑箱生成推向有据可查的生成,但其效果依赖检索库的覆盖范围,罕见场景可能受限。
手术记录是外科训练、绩效评估和流程复盘的重要依据,但从中提取有效信息往往依赖大量人工审阅与临床专业知识。如何让机器自动生成准确、有临床意义的手术场景描述,一直是医学图像与语言交叉领域的难题。近期提出的 GRAC(Graph-Based Retrieval-Augmented Captioning)框架,尝试用图结构表示手术场景,并结合检索增强生成来提升描述质量。
问题背景:手术场景描述为何困难
传统的手术场景描述方法通常将图像直接映射为文本,忽略了手术过程中器械、动作和解剖结构之间的复杂关系。手术场景中,同一器械可能执行多种动作,同一动作也可能作用于不同组织,这种组合爆炸使得纯端到端的模型难以准确捕捉事实细节。
GRAC 的核心思路是将手术场景建模为图:节点代表器械、动作和解剖结构,边表示它们之间的交互关系。这种结构化表示能显式保留手术活动的关键要素,为后续的检索与生成提供可靠基础。
CIDEr-D 是图像描述任务中广泛使用的自动评估指标,全称为 Consensus-based Image Description Evaluation(基于共识的图像描述评估),其 D 版本引入了对重复片段的惩罚。它通过计算生成描述与多个人工参考描述之间的 n-gram 余弦相似度,并加权组合不同 n-gram 阶数的得分,来衡量语义一致性。CIDEr-D 得分越高,说明生成文本与参考文本在词汇和语义上越接近。需要注意的是,该指标侧重语言层面的相似性,并不直接反映描述是否在医学事实上准确,因此研究中通常还会辅以事实一致性指标(如三元组准确率)进行综合评估。
SGT 在此处指 Surgical Graph Transformer(手术图 Transformer),是一种将手术场景建模为图并利用 Transformer 架构进行关系推理的基线方法。它通过图注意力机制在器械、动作和解剖结构节点之间传递信息,从而捕获手术活动中的结构化依赖。与 GRAC 不同,SGT 主要依赖模型参数中存储的知识进行生成,没有引入外部检索机制来提供可追溯的参考示例。因此,在需要精确还原器械-动作-目标三元组的事实一致性任务上,SGT 的表现明显弱于结合了检索增强的 GRAC,这也构成了论文对比实验的重要参照。
GRAC 框架:图表示 + 检索增强
GRAC 的工作流程分为两步。给定输入场景图,模型首先从训练数据中检索出相关的“图-描述”配对样本。随后,它对比检索样本与输入场景中的器械-组织交互,利用这些对比特征来调整检索到的描述表示,最终生成针对当前场景的文本描述。
这种设计让模型能够借鉴历史相似场景的语言表达,同时根据当前场景的细微差异进行校正。相比单纯依赖参数记忆的生成模型,检索机制为描述提供了可追溯的参考依据,有助于减少事实性错误。
检索增强生成(Retrieval-Augmented Generation, RAG) 是一种将外部知识检索与生成模型相结合的技术范式。其核心思想是:在生成目标文本之前,先从外部知识库中检索与输入相关的样本或文档,再将检索结果作为额外上下文输入给生成模型。这样做的好处是,模型不必将所有知识压缩在参数中,能够借助可追溯的外部依据减少事实性错误,并且在知识更新时只需更新检索库而无需重新训练模型。在 GRAC 中,检索库由训练数据中的“图-描述”配对构成,检索结果经过对比特征校正后用于生成当前手术场景的描述,是 RAG 思想在医学多模态场景中的具体落地。
实验结果:多项指标显著提升
在 EndoVis-18 基准上,GRAC 的 CIDEr-D 得分为 5.88,而 SGT 为 4.23,最强的传统 Transformer 基线为 3.36。在更严格的事实一致性指标上,器械-动作-目标三元组集合准确率达到 52.6%,SGT 为 32.7%,最强传统基线为 26.2%。
在 TORS 数据集上,GRAC 同样取得 CIDEr-D 5.06,最强基线为 3.80。这些结果说明,结构化场景表示与检索示例的结合,不仅在语言流畅度上带来提升,更在事实 agreement 上表现出明显优势。
器械-动作-目标三元组集合准确率 是一种面向手术场景描述的事实一致性评估指标。它将一段描述解析为若干(器械,动作,目标)三元组,例如(抓钳,抓取,胆囊),再与人工标注的标准三元组集合进行比对,计算精确匹配的比例。该指标不关心语言表达是否流畅,只关注描述中陈述的手术事实是否正确、完整。相比 CIDEr-D 等基于 n-gram 相似度的指标,三元组准确率更能反映模型是否真正理解了手术场景中的交互关系,因此在手术场景描述研究中被视为更严格、更具临床意义的评价方式。
意义与局限
GRAC 的价值在于它把手术场景描述从“黑箱生成”推向“有据可查的生成”。通过图结构捕获手术活动中的反复出现模式,并借助检索机制引入先验知识,模型生成的描述更具上下文相关性。
不过,该框架的效果高度依赖检索库的质量与覆盖范围,对于罕见手术场景可能缺乏可借鉴的示例。此外,图构建过程本身需要准确的器械与组织识别,端到端的实用性仍需进一步验证。
总体来看,GRAC 为手术场景理解提供了一个可解释、可扩展的方向,未来有望辅助手术记录自动化、术中决策支持以及医学教育。
相关推荐

间谍蜜罐训练内幕:情感解离与锚定技术
间谍如何被训练执行蜜罐任务?一位受训者披露情感解离、香水与关键词锚定、目标照片绑定等心理学技术,解析条件反射如何被用于情报行动,并揭示这套机制在日常生活营销中的类似应用。

前沿AI风险管理:从训练到部署的全链路实践
OpenAI系统阐述前沿AI风险管理框架:从训练阶段的模型对齐,到部署阶段的沙箱隔离与阻断式防护,再到部署后的持续监控,构建贯穿模型全生命周期的分层风险控制体系。

Databricks推出Genie Migrate,简化Serverless迁移
Databricks 发布 Genie Migrate for Serverless,帮助用户将既有工作负载迁移到 Serverless 计算。本文解析该迁移工具的定位、对用户的实际意义以及尚未明确的细节。