Grasp-TAGS:评论家蒸馏实现任务感知抓取选择
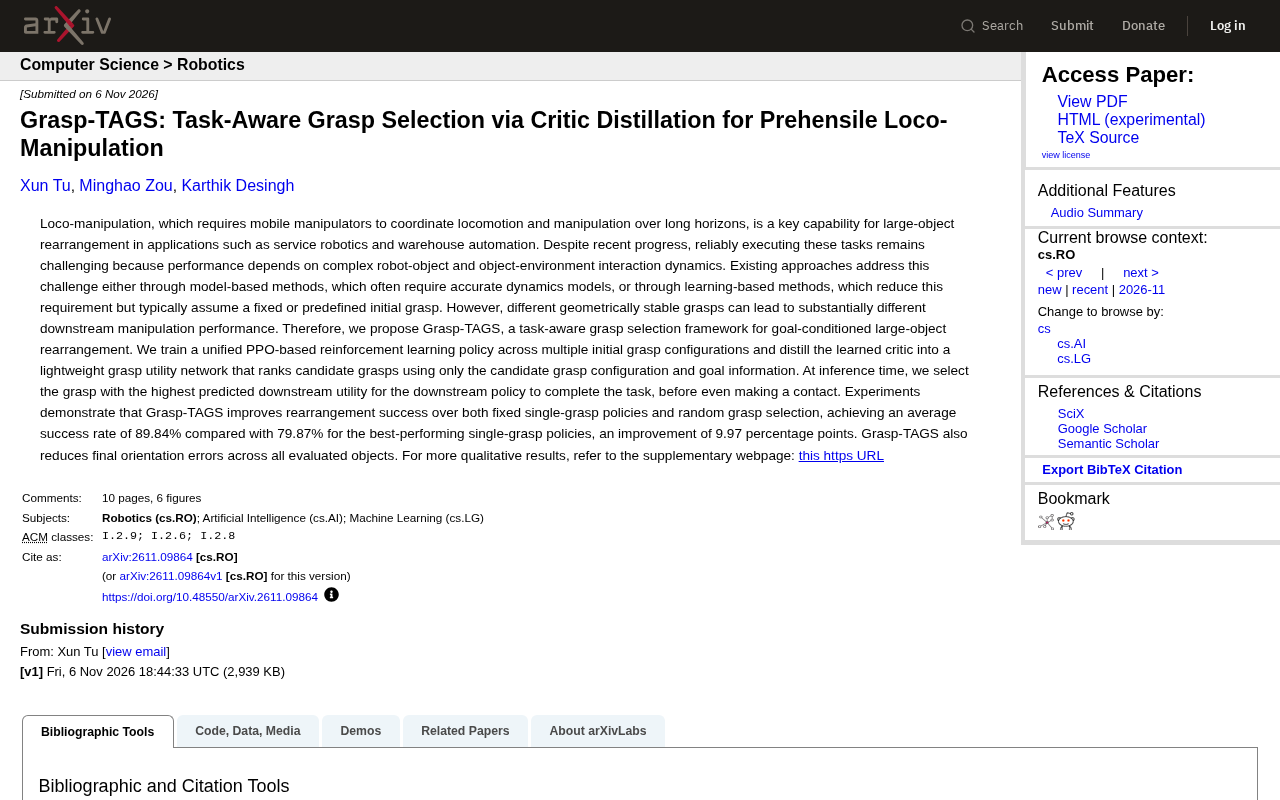
Grasp-TAGS 利用评论家蒸馏学习抓取效用网络,实现移动操作中任务感知的抓取选择。
Grasp-TAGS 是一个面向移动操作大物体重排的任务感知抓取选择框架。针对现有方法固定初始抓取或依赖精确动力学模型的不足,该方法首先训练一个覆盖多抓取的 PPO 策略,然后将其评论家网络蒸馏为轻量级抓取效用网络,仅根据候选抓取和目标信息预测下游效用。推理时,机器人对候选抓取排序并选择最高效用者,在接触物体前完成选择。仿真实验表明,平均成功率达 89.84%,比最佳单抓取策略提升 9.97 个百分点,并降低了最终方向误差。该方法无需精确模型,计算高效,但尚未在真实机器人上验证。
引言
在服务机器人和仓储自动化中,移动操作机器人需要协调移动与操作来完成大物体重排。这类移动操作(loco-manipulation) 任务不仅要求机器人稳定抓取物体,还要在后续的移动和放置过程中保持对物体的控制。然而,现实中的物体-机器人、物体-环境交互动力学非常复杂,使得可靠执行变得困难。现有方法要么依赖精确的动力学模型(基于模型的方法),要么采用学习-based方法但通常假设固定或预定义的初始抓取。但不同几何上稳定的抓取可能导致下游操作性能显著不同。为此,研究人员提出了Grasp-TAGS,一个面向目标条件大物体重排的任务感知抓取选择框架。
问题背景:为何抓取选择至关重要
移动操作任务中,抓取是连接移动与操作的关键环节。传统上,许多学习-based方法会固定一个初始抓取,然后训练策略完成后续任务。这种做法的局限性在于:不同的抓取虽然都能稳定抓住物体,但后续的移动轨迹、避障难度、放置精度可能大相径庭。例如,抓取物体的一侧可能使机器人在狭窄通道中更易碰撞,而抓取另一侧可能更利于精确放置。因此,仅仅保证抓取稳定是不够的,还需要考虑抓取对下游任务的影响。
现有方法要么需要精确的动力学模型来评估抓取,要么直接忽略抓取选择问题。Grasp-TAGS 则试图在不依赖模型的情况下,通过数据驱动的方式学习抓取的下游效用。
目标条件(goal-conditioned) 强化学习指策略不仅依赖当前状态,还以目标状态或目标描述为输入,从而完成多样化任务。在移动操作中,目标通常指定物体的期望位姿(位置和方向)。目标条件设定使单一策略能够泛化到不同目标,但也增加了学习难度,因为策略需理解目标与当前状态的差异。Grasp-TAGS 将目标信息纳入抓取效用网络的输入,使抓取选择与具体任务目标对齐,而非仅追求几何稳定。这种任务感知的抓取评估正是通过目标条件学习实现的,也是其优于固定抓取策略的关键。
Grasp-TAGS 方法:评论家蒸馏与任务感知抓取选择
Grasp-TAGS 的核心思想是利用强化学习中的评论家(critic)来指导抓取选择。具体来说,研究人员首先训练一个统一的基于 PPO 的强化学习策略,覆盖多个初始抓取配置。在训练过程中,评论家网络学习评估状态(包括抓取配置和目标信息)的价值。然后,他们将学到的评论家蒸馏成一个轻量级的抓取效用网络,该网络仅根据候选抓取配置和目标信息来预测抓取的下游效用。
在推理时,机器人首先使用抓取效用网络对所有候选抓取进行排序,选择预测效用最高的抓取,然后执行下游策略完成任务。整个过程在接触物体之前就完成了抓取选择,避免了试错成本。
这种方法的关键优势在于:
- 任务感知:抓取选择考虑了目标任务,而非仅仅几何稳定性。
- 轻量高效:蒸馏后的效用网络计算开销小,适合实时应用。
- 无需额外模型:不需要精确的动力学模型,完全从数据中学习。
PPO(近端策略优化) 是一种基于策略梯度的强化学习算法,因其实现简单、训练稳定而被广泛采用。它通过裁剪重要性采样比率来限制策略更新的幅度,避免训练崩溃。在 Grasp-TAGS 中,PPO 用于训练一个统一的策略网络,该网络同时接受抓取配置和目标信息作为输入,从而覆盖多种初始抓取。训练过程中,评论家网络(critic)估计状态价值,即从当前状态出发未来可获得的期望回报。由于评论家能够感知抓取配置和目标,其价值估计隐含了抓取对下游任务的影响。蒸馏则是将大型评论家网络的知识迁移到小型网络中的技术,通常通过最小化两者输出之间的差异来实现。Grasp-TAGS 利用蒸馏得到仅依赖抓取配置和目标的轻量效用网络,从而在推理时快速评估候选抓取,无需运行完整策略。
实验结果:显著提升重排成功率
研究人员在仿真环境中评估了 Grasp-TAGS。实验表明,与固定单抓取策略和随机抓取选择相比,Grasp-TAGS 显著提高了重排成功率。具体数据:平均成功率达到 89.84%,而最佳单抓取策略为 79.87%,提升了 9.97 个百分点。此外,Grasp-TAGS 在所有评估物体上都降低了最终方向误差,说明抓取选择不仅影响成功率,还影响操作精度。
这些结果验证了抓取选择对下游任务性能的重要性,也证明了评论家蒸馏方法的有效性。
局限与未来方向
尽管 Grasp-TAGS 表现出色,但当前工作仍存在一些局限。实验仅在仿真环境中进行,尚未在真实机器人上验证。真实世界的噪声和不确定性可能影响抓取效用网络的泛化能力。此外,方法假设候选抓取集合是预先给定的,如何生成高质量的候选抓取仍需依赖其他模块。未来工作可以将该方法扩展到更多样化的物体和任务,并探索在真实环境中的部署。
总结
Grasp-TAGS 通过评论家蒸馏实现了任务感知的抓取选择,为移动操作中的大物体重排提供了一种高效解决方案。其核心创新在于利用强化学习评论家来评估抓取的下游效用,并通过蒸馏得到轻量级网络,实现在接触前选择最优抓取。实验结果显示,该方法在成功率和方向误差上均优于基线,为后续研究提供了新思路。
更多定性结果可参考补充网页:https://rpm-lab-umn.github.io/Grasp-TAGS-web-page/
相关推荐
FBI紧急预警:自主AI黑客工具如何以机器速度攻破网络
FBI发布紧急警报,点名开源AI攻击框架Artex可用大模型把一句大白话变成完整入侵链,三小时内攻破关键行业网络。本文梳理三阶段攻击机制、开源代码失控的现实,以及FBI建议的SIEM情报导入、云端最小权限、遗留资产补丁三项加固措施。
Gemini 4 Hydrogen跑分全解析:编程与AI代理性能
Google Gemini 4 Hydrogen 基准跑分全解析:SWE-bench 13.5%、Terminal Bench 57%、OS World 77.6%、Automation Bench 76.76%,百万 token 上下文,API 每百万输入 token 1.5 美元起,编程与 AI 代理能力深度解读。

FBI警告ARTEX AI:3小时攻破企业,单兵作战时代来临
FBI发布13页预警,揭示开源渗透测试工具ARTEX AI被攻击者滥用。单个操作员借助廉价大模型可在3小时内攻破企业,韩国银行、微软客户环境均受影响。本文解析其工作原理、真实案例与防御建议。