Grok、Cursor与X Premium合并订阅:8至200美元四档方案解析

Grok、Cursor与X Premium合并订阅,Meta与DigitalOcean加码Agent赛道。
AI工具订阅市场出现结构性整合:Grok、Cursor和X Premium被合并为统一的X-Subscription,设Plus、Premium、Super、Ultra四档,月费8至200美元,用量池跨工具共享并按周刷新,Grok模型获约两倍编程用量,但第三方模型按API列表价额外计费。与此同时,Meta发布面向Agent场景的MuseWonder和WonderFull,WonderFull智能指数56分、编程Agent得分68,与Sonnet 5.5持平;DigitalOcean开放Signals和Simulations预览,为Agent提供故障标记与模拟测试能力。OpenRouter份额显示Opus 5.5居首,但份额领先不等同能力领先。整体趋势是AI Agent正从「能不能用」转向「好不好管」。
AI工具订阅市场正在经历一轮结构性整合。据iStarSoft AI每日简报(YouTube)报道,Grok、Cursor和X Premium被合并为统一的「X-Subscription」订阅体系,划分四个付费层级。这一变化不仅影响现有用户的账单结构,也可能重新定义AI编程工具与通用AI助手的捆绑逻辑。
四档定价与用量池机制
新订阅体系分为四档:Plus每月8美元、Premium每月30美元、Super每月100美元、Ultra每月200美元。核心卖点在于用量池(usage pool)跨Cursor和Grok共享,并按周刷新。
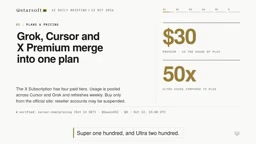
这意味着用户不再需要为每个工具单独管理配额,编程辅助和对话式AI的额度可以互相调剂。现有Cursor订阅者可以选择保留原方案或迁移至新体系。新方案为Grok模型提供约两倍的编程用量——这是对重度编程用户的直接激励。
不过有一个容易被忽略的条款:第三方模型按API列表价计费。这意味着用户如果调用非Grok、非Cursor原生的模型,费用将不包含在套餐内,需要自行设置消费上限以避免意外账单。从产品设计角度看,这是在用价格杠杆引导用户向自有模型生态集中。
Meta发布MuseWonder与WonderFull:面向Agent场景的新模型
Meta推出了其迄今能力最强的模型系列——MuseWonder和WonderFull,两者均面向Agent(代理)场景设计。Wonder已上线Meta模型API,WonderFull则用于MuseCoding。Meta表示完整安全报告即将发布。
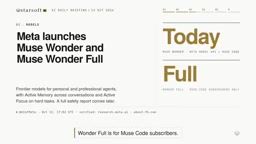
据Artificial Analysis评测,WonderFull在智能指数上得分为56,较此前的48有显著提升。其编程Agent得分68,与ClawedCode(搭载Sonnet 5.5)持平。API定价方面,MuseWonder为每百万token输入4美元、输出20美元。
这组数据的含义值得拆解。智能指数从48到56的跃升幅度不小,但编程Agent得分68只是「追平」而非「领先」当前头部竞品,说明Meta在Agent编程赛道上仍处于追赶态势。对于开发者而言,多一个有竞争力的选项总是好事,但迁移成本和学习曲线需要纳入考量。
Agent(智能体)场景指模型不只是被动回答问题,而是能自主调用工具、执行多步任务、根据反馈调整策略的应用形态,例如自动化编程、网页操作、数据分析流水线等。与单轮对话相比,Agent任务对模型的指令遵循、错误恢复和长上下文一致性要求更高,因此评测体系中通常单独设置「编程Agent」等子项,而非仅看通用智能指数。**智能指数(Intelligence Index)**一般是综合多项基准的加权分数,用于横向比较模型能力,但不同机构的口径差异较大,跨榜单对比时需谨慎。
DigitalOcean推出Signals与Simulations:Agent的可观测性工具
DigitalOcean开放了面向AI Agent的Signals和Simulations公开预览。
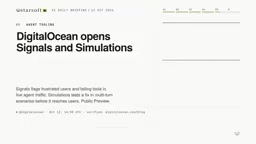
Signals功能在实时流量中标记失败工具调用和用户受挫信号,相当于给Agent装上了一套「症状监测」系统。Simulations则允许开发者在真实用户接触到修复方案之前,先在模拟对话中测试效果。
这两个工具的定位很明确:Agent从实验走向生产环境时,最大的痛点就是「出了问题不知道哪里出了错」。Signals解决可观测性问题,Simulations解决变更验证问题。对于正在将Agent部署到生产环境的团队,这套组合值得关注。
**可观测性(Observability)**源自分布式系统运维领域,指通过日志、指标、追踪三类数据还原系统内部状态的能力。当Agent调用外部工具失败、陷入循环或误解用户意图时,传统日志往往只能看到「调用了什么」,而看不到「为什么失败」。Signals这类工具的价值在于把失败调用与用户情绪信号关联起来,形成可定位的问题链路。**模拟测试(Simulation)**则是把变更验证前移:先在合成对话或回放流量中验证修复效果,再灰度发布给真实用户,降低线上事故风险。这两类能力通常是Agent从Demo走向生产环境的必备配套。
XRadar:配额修复、版本变动与市场份额
本日快讯层面有几条值得关注的信息。据Alexandra Wang的消息,Meta修复了一个Muse配额相关的bug,并重置了MuseCode的使用限制。
一则病毒式传播的帖子声称「anti-gravity」将于11月2日移除第三方模型支持(此为单一来源,尚未获得官方确认)。Google文档则显示付费方案将继续保留Clawed 5.5。
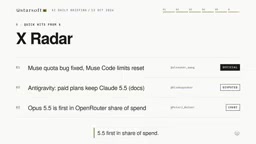
在OpenRouter的份额图表上,Opus 5.5位列第一。这个排名反映的是API聚合平台上的实际调用分布,可以作为模型市场热度的一个参考指标。你可能没注意到,份额领先并不等同于能力领先——价格、延迟、生态锁定等因素都会影响开发者的选择。
OpenRouter是一个聚合多家模型API的第三方平台,开发者通过统一接口调用不同厂商的模型。其份额图表反映的是该平台上的实际调用量分布,而非全市场规模。这类数据具有样本偏差:偏好尝鲜、对价格敏感的开发者更可能使用聚合平台,而大企业往往直接对接原厂API。因此份额排名可以视为「开发者用脚投票」的一个切面,用来观察热度趋势比用来判断绝对市场地位更可靠。
订阅整合背后的行业逻辑
将编程工具(Cursor)、对话AI(Grok)和社交平台订阅(X Premium)打包为一个订阅体系,本质上是在做两件事:提高单用户收入上限,以及降低多产品之间的用户流失率。
用量池按周刷新的设计也值得玩味——它制造了一种「不用就浪费」的紧迫感,促使用户更频繁地调用服务,从而加深对平台的依赖。对于用户来说,关键决策点在于:自己的使用模式是否真的能从跨工具用量池中获益,还是只是为一堆用不上的额度付费。
竞争格局方面,Meta以Muse系列切入Agent赛道、DigitalOcean补齐Agent运维基础设施、OpenRouter的份额数据揭示真实调用偏好——这几个信号叠加在一起,指向同一个趋势:AI Agent正在从「能不能用」进入「好不好管」的阶段。
用量池(Usage Pool)机制是订阅制AI服务的常见设计思路,其核心逻辑类似于云计算中的「共享配额」或通信套餐中的「流量池」。传统做法是按产品分别计费(每个工具一个独立额度),而用量池允许同一账户下的多个工具共享一个总配额。按周刷新则是一种节奏控制手段:月度额度容易让用户在月初集中消耗、月末闲置,周度刷新能更均匀地分布负载,同时缩短用户的「心理账期」,让闲置额度带来的损失感更频繁地被感知。对平台而言,这种设计既平滑了算力调度压力,也提高了用户的日均活跃度。
相关推荐

Workbuddy零基础入门:桌面AI智能体如何落地工作流
Workbuddy桌面AI智能体零基础教程解读:从安装、积分领取到文件管理与自动化工作流搭建,对比CodeX的适用场景与成本差异,帮助职场人完成从AI提问者到AI管理者的思维转变。

OpenAI智能体新栈:计算机操作、决策API与超速工作流
OpenAI Dev Day发布智能体新栈:Computer Use操作速度超越普通人,Decisions API基于Luna实现极低延迟分类,Agents API开放同源计算机操作能力,GPT-6.1 Sol成本仅为Astra七分之一。本文梳理核心更新、实测数据与开发者落地要点。

梁文峰开源推理框架DeepInfo,硬刚美国禁令
DeepSeek在开源模型后再开源推理框架DeepInfo,包含GPU/CPU交叉流水线、小模型预判大模型复核、华为昇腾与英伟达芯片全面适配等技术,直面美国联邦禁令。本文解析其对AI产业落地的意义与开源策略。