固定点分数匹配:扩散采样器训练新范式
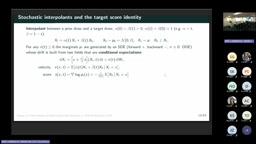
固定点分数匹配统一扩散采样算法,仅凭能量函数训练,在材料与强化学习中高效应用。
本文介绍了采样问题的核心设定:只有未归一化密度(能量函数)可评估,无样本可用。传统MCMC和早期扩散采样器存在混合慢、模式坍塌、内存大等问题。Dennis Blessing提出的固定点分数匹配框架,通过将目标分数恒等式与随机插值结合,在模型生成的样本上计算能量梯度,迭代训练扩散采样器,无需目标样本。该框架统一了边缘射击、薛定谔桥、流匹配等算法。在材料科学中,ATLAS和MANNERS项目处理非晶态和合金体系,计算成本降低数个数量级,并支持尺寸迁移和参数摊销。在强化学习中,目标流匹配损失直接训练确定性ODE策略,结合相关探索取得最优性能。局限包括模式权重估计困难、自由能估计方差与成本矛盾、收敛性理论缺失。
采样问题:从能量函数中生成样本
在科学计算中,有一类问题既常见又棘手:我们手头只有一个未归一化的密度函数,可以评估它、可以求梯度,但拿不到任何样本。这正是采样问题的核心设定。目标密度往往具有多模态结构,评估代价高昂——比如用密度泛函理论计算一次能量可能需要数小时,而且问题维度通常极高。
这类问题在分子模拟、材料科学、贝叶斯推断和强化学习中广泛存在。经典方法如马尔可夫链蒙特卡洛(MCMC)虽然具有渐近保证,但面对多模态分布时容易陷入局部模式,混合时间极长。更关键的是,MCMC缺乏灵活性:改变温度或系统参数,就必须重新运行完整模拟。
神经采样器的思路是用机器学习来学习一个从简单先验到目标分布的传输映射。如果训练得当,它能生成独立样本、实现成本摊销、还能通过重要性权重去偏。扩散采样器正是这类方法中最具表达力的一种。
未归一化密度与能量函数的关系:在统计物理和贝叶斯推断中,目标分布通常以玻尔兹曼形式给出 $p(x) \propto e^{-E(x)}$,其中 $E(x)$ 是能量函数或负对数密度。归一化常数(配分函数)$Z=\int e^{-E(x)}dx$ 往往不可计算,因此我们只能评估未归一化的密度或其对 $x$ 的梯度(即分数 $\nabla_x \log p(x) = -\nabla_x E(x)$)。所谓“采样问题”,就是在只知道 $E(x)$ 而无法直接得到 $Z$ 和样本的条件下,生成服从 $p(x)$ 的样本。这一设定贯穿分子模拟、材料科学和贝叶斯推断,也是扩散采样器要解决的根本困难。
扩散采样的早期困境
扩散模型在数据驱动场景下表现惊艳,但score matching需要目标分布的样本——这恰恰是采样问题中缺失的。从2022年底开始,研究者尝试用变分推断的思路,通过最小化路径空间上的反向KL散度来训练扩散采样器。
这类方法有几个致命问题。反向KL是零强制(zero-forcing)的,倾向于模式搜索,实践中的模式坍塌现象严重。更实际的问题是,损失函数定义在整条轨迹上,需要反向传播通过SDE求解器,内存开销巨大;样本无法复用,意味着要反复评估代价高昂的目标密度。
2023至2024年提出的对数方差损失缓解了部分问题——它用任意参考过程替代当前模型下的期望,允许样本复用和梯度截断。但高方差梯度让优化极不稳定,且仍需存储完整轨迹。随后的一些基准测试甚至直接得出结论:这些方法效果并不理想。
反向KL散度与零强制(zero-forcing):变分推断中常用反向KL散度 $D_{KL}(q|p)$ 来衡量近似分布 $q$ 与目标 $p$ 的差异。其一个关键性质是“零强制”:当 $p(x)=0$ 而 $q(x)>0$ 时,KL散度会施加极大惩罚,迫使 $q$ 在 $p$ 的零区域也趋于零。这导致 $q$ 倾向于只覆盖 $p$ 的少数高概率模式,即模式坍塌(mode collapse),而无法正确分配各模式之间的相对权重。相比之下,前向KL $D_{KL}(p|q)$ 是“质量覆盖”的,会鼓励 $q$ 覆盖所有 $p$ 非零的区域,但需要目标分布的样本。扩散采样器早期使用反向KL正是为了避开对目标样本的需求,却也继承了模式搜索的缺陷。
固定点分数匹配:统一框架
Dennis Blessing在演讲中提出,近年来涌现的众多扩散采样算法——从边缘射击到薛定谔桥,再到流匹配和桥匹配采样——看似迥异,实则共享同一底层原理。他将其统一命名为固定点分数匹配。
核心洞察在于:我们虽然没有目标分布的样本,但有当前模型生成的样本。通过将随机插值中的去噪分数恒等式替换为目标分数恒等式,期望可以从目标分布转移到当前模型分布下计算。由此得到的迭代循环是:从当前模型生成终端样本存入回放缓冲区,计算这些样本处的能量梯度(即分数),然后用标准分数匹配和流匹配损失进行监督学习,更新模型后重复。
理论上的最优速度场和分数场正是这个迭代的固定点。这一框架的优雅之处在于,训练过程与数据驱动的扩散模型训练几乎一致,可以高效地子采样时间和状态来优化,摆脱了整条轨迹的束缚。
随机插值与去噪分数恒等式:随机插值构造一条从先验分布 $p_0$ 到目标分布 $p_1$ 的概率路径,通常定义为 $x_t = \alpha_t x_0 + \sigma_t x_1$,其中 $x_0 \sim p_0$,$x_1 \sim p_1$。去噪分数恒等式指出,给定 $x_t$,条件期望 $\mathbb{E}[x_1|x_t]$ 与边缘分数 $\nabla_{x_t} \log p_t(x_t)$ 之间存在解析关系。在标准扩散模型中,$p_1$ 是数据分布,因此可以用数据样本估计该恒等式。而在采样问题中,$p_1$ 未知且无样本,固定点分数匹配的关键创新是将去噪分数恒等式替换为目标分数恒等式:用当前模型生成的样本 $x_1 \sim q_\theta$ 代替真实目标样本,从而将期望从目标分布转移到模型分布下计算,形成一个可迭代优化的固定点方程。
材料科学应用:从非晶态到合金
研究团队将这一框架应用于两个材料科学问题。ATLAS项目建模非晶态材料,从周期性均匀分布出发,学习生成具有众多亚稳态的玻璃态结构。在经典的Kob-Andersen玻璃形成体实验中,模型不仅准确复现了能量直方图,还在自由能估计上匹配了参考值。
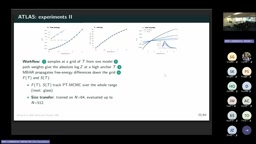
得益于图神经网络架构,模型展现出优秀的尺寸迁移能力:在64个粒子上训练,直接推断512个粒子的系统仍保持良好精度。更令人印象深刻的是计算成本——ATLAS需要的目标能量评估次数比并行回火方法少了数个数量级。
MANNERS项目进一步处理更复杂的半巨正则系综,同时建模连续通道(原子位置和体积)和离散通道(原子种类)。离散部分采用掩码扩散模型,团队推导出标签交叉熵损失,其条件期望恰好对应真实去噪后验,为固定点迭代提供了理论保障。在Ising模型和铜镍、铜银合金体系上,模型摊销了温度和化学势,用单个模型覆盖整个相图参数空间。
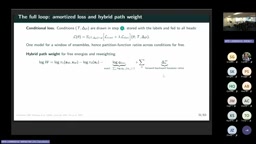
半巨正则系综与掩码扩散:在合金等开放体系中,原子种类和数量可以变化,需要半巨正则系综描述,其中连续变量(原子位置、体积)和离散变量(原子种类)同时存在。掩码扩散模型(masked diffusion)将离散变量处理为吸收态:在扩散过程中,原子种类以一定概率被替换为掩码标记,模型学习从掩码状态恢复原始种类。这种设计允许在离散空间定义扩散过程,并推导出标签交叉熵损失。其条件期望恰好对应真实去噪后验,从而与固定点分数匹配框架无缝结合,使得单个摊销模型能覆盖不同温度、化学势和组分,大幅降低重复模拟成本。
强化学习:确定性ODE策略的新可能
同一框架在强化学习中也有出人意料的应用。最大熵强化学习的最优策略正比于Q函数的指数,这本身就是一个采样问题。研究团队推导出速度分数恒等式,将其与目标分数恒等式结合,得到目标流匹配损失——其最小值与标准流匹配损失相同,但仅依赖能量梯度而非目标样本。
这意味着可以直接训练确定性ODE策略,无需SDE转换或伴随ODE反向模拟。在行为约束强化学习中,只需访问参考策略的梯度即可实现KL正则化,而参考策略的梯度同样可通过速度分数变换获得。
算法还引入了两个实用扩展。信任域更新通过新旧策略间的L2约束和原始-对偶下降保证训练稳定性;跨状态相关探索则利用流策略的确定性映射特性,对初始高斯噪声在不同环境状态间施加相关性,在不改变边缘分布的前提下显著改善探索效率。
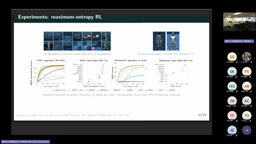
在DeepMind Control和Humanoid任务上,配合相关探索的方法取得了所有对比方法中的最佳表现。在离线到在线强化学习设定中,流策略的最终在线性能同样出色。
尚待解决的问题
这一框架也存在明确局限。分数本质上是局部量,当目标分布的模式间距很大时,方法难以正确权衡各模式的相对权重。自由能估计虽有路径权重和ODE权重两种途径,但前者方差随步数累积增长,后者在大系统上计算Hessian代价过高——团队在实践中以高温下的扩散权重结合经典方法向下传播,这仍是开放问题。
独立耦合的使用丢弃了x0与x1配对中的相关信息,而射击耦合等更优耦合虽然理论诱人,但交替优化带来的不稳定性使其在实践中表现不佳。即使优化本身无需模拟,回填缓冲区仍需不断生成样本,大模型下模拟成本可能主导训练。理论上,固定点迭代的唯一性和收敛性尚未得到证明——这些方法在实践中表现良好,但数学基础仍有待完善。
相关推荐

2026年AI编程工具横评:Claude、ChatGPT、Gemini谁最强?
2026年五款主流AI编程工具横评:Claude Code、ChatGPT Codex、Gemini、DeepSeek和GitHub Copilot在真实项目、定价与代码质量上的全面对比,帮你决定每月20美元该花给谁。

ChatGPT Codex克隆任意软件?实测风险与真相
YouTube短视频宣称用ChatGPT Codex或Claude Code即可克隆Adobe、Excel、Figma等软件并终身免费使用。本文拆解其技术可行性、法律风险与私信引流套路,说明AI编程工具真正适合的用法。

Kilo Code免费安装但API收费:成本估算与配置指南
Kilo Code 开源 AI 编程代理安装免费,但接入的 AI 模型按 token 收费。本文详解 VS Code 扩展与 CLI 配置步骤,并用假设用量演示 API 成本估算方法,对比按量付费与订阅制的选择逻辑。