谷歌AI概览医疗信息准确性堪忧:引用质量与接地性双双不足

研究显示谷歌AI概览在健康问题上信源偏商业媒体、接地薄弱且完整性差,准确性与接地性无关。
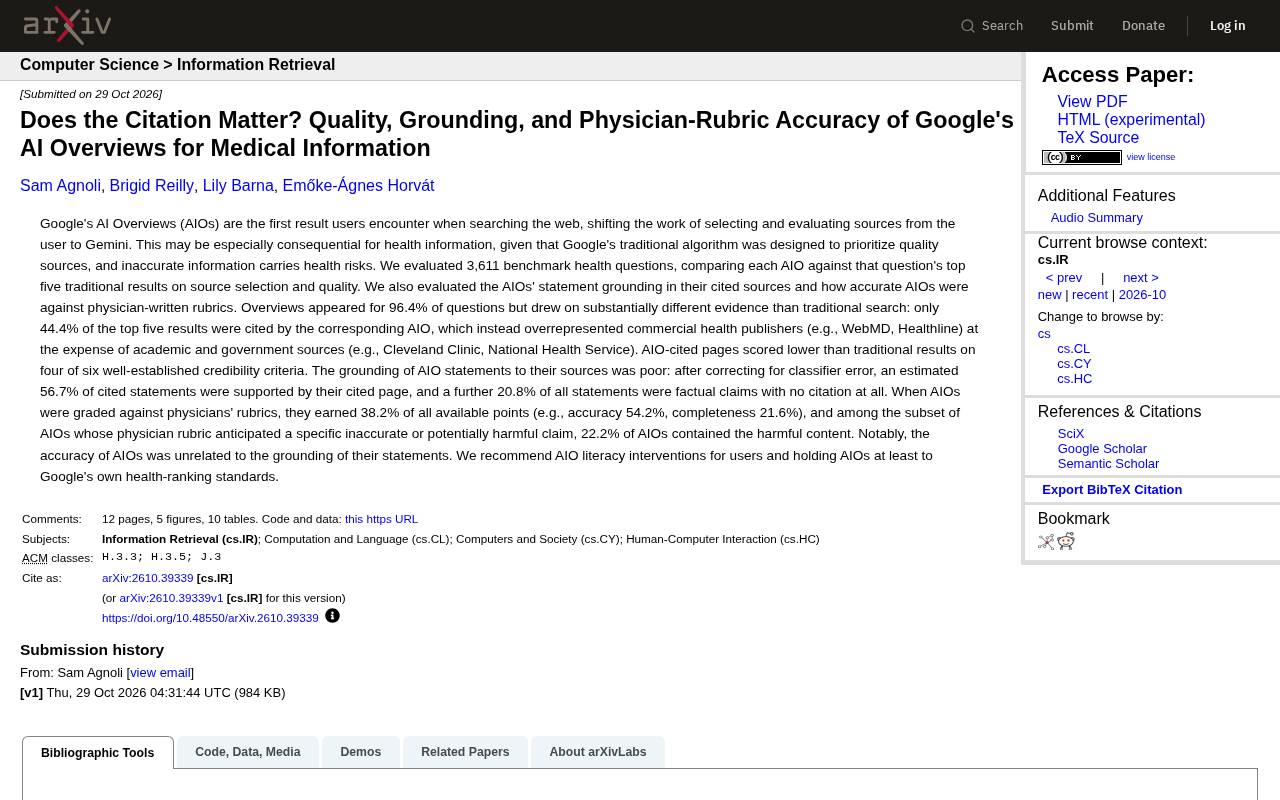
一项针对3,611个基准健康问题的系统评估对比了谷歌AI概览(AIO)与传统搜索前五条结果。AIO在96.4%的问题上触发,但仅引用传统搜索前五结果中的44.4%,且过度代表WebMD、Healthline等商业健康媒体,冷落克利夫兰诊所、NHS等学术与政府信源。AIO引用页面在六项可信度标准中四项得分更低;校正误差后仅56.7%的被引用陈述获来源支持,20.8%的事实陈述完全无引用。对照医生量表,AIO仅得38.2%的分数,准确性54.2%、完整性21.6%,在预期含有害内容的子集中22.2%确实包含有害内容。最反直觉的发现是准确性与接地性之间无关联,提示引用覆盖与答案质量需分别优化。
谷歌的AI概览(AI Overviews,简称AIO)正成为用户搜索时最先看到的答案,它把筛选和评估信源的工作从用户转移给了Gemini模型。在医疗健康这类对信息准确性高度敏感的领域,这种转变的影响尤其值得警惕。一项针对3,611个基准健康问题的系统评估,把AIO与同一问题下传统搜索的前五条结果做了对比,结论并不乐观:AIO不仅倾向于引用商业健康媒体而非权威学术与政府机构,其陈述与所引来源之间的"接地性"(grounding)也相当薄弱,而令人意外的是,这种接地不足与AIO本身的准确率之间并无关联。
研究设计与覆盖范围
研究选取了3,611个基准健康问题作为测试集,对每个问题分别考察两个对象:一是谷歌传统搜索返回的前五条结果,二是同一问题触发的AI概览。评估维度包括信源选择与质量、AIO陈述在其引用来源中的接地情况,以及AIO对照医生撰写的评分量表(physician-written rubrics)的准确性。
AIO的触发率极高——在96.4%的问题上都出现了概览。这意味着绝大多数健康类查询的第一屏内容,已经由Gemini生成并组织,用户接触传统蓝色链接之前就先接受了AI的总结。这一覆盖率是理解后续所有问题的前提:AIO不是边缘功能,而是健康信息获取的主入口。
基准健康问题(benchmark health questions)通常指从权威医学问答数据集或临床常见问题中筛选出的、有标准答案或可对照评估的问题集合。这类基准集的设计目的是让不同系统在相同问题上接受可复现的测试,避免研究者自行选题带来的偏差。本研究所用的3,611个问题覆盖了症状、治疗、药物、预防等多个健康类别,每个问题都有医生撰写的评分量表作为金标准,因此既能评估回答的准确性,也能评估其完整性。基准集的存在使得AIO与传统搜索的对比建立在同一问题上,而非各自挑选有利案例,这是该研究方法论上的关键前提。
信源选择:商业媒体挤占权威机构
最直接的发现是,AIO所依据的证据与传统搜索存在实质性差异。传统搜索前五条结果中,只有44.4%被对应的AIO引用。取而代之的是,AIO明显过度代表了商业健康出版商,例如WebMD、Healthline,而学术与政府来源——如克利夫兰诊所(Cleveland Clinic)、英国国家医疗服务体系(NHS)——则被相对冷落。
这一偏向与谷歌传统算法的设计初衷形成对照。传统排名算法本就以优先展示高质量信源为目标,而AIO的信源重组某种意义上绕过了这套质量机制。当用户在搜索结果页直接读到AI总结时,他们不再看到原始信源的排列顺序,也就失去了传统搜索中那层"可信度排序"的隐性提示。
引用页质量:六项标准中四项落后
研究进一步用六项成熟的可信度标准衡量AIO引用页面的质量,结果AIO引用的页面在其中四项上得分低于传统搜索结果。换句话说,AIO不仅换了一批信源,换上的这批信源整体质量也更低。
这对健康信息尤为关键。商业健康媒体在可读性和覆盖面上有优势,但在证据溯源、更新透明度、专业审校等维度上,往往不及学术医疗机构与政府卫生部门。信源结构的这种漂移,可能让用户接触到看似专业、实则证据基础较弱的健康建议。
接地性薄弱:过半引用陈述缺乏来源支持
如果说信源质量是"选了谁"的问题,接地性则是"说的和引的是否对得上"的问题。研究对AIO陈述与其引用来源的一致性做了分类器评估,并在校正分类器误差后得出结论:估计只有56.7%的被引用陈述得到了所引页面的支持。另有20.8%的全部陈述属于事实性断言,却完全没有引用。
这意味着,即便AIO给出了引用链接,用户也不能默认该链接真的支撑了那句话。相当一部分内容处于"有引用之名、无引用之实"的状态,而还有五分之一的事实陈述连引用都没有。对于需要严谨溯源的医疗信息,这种接地缺口是实实在在的风险。
接地性(grounding)是评估生成式AI系统时的一个核心概念,指模型输出中的每一条事实性陈述是否能在其引用的来源中找到明确支持。一个“接地良好”的回答,意味着读者点开引用链接后能直接看到支撑该句话的原文;而“接地薄弱”则可能出现引用页面与陈述主题相关、却并未包含该具体断言的情况。接地性不同于准确性:准确性衡量答案对不对,接地性衡量答案有没有出处、出处是否真的支撑它。研究中使用分类器对陈述与引用来源的一致性进行判定,并校正分类器自身的误判率,正是为了把“有引用”与“引用有效”区分开来。
医生评分:准确率过半,完整性严重不足
研究用医生撰写的评分量表对AIO打分,AIO仅获得全部可得分的38.2%。分项来看,准确性为54.2%,完整性仅21.6%。完整性得分之低,说明AIO倾向于给出简短、结论式的回答,而健康问题往往需要前提条件、适用人群、风险提示等上下文,这些在压缩的概览中容易被省略。
更值得关注的是有害内容的比例。在医生量表预期会出现某个具体不准确或潜在有害声明的那部分AIO中,22.2%的AIO确实包含了该有害内容。也就是说,当问题本身存在"容易答错"的陷阱时,AIO有超过五分之一的情况踩了进去。
医生撰写的评分量表(physician-written rubrics)是由临床医生针对每个基准问题预先制定的评分标准,通常列出该问题下必须覆盖的关键信息点、常见错误以及潜在有害的表述。评估时,研究者将AIO的回答逐项对照量表打分,而非由单一医生凭印象给出整体评价。这种方法的优势在于可复现、可分解:准确性得分反映回答中正确信息与错误信息的比例,完整性得分反映回答覆盖了多少量表要求的关键点。量表还会标注某些问题“预期容易出现某个具体不准确或有害声明”,从而允许研究单独统计AIO在“陷阱题”上的表现。
一个反直觉的发现:准确性与接地性无关
研究中最耐人寻味的一点是,AIO的准确性与陈述的接地性之间没有关联。这个结果打破了一种直觉假设——即引用的来源越可靠、引用与陈述越吻合,答案就越准确。实际上,AIO可能引用了不支持的来源却给出正确答案,也可能引用看似相关却得出错误结论。
这一发现对产品改进方向有直接含义:单纯提升引用展示或引用覆盖率,未必能提升答案质量。接地性和准确性更像是两个需要分别优化的维度,而非同一问题的两面。
建议与启示
研究者提出两项建议。其一,面向用户开展AIO素养干预(AIO literacy interventions),帮助用户理解AI概览的来源选择逻辑与局限,不把概览当作终点而是起点。其二,要求AIO至少达到谷歌自身对健康信息的排名标准——既然传统搜索有一套质量把关机制,AI概览没有理由不受同样约束。
对普通用户而言,实用的做法是:看到AIO的健康建议时,主动点开引用链接核对原文,尤其留意那些没有引用的事实陈述;对产品方而言,这项研究提示信源结构、接地校验与完整性表达是三个独立的改进方向,而非一次调整就能一并解决。
相关推荐
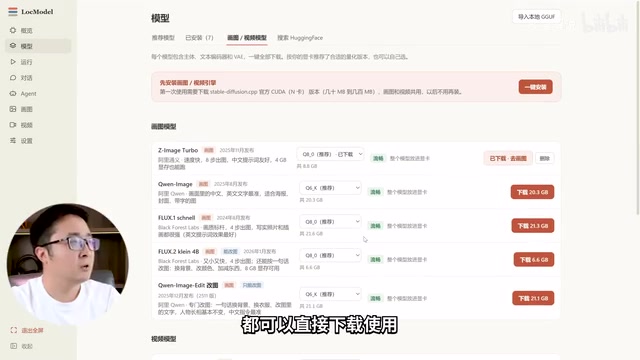
本地AI部署神器LocModel:一键玩转开源模型与AI生成
LocModel是一款本地AI部署工具,可自动适配硬件、一键下载开源模型,支持图片生成、视频生成、无审查大模型和Agent智能体,完全免费。本文基于实测视频介绍其安装与使用流程。

Antigravity CLI:终端免费调用Gemini与Claude顶级模型
Antigravity CLI(agy)宣称可在VS Code终端免费调用Gemini 3.1 Flash、Claude Sonnet等顶级模型,几秒完成安装。本文拆解其使用流程、终端内调用模型的价值,以及免费宣称背后需要核实的安全与可持续性问题。

聊天机器人与AI智能体:核心区别与选型指南
聊天机器人与AI智能体到底有什么区别?本文从工具、记忆、工作流三个维度拆解两者差异,用整理收件箱、安排会议等四个真实场景对比,并给出权限控制、不可逆操作确认等风险防范建议与选型判断标准。