谷歌Antigravity入门与省钱实战:内建指令+徒弟问师傅

用BOST指令与徒弟问师傅法,把Antigravity低端模型用出顶级效果并榨干双份额度。
文章基于B站UP主近一年的实战经验,系统拆解谷歌AI编程工具Antigravity的入门与省钱路径。它因不封号、模型丰富、闲鱼账号便宜,正成为Codex和Claude Code的替代品。核心技巧有两个:一是内建指令BOST,通过多智能体编排把Gemini 3.8 Flash的准确率从30%-60%提升到约90%,接近一线模型;二是"徒弟问师傅"法,利用网页版与桌面端额度分离,让桌面端低端模型整理上下文提问、网页版Gemini 4负责规划,从而一个账号吃两份额度。配套的开源插件AgentLimb则打通桌面端与浏览器,支持多Agent、多账号、多页面操作,形成完整流水线。
谷歌的AI编程工具Antigravity长期低调,但凭借不封号、模型丰富、闲鱼账号便宜等优势,正被越来越多开发者当作Codex和Claude Code的替代品。B站UP主用近一年实战经验,拆解了从入门到省钱的完整路径:用内建指令让低端模型"超频",用"徒弟问师傅"法榨干网页版高端额度,再通过自研浏览器插件把桌面端和网页端串成一条流水线。
Antigravity是什么,为什么现在值得关注
Antigravity是谷歌的AI智能代理编程工具,定位与Codex、Claude Code同类。UP主在视频中强调,从资历上看它其实是这类AI Agent产品中最早出现的,只是谷歌风格不张扬,导致产品一直不太出彩。
近期它重新进入视野有两个现实原因:Claude Code封号较多,Codex额度下降明显。而Antigravity在闲鱼上十几块钱就能买到账号,模型列表里既有Gemini最新模型,也有Gemini 3.8 Flash这类中低端模型,甚至还能用到Claude Code 5.5、Opus和Sonic。UP主本人使用20美金账户,额度结构与闲鱼学生套餐、手机免费套餐类似。
额度面板分三块:Gemini 3.8单独一块,Claude Code与Opus等模型共用一块并按周和每五小时限额,Gemini 4又是单独一块。UP主提醒,Gemini 4和Opus这些高级模型额度掉得非常快,20美金账户大概只够用一天;而Gemini 3.8 Flash额度大到不可思议,非重度使用能撑一周。
核心技能:用BOST指令让低端模型"超频"
这是整期课程最重要的知识点。UP主直言,Gemini 3.8 Flash被戏称为"美国版豆包",直接提问正确率可能只有30%到60%,一分钟就草草结束。但输入斜杠调出内建指令BOST后,同一个模型的表现会截然不同:准确率能到90%左右,接近一线模型水平,回答时长会拉长到规划非常复杂的任务,甚至一个小时都跑不完。
BOST的本质是调用多智能体编排,把问题拆得很细一步步回答。UP主用真实项目验证过:让Flash模型重构软件、开发游戏,开启BOST后几乎无错误。他的建议很直接——用低端模型时毫不犹豫开启BOST,这是把低级模型拉到顶级模型品质的关键。
除BOST外,还有几个值得记住的内建指令:learn让系统反思并总结最近的成功经验,grab me让AI像面试官一样反问对齐需求,plan用于项目启动阶段的规划。指令可以组合使用,比如先BOST再plan,先提升能力再展开计划。UP主特别指出,Antigravity与Codex、Claude Code的一个差异在于,后两者会自动寻找并调用这些策略,而Antigravity需要用户明确输入指令。
**多智能体编排(Multi-Agent Orchestration)**指的是由多个具备不同角色或分工的 AI 智能体协同完成一项任务的架构:通常包含规划者、执行者、审查者等角色,彼此通过消息传递拆解目标、分派子任务、交叉验证结果。相比单轮问答,它能显著降低复杂任务的出错率,代价是调用次数和耗时成倍增加。这也解释了为什么开启 BOST 后同一个低端模型准确率大幅上升、运行时间却可能拉长到一个小时——本质上是把一次粗放回答换成了多轮分解、执行与复核的流水线。
徒弟问师傅:让网页版高端模型替桌面端干活
海外AI公司普遍有两套计费:网页版聊天不能控制电脑,能编程的桌面端可以看本地文件,两者额度分开。这带来一个套利空间——桌面端高级模型用完时,网页版Gemini 4的额度往往还有富余。
UP主的方案叫"徒弟问师傅":桌面端的低端模型当徒弟,负责调查本地文件、整理需求、形成好问题;网页版Gemini 4当师傅,负责规划、解释、给方案,但看不到本地情况,全靠徒弟把上下文喂过去。徒弟拿到回答后只负责执行,不做决策。他打了个比方:总工负责计划,工人负责干活,总工看不见现场,所以工人必须把现场情况问清楚。
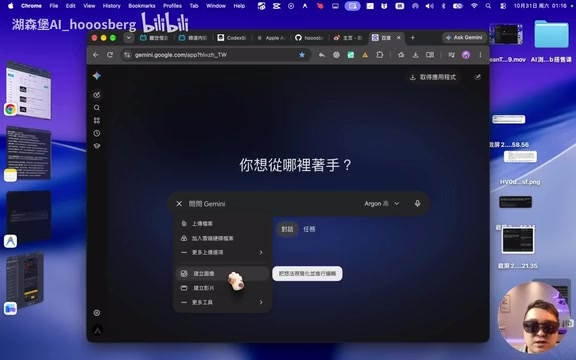
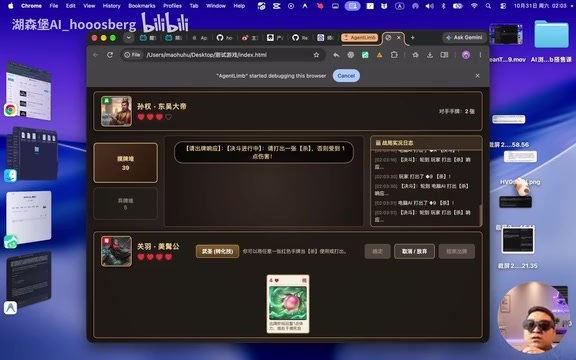
网页版Gemini的能力被UP主认为是最慷慨的一环:能生图、每天有免费额度的生视频、能创作音乐,还有Deep Research。他做的三国杀卡牌游戏,背景图、卡牌素材、背景音乐全部由网页版Gemini生成,桌面端低端模型负责切图、落盘、接入游戏。整个项目花三四天,用的就是20美金账户。
**上下文(Context)**指模型在生成回答时能"看到"的全部信息,包括对话历史、上传的文件内容、检索到的资料以及系统提示。模型本身无法访问用户本地磁盘或运行环境,它对这些情况的判断完全依赖被放进上下文的内容。因此"徒弟问师傅"能否奏效,关键在于徒弟是否把本地文件结构、报错信息、需求约束等整理成清晰、完整且不冗长的上下文传给师傅:信息缺失会导致方案脱离实际,信息冗余则会挤占上下文窗口、抬高成本并稀释重点。
AgentLimb插件:打通桌面端与浏览器的桥梁
桌面端和网页端要联动,需要一座桥。UP主半年前自研了Chrome内核浏览器插件AgentLimb,已打磨半年并开源,支持Windows和macOS。安装最简单的办法是把GitHub链接丢给AI,让AI自动完成;手动安装则需注意Windows下插件目录必须全英文路径,并在扩展管理页打开开发者模式后加载解压包。
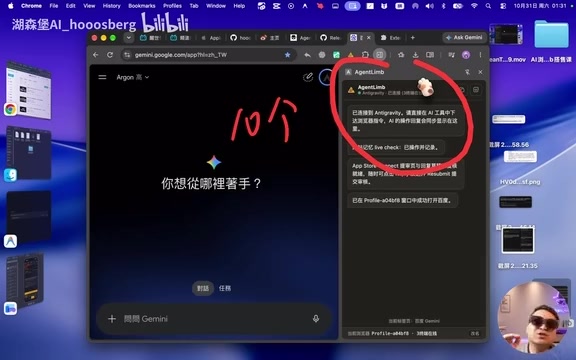
插件的能力不止于连接Gemini:它能多Agent、多页面、多账号同时操作浏览器,通过不同的profile避免重复登录,UP主用它管理多个B站账号并自动上传视频。他提到一个现实痛点——每家AI公司都做自己的Chrome插件且互不通用,AgentLimb的定位就是用一个提示词统一指挥所有Agent对浏览器的操作。
**浏览器 Profile(用户配置)**是 Chrome 及同内核浏览器中彼此隔离的一套环境,包含独立的 Cookie、登录状态、本地存储和扩展配置。用不同 profile 启动多个浏览器实例,就能在同一台机器上同时保持多个账号的登录态而互不干扰,这也是多账号自动化操作的基础。需要注意,多数平台的服务条款对自动化多账号操作有明确限制,实际使用时应自行评估合规与封禁风险。
实战演示与省钱逻辑
视频中UP主完整演示了流程:指定桌面文件夹,让Flash模型带着"测试游戏"需求去问网页版师傅,师傅返回贪吃蛇或三国杀的MVP规划,徒弟自动落盘并开始开发。中间模型会自动确认连接、截图判断页面、整理提问,全程无需手动复制粘贴。他刻意没开BOST以加快演示节奏,并说明认真做项目时应开启。
省钱逻辑可以归结为两点:一是用BOST把Flash拉到接近顶级模型的水准,减少对高价模型的依赖;二是用徒弟问师傅把网页版额度也榨干,等于一个账号吃两份额度。UP主的态度很务实——不差钱可以直接上Claude Code商业版,预算有限就用这套方法达到接近的效果。他也提醒,做任何AI项目先让高级模型写计划、做MVP最小可行性验证,再让低端模型执行,不要一上来就盖高楼。
相关推荐

MiniMax H3开源工作流:低显存也能打造呼吸感皮肤
本文介绍B站UP主分享的MiniMax H3双采样工作流,通过融合模型、破线LoRA和低显存节点,解决AI人物面部油腻问题,并让12G显存设备也能运行。包含模型搭配、双采样逻辑与参数设置详解。

手机本地大模型+ESP32:自制热量提醒器
B站UP主开源了一个热量摄入提醒器项目:手机APP用miniCPM开源模型本地拍照识别食物并估算热量,ESP32小屏幕同步数据,用绿黄红圆环展示摄入状态,可磁吸在冰箱门上随时提醒。

12GB显卡跑125B MoE?Strata三级协同引擎解析
开源C++引擎Strata让12GB-16GB家用显卡本地跑125B MoE模型,生成速度达40-95 Token/s。本文拆解其显存、内存、固态三级协同原理,说明模型选型前提、硬件配置门槛与启动方式。