谷歌EmbeddingGemma 2开源:端侧多模态嵌入新选择

谷歌发布端侧多模态嵌入模型,OpenAI数学成果引发学界争议,AI落地瓶颈从模型转向生态规范。
本期科技动态围绕AI能力下沉与规范建设两条主线展开。谷歌发布7.4亿参数的EmbeddingGemma 2,以极低内存占用将文本、图像、音视频统一映射到同一向量空间,为端侧RAG和本地搜索提供新基础积木。OpenAI公布722份AI生成数学手稿,但多位菲尔兹奖得主和独立咨询小组对其认可度和营销导向持明显保留态度,AI产出成果的学术规范问题随之浮出水面。Anthropic将网络安全项目整合为分级核验计划,数月内核实逾12.9万个漏洞,试图以可审计的框架平衡能力开放与滥用风险。此外,智能体落地受制于网站反机器人防御,新标准正尝试为机器访问建立可控规则,这被视为智能体从演示走向日用的关键一步。
谷歌推出EmbeddingGemma 2:多模态嵌入进入端侧时代
谷歌正式发布了 EmbeddingGemma 2,一款把文本、代码、图像、视频和音频统一映射到同一嵌入空间的多模态嵌入模型。据 IT 之家援引谷歌博文报道,该模型总参数量约 7.4 亿,基于 Gemma 架构,并以商业友好的 Apache 2.0 许可开放权重,开发者已可在 Hugging Face 和 Kaggle 下载使用。
对开发者而言,最有吸引力的点在于端侧运行成本。量化后的纯文本版本在 Pixel 级手机上大约只需 191MB 运行内存,完整多模态版本约 567MB。模型还支持将输出向量截断到更低维度,本地存储占用最多可降至原来的六分之一。这意味着本地搜索、代码检索、离线 RAG 等场景可以在移动设备或轻量硬件上直接跑起来。
谷歌称其在小尺寸多模态嵌入模型中基准成绩领先——这属于厂商自测结果,实际效果仍需开发者自行验证。但把多模态能力压缩到亿级参数并开放权重,本身就为端侧 AI 应用提供了一块新的基础积木。
嵌入模型(Embedding Model)是一类将不同形式的数据(文本、图像、音频等)转化为高维数值向量的模型。这些向量在空间中的距离反映了语义相似度——意思相近的内容会被映射到彼此靠近的位置。多模态嵌入的关键在于将不同模态的数据映射到同一向量空间,使得"一张猫的照片"和"描述猫的文字"可以直接比较距离,而无需分别处理。这项技术是语义搜索、跨模态检索和 RAG(检索增强生成)的底层基础。RAG 是指在向大语言模型提问前,先用嵌入向量从知识库中检索相关内容再一并送入模型,以弥补模型知识截止日期的不足、减少幻觉。EmbeddingGemma 2 的端侧价值正在于此:过去 RAG 通常依赖云端 API 完成检索,本地化部署可显著降低延迟与隐私风险。
OpenAI 发布海量数学成果,数学圈反应复杂
据 IT 之家报道,OpenAI 公布了一批规模很大的数学研究成果,包含 722 份手稿与 372 个结果,官方称这些成果由一款尚未发布的前沿模型完成,涉及对数百个长期未解决问题的解答,文稿中还附带推理过程摘要和算力估算。OpenAI 提到,一项普通成果的算力消耗大致相当于 ChatGPT Pro 连续思考约 3 小时。
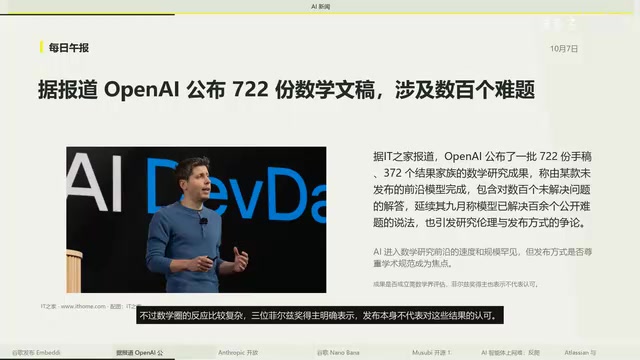
数学界的态度则较为谨慎。三位菲尔兹奖得主明确表示,发布本身并不代表对这些结果的认可。负责沟通的独立咨询小组此前也呼吁,不要把数学成果当作模型营销手段。这批结果仍需数学家花时间评估消化,完整影响要过一段时间才能看清。
更现实的问题是:AI 产出的数学成果应该走怎样的学术渠道?如何向人类数学家既有的工作致谢?这些规范问题,可能比成果本身更需要行业回答。
Anthropic 整合网络安全核验计划
据路透社报道,Anthropic 把过去半年运行的两套项目整合成新的网络核验计划,分为防御、红队、专项三个层级。通过资质审核的网络安全人员,可以使用放宽了网络限制的模型,包括 Claude Opus、Sonnet 等较强版本,每名参与者还会与美国政府共同审核。
数据层面颇为可观:合作方在数月间至少找到 12.9 万个已核实漏洞,其中超过 3.3 万个被评为严重或高危,Anthropic 自己的扫描又额外发现约 5500 个。公司也坦承这些数字很可能有遗漏,实际影响可能是目前的数倍。
这套分级审核机制,一方面让安全从业者使用最强模型做漏洞研究的路径更清晰,另一方面也在正面回应「AI 会不会被滥用于攻击」的担忧——用可控的审核框架平衡能力开放与风险。
**红队(Red Teaming)**在网络安全语境中指模拟真实攻击者行为、主动发现系统漏洞的专项测试活动,与"蓝队"(防御方)相对。将其引入 AI 安全领域后,红队人员专门尝试诱导模型产生有害输出、绕过内容过滤,从而在模型公开部署前暴露潜在风险。Anthropic 将核验计划分为防御、红队、专项三层,本质上是将攻防两端都纳入受控框架:防御层帮助安全从业者用 AI 发现和修复真实漏洞,红队层则允许研究人员合法测试模型的攻击潜力上限。这套分级机制的核心逻辑是"可审计的能力开放"——不是完全封锁高风险功能,而是通过资质审核和政府联合审查将使用者限定在可信范围内,兼顾研究价值与滥用风险控制。
图像与开源生态:Nano Banana 2.1 与轻量审核模型
谷歌的图像模型 Nano Banana 2.1 也同步到来。据 IT 之家报道,本次升级集中在三个方向:视觉设计上构图更完整;蒙版编辑可以更精准修改画面局部而无需重新生成整张图;主体一致性在反复编辑或批量生成时能让人物和物体样貌保持统一。最后一点对做连续分镜或批量出图的用户尤其实用——主角不会每张都「变脸」。该模型已逐步上线 Gemini 应用、AI Studio、Flow 等多个入口,支持文本、图片、音频、视频输入,可输出 1K 到 4K 分辨率。
开源生态还有一条具体消息。据 TechCrunch 报道,一家名为 Mausibi 的公司发布了专门做内容审核的轻量决策模型 Policy-LM,以开放权重方式释出,定位是实时审核场景中的决策环节。内容审核历来是平台运营中又贵又累的活,如果一个 1.7B 级别的小模型能在本地快速做初步判断,中小团队的成本结构可能会发生变化。不过该消息细节仍较有限,模型在真实审核中的准确率和边界尚待核实。
智能体落地的现实瓶颈与企业合作
智能体是当下最热的方向之一,但它撞上了一个很现实的坎。据 TechCrunch 报道,个人 AI 智能体理论上可以替你购物、订机票、订餐厅,可一到执行环节,很多网站的刻意封锁和反机器人防御就把它们挡在门外,消费者反而被夹在中间。
报道提到,目前有一项新标准正在尝试解决这个问题,让网站可以用可控的方式对智能体放行。这件事的意义在于:智能体的能力瓶颈未必在模型本身,而在于整个互联网愿不愿意为机器访问立规矩。如果标准被广泛采纳,智能体从演示走向日常使用的速度可能会明显加快。
企业侧,Atlassian 与 OpenAI 宣布扩大合作,方向是把前沿模型与企业知识库连接起来,帮助团队更好地规划、构建和交付工作。想象空间在于,散落在文档、任务和代码里的知识,未来可能由模型直接梳理成可执行的行动建议,而不必靠人去翻资料。官方暂未披露具体产品形态和上线时间,但这代表了一个趋势——大模型正从聊天窗口走进企业的日常工作流。
文中提到的"新标准"指的是目前业界正在探索的 Agent 授权协议方向,其中较受关注的是类似 agents.txt 或基于 OAuth 扩展的机制——类比于过去 robots.txt 文件告诉爬虫哪些页面可抓取,新标准希望让网站能够声明"哪些智能体可以以何种权限执行哪些操作"。当前智能体访问网站时面临的主要障碍包括:CAPTCHA 验证、行为指纹识别、IP 速率限制,以及网站在法律和责任层面对自动化操作的顾虑。一旦有通用标准落地并被主流平台采纳,智能体就能以可识别、可授权的身份与网站交互,网站也能有据可依地追责或计费,从而打通"模型能力已足够、但执行层被挡在门外"这一现实瓶颈。
相关推荐
用n8n搭建WhatsApp智能线索自动化:AI分级让商机不再流失
拆解一个基于n8n的WhatsApp线索自动化工作流:用AI把客户消息分为hot/warm/cold四级,自动应答并评分,仅在高价值线索出现时通知老板,帮助中小企业高效管理商机、节省人力。

Arabagent.ai:面向中东市场的托管式N8N自动化方案
Arabagent.ai 面向中东市场提供托管式 N8N 自动化服务,含私有工作空间、无限工作流执行、AI 自愈架构及阿拉伯语双语支持,兼顾开源可控性与 SaaS 便捷。

用 n8n 打造 Gmail→Google Sheets 自动化 CRM 实战教程
手把手教你用 n8n 搭建 Gmail 到 Google Sheets 的 AI 自动化 CRM:收到邮件自动触发,由 OpenAI 读取理解内容并提炼任务信息写入待办表格,含触发器、AI 智能体、提示词与 Sheets 工具的完整配置步骤。