谷歌发布 Gemini 3.8 Live:语音 AI 迈向实时推理时代
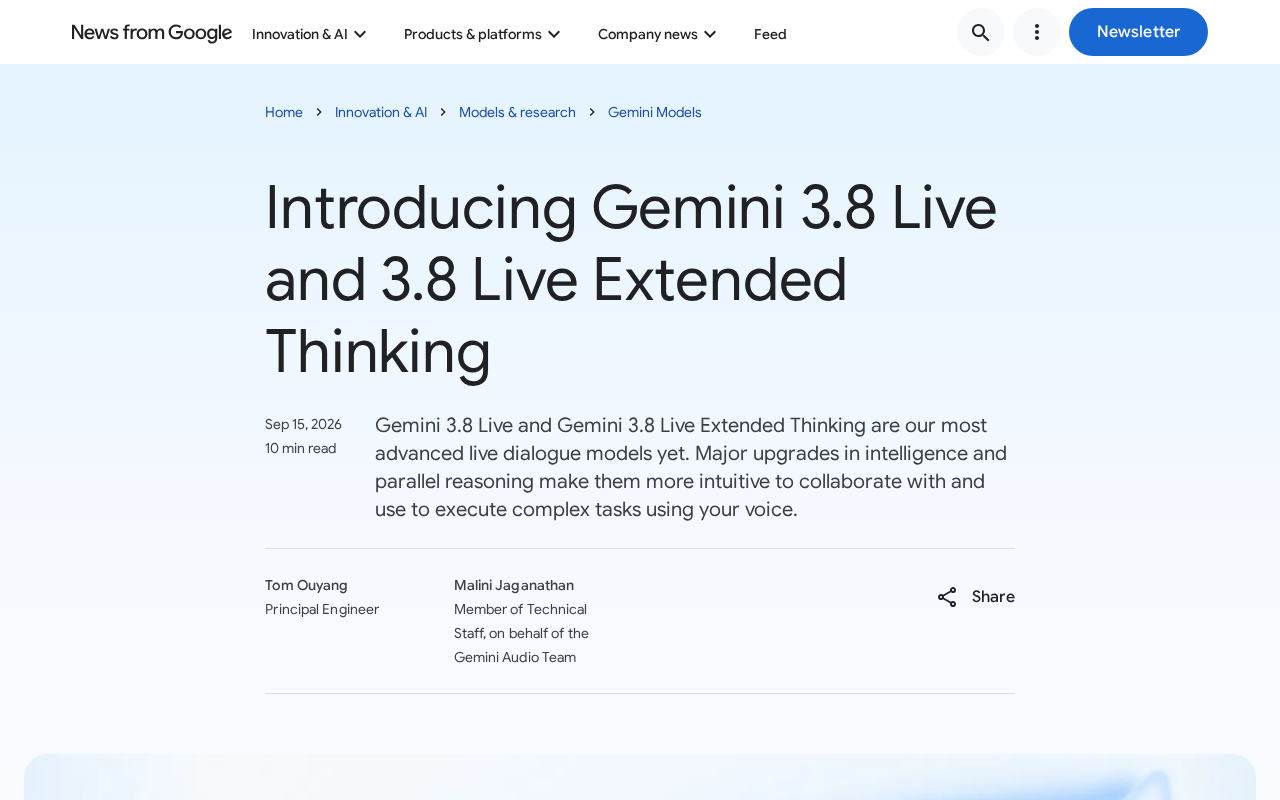
谷歌推出两款实时语音模型,将并行推理与后台任务执行引入连续对话,语音AI从问答走向协作。
谷歌发布 Gemini 3.8 Live 与 Gemini 3.8 Live Extended Thinking,前者面向高并发、成本敏感的生产场景,后者专为多步骤复杂推理设计。两款模型的核心突破在于"边推理边说话"与"后台非阻塞任务执行",彻底消除了传统语音助手等待时的静默尴尬。Extended Thinking 在语音到语音质量指数上以 82.6 分拿下第一,并在多项智能体基准中领先。在生态层面,谷歌通过 Gemini Live API 接入 LiveKit、Vercel 等开发者平台,并与 Salesforce 等企业客户展开合作,同时为所有 AI 音频输出内嵌 SynthID 水印以保障内容可溯源性。这次发布标志着语音交互从"命令-响应"范式向"持续协作"范式的实质性迈进。
谷歌推出了两款全新的实时对话模型——Gemini 3.8 Live 与 Gemini 3.8 Live Extended Thinking,将语音交互从简单的问答带向了具备并行推理与后台任务执行能力的新阶段。这两款模型即日起通过 Gemini API、Google Workspace 与 Gemini 应用陆续开放,目标是让"和 AI 说话"这件事真正接近人与人之间的自然协作。
两款模型的定位差异
谷歌这次一次性推出两个版本,分工相当明确。
Gemini 3.8 Live 面向规模化与成本效率场景,把对话智能、流畅的语音交互和视觉理解结合在一起。它更适合需要大量并发、对成本敏感的生产环境,比如客服语音助手、实时导览等。
Gemini 3.8 Live Extended Thinking 则专为高复杂度任务打造,强调更强的智能与多步推理能力。它能够在"边想边说"的同时处理复杂工作流,适合需要深度思考的场景,例如把草图转化为可运行的 React 组件、协调多步骤预订流程,或是在对话中现场搭建完整的商业计划。
这种"轻量高效"与"深度推理"双轨并行的产品策略,反映出语音 AI 正在从统一大模型走向按需分层——用户不必为简单对话支付复杂推理的成本,也能在需要时调用更强的思考能力。
基准测试成绩亮眼
从谷歌公布的数据来看,Extended Thinking 版本的表现相当强势。
它在 Artificial Analysis 的语音到语音质量指数(Speech to Speech Quality Index)上以 82.6 分拿下总榜第一,并在智能体任务完成方面领先:τ-Voice 基准得分 68.6%,Sierra 的 τ-Voice-banking 基准得分 35.1%。在推理能力上,它在 Big Bench Audio 上取得了 97.7% 的成绩,同时保持了相较其他前沿模型颇具竞争力的价格。
轻量版的 Gemini 3.8 Live 也不逊色,在 Speech Agent Arena 中获得用户偏好度第二名,同时以高性价比著称。在 ServiceNow 的 EVA-Bench(评估语音智能体的基准)上,两款模型都推动了帕累托前沿——在准确性与对话质量之间取得了更好的平衡。
需要注意的是,这些成绩基于谷歌自身平台运行,实际部署效果仍需第三方独立验证。但这套覆盖"质量、智能体任务、推理"的多维度基准,至少说明谷歌在评估语音模型时并非只看单一指标。
τ-Voice 基准是由斯坦福大学研究团队设计的语音智能体评估框架,名称中的"τ"(tau)代表"任务自动化"(Task Automation)。与传统的语音识别准确率或合成自然度指标不同,τ-Voice 侧重衡量模型在真实多轮对话场景中完成端到端任务的能力,例如预约挂号、处理退款投诉等,需要模型同时具备语音理解、工具调用和多步骤规划能力。Sierra 的 τ-Voice-banking 是其金融服务垂直版本,专门测试银行客服场景下的任务完成率,因此 35.1% 的得分需要在"金融领域专业门槛高、容错率低"的背景下解读,并非绝对意义上的低分。Artificial Analysis 的语音到语音质量指数则是一个综合性排行榜,将延迟、自然度、准确性等多维度数据加权合并为单一分数,便于跨模型横向比较,但其加权方式由第三方机构自行定义,使用时需留意权重设定是否符合目标场景的优先级。
让对话真正"不被打断"
这次升级最实用的变化,在于交互体验的自然度。
Gemini 3.8 Live 能够近乎实时地处理视觉输入,用画面语境让回答更有针对性。它还支持在对话中自动检测并切换 97 种语言,无需手动指定。更关键的是,它可以在后台执行工具调用和 API 请求,同时保持对话继续——模型会先确认你的请求,然后一边聊天一边完成任务。
Extended Thinking 则进一步做到"边推理边说话"。它会用类似"让我查一下……"这样的早期语言提示来自然地回应,并通过实时进度叙述,向用户讲解多步骤后台任务的进展。谷歌展示的演示包括:实时指导员工入职、用视觉语境下棋、把手绘草图转成功能组件等。
这种"acknowledge and continue"的机制,解决了以往语音助手最大的痛点之一:等待时的尴尬静默。当 AI 能像人一样说"稍等我看看",交互的心理体验会明显改善。
"acknowledge and continue"机制在语音交互设计中对应的是**对话状态管理(Dialogue State Management)**中的"非阻塞确认"模式。传统语音助手采用"请求-等待-响应"的串行架构:模型在完成后台处理之前无法输出任何语音,导致用户感知到明显的静默等待。这种等待在心理学上会触发"交互中断感",用户往往误以为系统崩溃或未识别请求而重复说话。非阻塞确认的核心在于将"任务执行"与"对话维持"解耦,模型在调度后台工具调用的同时,通过生成轻量的自然语言进度叙述(如"我正在查询你的航班信息,稍等片刻……")来持续占据对话信道,从而消除主观等待感。这一设计更接近人类电话客服的实际行为模式,也是语音智能体从"单轮问答"迈向"持续协作"的关键交互范式转变。
面向开发者与企业的生态布局
谷歌显然不只想做一个消费级功能,而是希望把 Live 模型变成语音智能体的基础设施。
通过 Gemini Live API,Agora、Fishjam、LiveKit、Pipecat、Vercel、Vision Agents 等开发者平台已经可以帮助开发者快速构建和部署高性能语音界面。这些平台在幕后处理复杂的实时媒体流基础设施,让开发者专注于打磨用户体验。
在企业侧,谷歌与 Salesforce、Genspark、Lumeris 等公司展开合作,这些客户看重的正是模型的低延迟、流畅度与工具调用能力。这三点恰恰是生产级语音智能体最核心的门槛。
此外,所有由谷歌 AI 生成的音频都带有 SynthID 水印。这种人耳无法察觉的水印直接嵌入音频输出,确保 AI 生成内容可被检测,以帮助防范虚假信息——在语音克隆技术日益成熟的当下,这一透明度机制颇具现实意义。
SynthID 是谷歌 DeepMind 开发的 AI 内容水印技术,最初用于图像,后扩展至文本和音频领域。其核心原理是在生成过程中对输出的底层数据(如音频的频谱特征或文本的词元分布)进行微小的统计性扰动,这些扰动在人类感知层面不可察觉,但可被专用检测算法以高置信度识别。与在文件元数据中附加标记的传统方案不同,SynthID 水印直接嵌入内容本身,即使经过压缩、剪切或格式转换,检测鲁棒性依然较高。在音频场景中,这意味着即便将 AI 语音录制后重新上传为普通音频文件,仍可追溯其 AI 生成来源。在语音克隆诈骗(Voice Cloning Fraud)日益普遍的背景下,这一机制为内容溯源提供了技术基础,但其有效性最终取决于检测工具的普及程度与平台的强制验证意愿。
开放范围与可用性
两款模型即日起分批推出:
- 开发者:可在 Gemini API 与 Google AI Studio 中使用 3.8 Live 和 3.8 Live Extended Thinking。
- 企业:在 Gemini Enterprise 中提供私有预览,并将陆续登陆 Gemini Enterprise for Customer Experience。
- 普通用户:3.8 Live 进入 Search Live;Extended Thinking 进入 Gemini Live,Google AI Pro 与 Ultra 订阅用户可在 Workspace 的 Docs 中使用,所有 Google AI 订阅者可在 Gmail 和 Keep 中体验。
结语:语音 AI 的下一个拐点
Gemini 3.8 Live 系列最值得关注的,不是某个单一的跑分成绩,而是它把"实时推理""后台任务执行""视觉语境""多语言切换"整合进了同一次连续对话中。当 AI 能够在你说话的同时思考、执行、并如实反馈进度,语音交互才真正从"命令-响应"进化为"协作对话"。对开发者和企业而言,这套具备低延迟与可靠工具调用能力的模型,或许正是构建生产级语音智能体所缺的那块拼图。
相关推荐
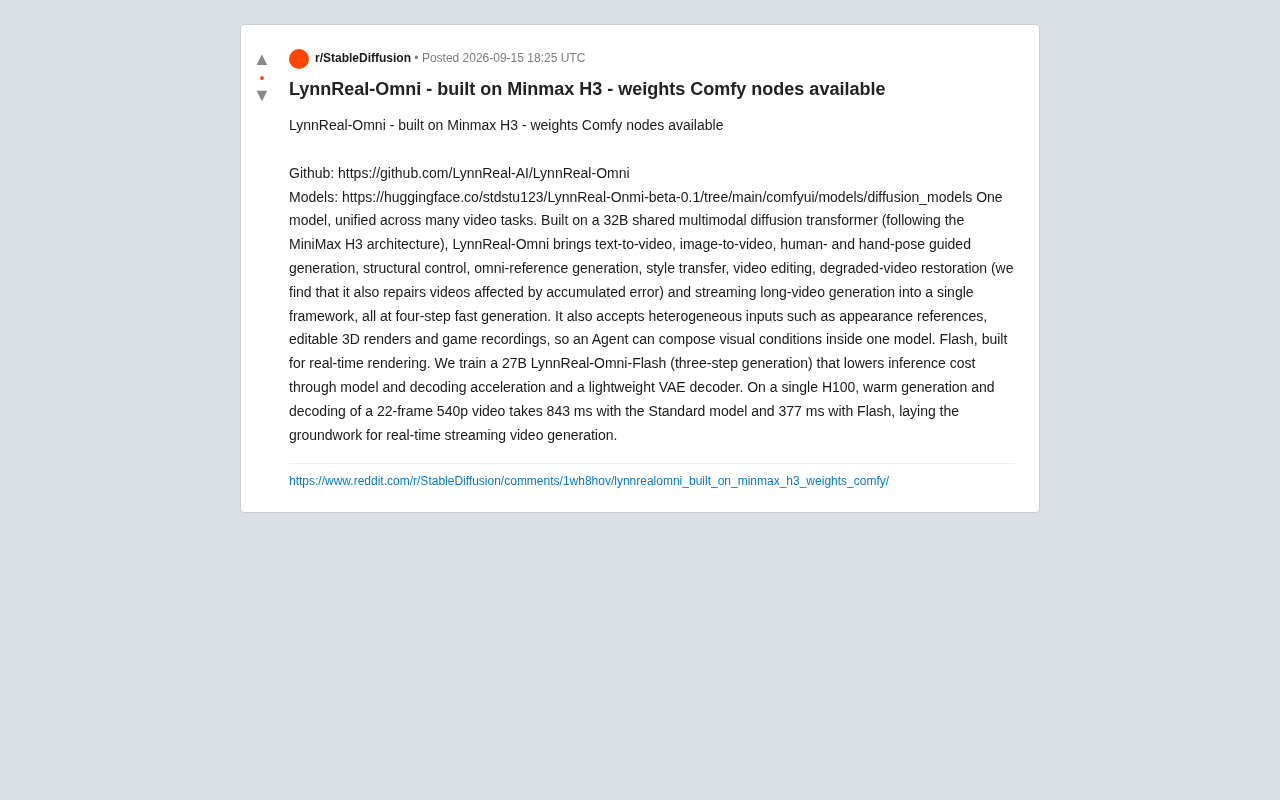
LynnReal-Omni:32B统一视频扩散模型开源,四步生成多任务全覆盖
LynnReal-Omni 是基于 MiniMax H3 架构的 32B 统一视频扩散模型,支持文生视频、图生视频、姿态引导、视频修复等多任务,四步快速生成,Flash 版单张 H100 上 377ms 完成 540p 视频,权重与 ComfyUI 节点已开源。

Anthropic联合创始人:AI"紧急停止开关"或应强制立法
Anthropic联合创始人向BBC表示,AI系统的"紧急停止开关"(kill switch)可能需要通过法律强制推行。本文分析这一呼吁背后的产业逻辑、技术挑战以及监管与创新之间的张力。

AI数据中心建设热潮,正冲击工业创伤深重的城市
AI数据中心建设热潮正与曾受重工业创伤的城市社区激烈碰撞。以费城为例,全国性反对声浪聚焦能耗、水资源与环境公平问题,揭示AI增长与地方利益的结构性冲突。