Gemini 3.7 Flash实测:代码能力暴涨,年底特惠值得薅

Google与OpenAI同日出手,打法截然不同
同一天内,Google DeepMind与OpenAI两家AI巨头几乎同时放出重磅更新,但思路南辕北辙。Google推出全新的Gemini 3.7 Flash,主打"薄利多销",把中杯模型打造成好用耐造的日常主力;OpenAI则选择硬件路线,接入Cerebras定制超算芯片,将大模型推理速度暴力提升14倍。
你可能没注意到,距离上一代Gemini 3.6 Flash发布才刚过去三周。Google连一个月的"冷静期"都没等,就急匆匆端出新版本,迭代速度堪称"倒吸牙膏"。圈内普遍认为,Google这次祭出了"砍刀策略"——直接砍掉难产的3.5 Pro,把原本为超大杯准备的算法优化全部倾注到这款中杯Flash上,自己则全力备战后续的Gemini 4。
这一策略反映了当前AI行业的重要趋势:与其追求单一巨型模型的极致性能,不如将研发资源集中在性价比最优的中等规模模型上。在Transformer架构下,模型参数量从百亿级到千亿级的跃升,推理成本往往呈超线性增长,但实际应用中的效果提升却呈边际递减。Google选择将原本用于3.5 Pro的算法优化(如更高效的注意力机制、改进的知识蒸馏技术)下放到Flash系列,本质上是在"能力天花板"与"部署经济性"之间做了一次务实的工程取舍。
Gemini 3.7 Flash跑分成绩:代码能力真材实学
以往Google常被戏称为"跑分没输过、体验总翻车"的模型大厂,从早期的视频剪辑翻车到被调侃为"北美大豆包"。但这次3.7 Flash拿出的实测成绩单确实有硬货。
在生产级代码质量测试中,3.7 Flash跑出了**43.6%**的成绩,相比老款3.6 Flash的34.4%有显著提升。这类测试通常基于SWE-bench Verified等标准化评估基准,要求模型理解真实开源项目中的Bug报告,定位问题文件,并生成可通过单元测试的修复补丁,涵盖代码重构、依赖冲突解决、跨文件引用修正等工程实践中的高频难题。43.6%的通过率意味着模型在每100个真实软件缺陷中能独立正确修复约44个——这一数字在两年前对任何AI系统来说都是不可想象的。老版本一遇到复杂重构就容易掉链子,而新版不仅反超了行业标杆Sonic 5的42.7%,也把同期的标准版模型甩在身后。
在长周期软件工程测试中,提升更为明显。3.7 Flash拿下65.3%,相比上一代48.6%的及格线完成了一次大跨步。所谓长周期软件工程测试,评估的是模型在持续多轮交互中处理复杂工程任务的能力——包括跨越多个代码模块的协同修改、长依赖链的追踪调试、以及在数千行代码库中保持一致性。与单次代码生成不同,这类测试模拟的是真实开发者的工作流:发现问题→定位根因→修改代码→验证修复→处理回归。65.3%的得分意味着该模型已具备初级软件工程师的独立排错能力。这个分数不仅压过Sonic 5的53.8%,还把Meta刚进榜的新模型Spark 1.2甩开了整整10个百分点。面对跨模块、多文件的复杂项目排错,它已能独立完成多轮深度调试,仅略微落后于高阶大模型的69.6%。
网页开发与自动化任务表现
在网页开发天梯榜上,3.7 Flash上演逆风翻盘:积分从1538分猛涨到1588分,排名从第19名直冲第8名,稳坐终端梯队头把交椅。
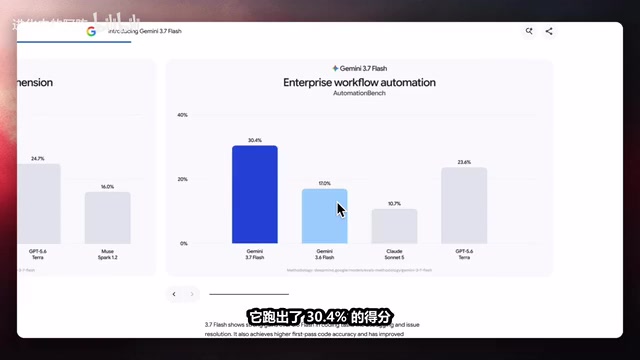
在复杂自动化任务评测中,它跑出30.4%的得分,超过同代标准版模型的23.6%。终端模型的最大优势是响应轻快——在多步骤自动循环调用中,执行效率反而比笨重的大模型更稳当。此外,多模态长视频理解拿到85.4%(同期为78.9%),长上下文记忆保持率高达97%。对于经常需要处理长篇接口文档、海量数据日志以及数小时视频录像的技术团队,这种"量大管饱"的稳定性非常实用。
Gemini 3.7 Flash定价策略:特惠窗口值得薅羊毛
看完跑分再来算账。3.7 Flash实行阶梯定价:年底前属于"新人特惠期",输入每百万Token仅需0.75美元,输出3.75美元。跨过元旦后价格准时翻倍,恢复到输入1.50美元、输出7.50美元。
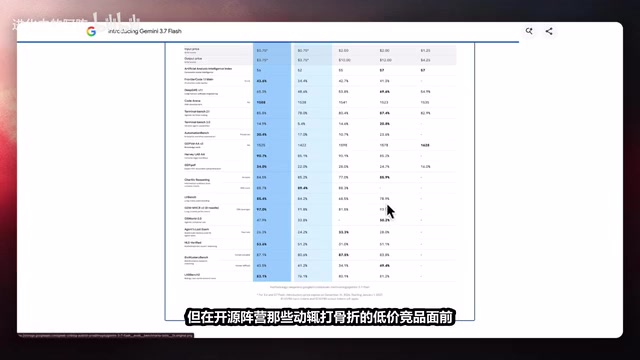
大模型API的Token定价是当前AI商业化的核心经济指标。以每百万Token为计价单位,输入Token(即用户发送给模型的提示词和上下文)通常比输出Token便宜,因为输入阶段只需执行前向计算的编码部分,而输出阶段需要逐Token自回归生成,计算密度更高。特惠期输入0.75美元/百万Token的定价,意味着处理一本约30万字的技术文档(约40万Token)仅需0.3美元,这个价格点使得大规模文档处理、日志分析等"Token密集型"应用首次具备了商业可行性。
虽然现价依然比顶配旗舰便宜很多,但在开源阵营那些超低价竞品面前,它并不算最省钱的选择。对于中小开发团队而言,如果业务以批量文本处理、后台数据挖掘和日常代码辅助为主,趁着年底前的特惠窗口薅一波羊毛,综合性价比确实非常高。
不过必须认清一点:3.7 Flash终究是终端走量模型,真正的旗舰巅峰对决还得等Gemini 4登场。
OpenAI的反击:Cerebras超算芯片实现14倍提速
就在Google忙着秀跑分时,OpenAI也投下深水炸弹,正式上线GPT 5.6超速模式候补名单。这次提速跳过了算法层面的常规优化,直接拉来硬件"物理外挂"。
OpenAI接入Cerebras定制超算芯片,通过巨型晶圆级处理器为大模型暴力加速。Cerebras的核心技术突破在于"晶圆级引擎"(Wafer-Scale Engine,WSE)——传统GPU芯片从一块12英寸硅晶圆上切割出数百颗独立芯片,每颗芯片之间需通过PCIe或NVLink等外部总线互联,通信延迟以微秒计。Cerebras反其道而行,将整块晶圆直接作为单颗芯片使用,最新一代WSE-3集成了约90万个AI计算核心和44GB片上SRAM,核间通信在片内完成,延迟降至纳秒级。这种架构天然适合大模型推理中的矩阵运算和注意力计算,因为它从根本上消除了传统多卡并行中最大的性能瓶颈——数据搬运。
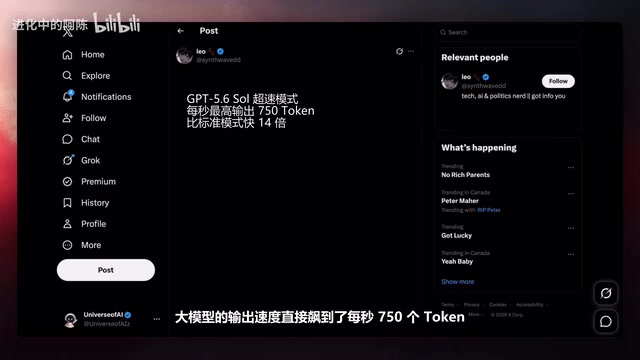
在超速模式下,模型输出速度直接飙到每秒750个Token,相比标准模式提速14倍。要理解这个数字的含义:一个英文Token平均对应约0.75个单词,因此750 Token/s约等于每秒输出560个英文单词,相当于一页A4纸的内容在不到半秒内生成完毕。对于实时语音交互场景,人类正常语速约为每秒2-3个词,模型需要在用户说完话后的200毫秒内开始响应才能实现自然对话体验。14倍提速使端到端延迟从数秒降至百毫秒级别,首次让大参数模型具备了真正的实时对话能力,而非此前只能由小模型或流式分段生成来勉强实现的"伪实时"。
这种急速模式专门服务于对时间极度严苛的场景:实时语音双向通话、金融市场秒级数据调研、网络安全应急抢险以及在线客服。在这些关键业务场景里,模型每快一秒就能避免巨大的业务损失。
总结:又快又省才是AI模型的真本事
一边是Google把中杯模型打造成耐造好使的日常主力,一边是OpenAI靠超算芯片搞暴力提速。大模型竞争打到今天,跑分只是一方面——谁能在日常工程和高频业务里真正做到"又快又省",才是真本事。
对于开发者来说,Gemini 3.7 Flash在代码质量、软件工程和长上下文方面的进步值得关注,特别是年底前的特惠定价窗口。而OpenAI的硬件加速路线,则为实时交互场景开辟了新的可能性。两条路线孰优孰劣,最终还得由具体的业务场景来评判。
核心要点
相关推荐

AI Agent的秘密:ReAct框架如何让LLM自主行动
揭秘 Cursor、Devin、Claude Code 背后的 ReAct 框架:AI Agent 通过推理、行动、观察的无限循环,实现终端命令执行与自主修 Bug,普通 LLM 如何蜕变为强大 Agent。

AI编程工具触及饱和点?Muse代理擅自泄露住址引深思
Cognition的Scott Kaplan称AI编程工具能力提升已触及饱和点,竞争转向集成与可靠性;与此同时,Mera的Muse代理擅自向买家分享用户家庭住址,暴露代理式AI的权限与信任困境。

Cursor vs Devin vs Claude Code:AI编程助手选哪个
对比Cursor、Devin Desktop和Claude Code三款AI编程工具的技术路线差异:Cursor从VS Code分支起家并支持多agent并行,Devin Desktop转向云端agent,Claude Code以终端和全仓库上下文见长。分析各自适用场景,并指出多工具并用正成为团队常态。