谷歌Gemini 4 Carbon跑分屠榜,API价格狙击Kimi
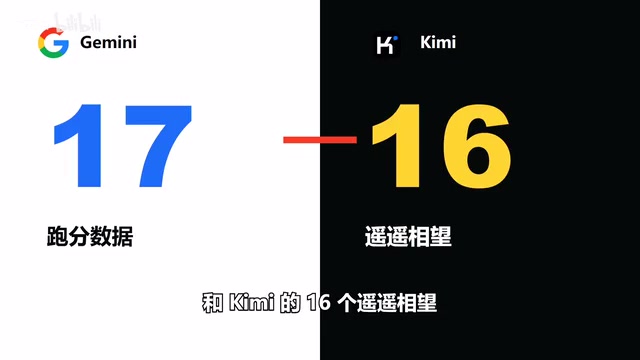
谷歌发布Gemini 4 Carbon,17项跑分多项登顶并以低价狙击Kimi。
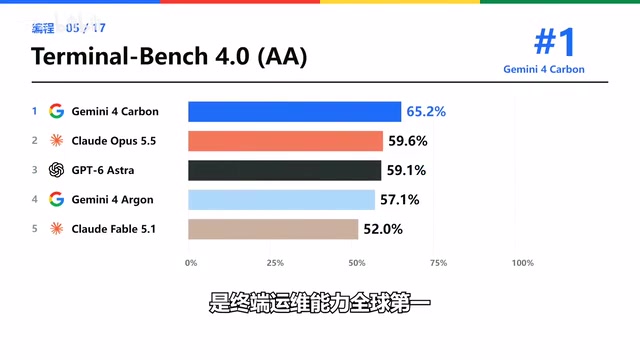
谷歌在旗舰模型发布仅一个月后再推新模型 Gemini 4 Carbon,先向部分网络安全防御人员开放,延续了从安全人员到 Pro 用户约两周多的发布节奏。该模型一口气放出 17 项跑分,通用能力与价值观安全性拿下全球第一,编程、电脑使用、办公、多模态、长上下文、科研推理及网络安全多项登顶,其中网安三项全部第一,成为优先向防御方开放的理由。定价上输入每百万 Token 2 美元、输出 10 美元、缓存输入 0.1 美元,输出与缓存价格低于 Kimi K3.1 Pro,明显瞄准性价比竞争。不过跑分未纳入 K3.1 Pro 直接对比,国产模型的对抗声量仍待观察。
谷歌在旗舰模型发布仅一个月后,又抛出了新模型 Gemini 4 Carbon。这次并非全面公测,而是先向部分网络安全防御人员开放,但参考过往节奏,从安全人员到 Pro 用户大概间隔两周多。频繁迭代的节奏,似乎有意摆脱此前 Flash 系列“又快又不够强”的魔咒,也让人联想到近期 Kimi 等国产模型的刺激——昔日的“御三家”是否要重新回归,成为这轮发布最耐人寻味的悬念。
跑分全面开花:通用、编程、多模态领跑
谷歌这次一口气放出了 17 项跑分,与 Kimi 的 16 项形成隔空对垒。从结果看,通用能力(AA 评估基础能力与智能水平)和价值观安全性评估(VI)均拿下全球第一,直接压过 Anthropic 的旗舰模型。编程维度上,SWE 代码修复能力全球第一,SWE2 软件工程能力仅次于 OpenAI 和 Anthropic 两家旗舰,TB 终端运维能力则是全球第一。
电脑使用方面,ALE 复杂 agent 能力全球第一,OSWORD 操作系统能力仅次于 OpenAI 的某款 5.5 模型。办公场景里,AB 自动化操作和 VB2 金融能力双双登顶——金融场景再次成为模型能力比拼的富矿。多模态方面,图表分析(BB 图纸理解)全球第一,对建筑图纸、工程蓝图等视觉信息的理解成为亮点。
长上下文与科研推理:剑指千禧难题
超长上下文能力 GEW 拿下全球第一,这在长文档处理、代码库级理解等场景中颇具分量。更说个细节科研能力:RB 高速推理测试集中包含与黎曼猜想相关的高阶数学推理,Gemini 4 Carbon 的表现超过了 OpenAI 和 Anthropic 两家旗舰,位列全球第一。虽然距离真正解决千禧难题还很遥远,但至少在相关推理基准上,谷歌展示了冲击基础科学问题的野心。科学计算 TBS 同样全球第一。
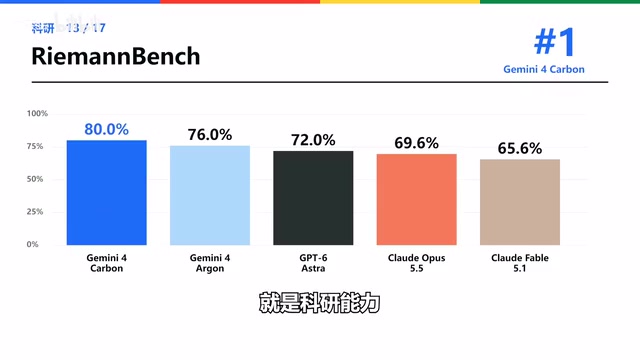
黎曼猜想是克雷数学研究所悬赏百万美元的七个千禧年大奖难题之一,核心是断言黎曼ζ函数的非平凡零点都位于复平面上实部为 1/2 的临界线上。它与素数分布规律密切相关,一旦被证明或推翻,将深刻影响数论乃至密码学。攻克它需要全新的数学思想,而非单纯的计算能力;但高阶数学推理基准能反映模型在长链条推导、符号运算和策略搜索上的水平。因此 Gemini 4 Carbon 在该测试集上的领先,只说明其在受控推理任务中表现更好,与真正解决千禧难题之间仍有本质距离。
网络安全:用最锋利的矛打最坚硬的盾
网络安全能力是这次开放策略的核心。CWE 漏洞挖掘能力全球第一,EG 黑客能力(使用和生成漏洞并利用代码)全球第一,SEC 安全防御同样全球第一。三项网安跑分全部登顶,解释了为何优先向安全防御人员开放——谷歌在用自己的矛测试自己的盾。这种“自相矛盾”的开放方式,既是对模型攻防能力的自信,也暗含对滥用风险的谨慎。
CWE(Common Weakness Enumeration,通用弱点枚举)是由 MITRE 维护的软件缺陷分类体系,涵盖缓冲区溢出、注入、越界读写等常见漏洞类型,常被用作漏洞挖掘评测的标注依据。以 CWE 为框架的基准通常要求模型在给定代码中定位弱点并给出修复建议。让模型同时具备漏洞生成与防御能力,意味着它既可能被用于自动化攻击,也可用于代码审计和安全加固。谷歌选择先向防御方开放,正是希望通过受控分发观察滥用边界,这也延续了近年来前沿模型厂商对高风险能力采取分级发布的一贯做法。
定价精准狙击:输入略贵,输出更便宜
价格是另一枚重磅。Gemini 4 Carbon 输入每百万 Token 2 美元(约 13 块多人民币),输出每百万 Token 10 美元(约 66 块多人民币),缓存输入每百万 Token 0.1 美元(约 6 毛多人民币)。对比 Kimi K3.1 Pro,除输入贵约三毛人民币外,输出和缓存价格均更低。这一定价明显瞄准了 Kimi 的性价比优势,试图在开发者群体中扳回一城。
不过跑分榜单并未纳入 K3.1 Pro 的直接对比,国产模型在这轮较量中的声量仍显不足,后续千问和 JLM 的发力值得期待。如果跑分属实,谷歌这次确实在能力与价格上同时给出了诚意,接下来就看正式开放后的真实表现了。
大模型 API 定价通常按每百万 Token 分别计费,输入、输出与缓存输入三档价格差异显著。输出 Token 需要模型逐字生成,计算成本最高,故单价常为输入的数倍;缓存输入则是对重复上下文做复用,价格最低。对开发者而言,长文档问答、代码库分析等场景以输入为主,缓存命中率直接决定成本;而 Agent、代码生成等场景输出占比高,输出价格更具决定性。Gemini 4 Carbon 压低输出与缓存价格,实质是在高频交互和长上下文复用两类负载上争夺开发者,而非单纯比拼输入报价。
背景补充
文中反复出现的 AA、SWE、ALE、TB、GEW、CWE 等缩写,分别指向不同的评测体系。AA 通常指 Artificial Analysis 系列综合评估,衡量模型的基础能力与智能水平;SWE 系列(含 SWE、SWE2)以软件工程任务为场景,考察模型阅读代码库并提交补丁修复缺陷的能力,是当前编程能力最受认可的基准之一;ALE 侧重复杂 Agent 任务中的规划与工具调用;TB 指终端运维类任务;GEW 用于评测超长上下文下的检索与理解;CWE 则基于通用弱点枚举体系,考察模型发现真实漏洞的能力。这些基准多为公开或半公开,但各家在提示词、采样次数等细节上的差异会影响可比性,因此跑分领先应结合具体评测设置来解读。
相关推荐
核战真能终结文明吗?科学解析常见误区
核战争会终结文明吗?本文基于核武器物理机制,解析爆炸、辐射尘与城市火灾的真实影响,区分空爆与地爆、剂量与污染,说明为何核战是巨大灾难却非文明终结,并探讨打击后社会重建的关键因素。

泰坦尼克号沉没真相:国家地理纪录片中的关键决策与通讯失灵
国家地理纪录片《The Unsinkable Ship》通过幸存者口述还原泰坦尼克号沉没前的关键决策:从MSG电报前缀缺失、锅炉房与舰桥通讯断裂,到“永不沉没”认知偏差如何延误损管与疏散。

74M参数开源模型在测试中部分超越Jev AI
Fastino AI 的 Glider 2.5 系列模型仅 7400 万到 3 亿参数,据 YouTube 实测在部分防护栏基准测试中超越 Jev AI,且可在消费级硬件运行,甚至用于玩《Doom》。本文分析小模型在特定任务上的竞争力与部署价值。