谷歌Gemini 4 Hydrogen发布:速度与成本双杀,日常AI任务新王者

谷歌发布轻量模型Gemini 4 Hydrogen,以三分之一成本挑战中档主力模型。
谷歌推出新一代轻量模型 Gemini 4 Hydrogen,定位速度与价格优先,对标 Anthropic Sonic 5.5 和 OpenAI GPT 6.1 Tera 等中档日常主力模型。多项基准显示其在代码、智能体与视觉文档任务上领先,Artificial Analysis 默认档得分 51、X-High 档 54,接近 Sonic 最高档的 55。成本是核心卖点:最高档每任务约 3.16 美元,仅为 Sonic 10.2 美元的三分之一。演示中它能一句话生成可走动的 3D 岛屿游戏,3D 场景任务耗时与费用均约为旗舰 Carbon 的一半。谷歌还推出 Orchestrator,让 Carbon 规划、Hydrogen 执行,TerminalBench 4.1 中任务量接近 Carbon 单独运行,配额少用 24%、平均快 19%。
谷歌刚刚发布了新一代轻量级模型 Gemini 4 Hydrogen,瞄准的正是大多数人每天都会用到的编程和智能体任务。根据官方定位和第三方评测,它在多项实际工作任务中击败了 Anthropic 和 OpenAI 的日常主力模型,而每项任务的成本只有 Cloud Sonnet 的大约三分之一。
Hydrogen 目前已经通过 Gemini 应用、Google 搜索、AI Studio 和 Gemini API 上线,免费用户可以通过应用内的自动模型选择用上它。
定位:轻量但不轻量级
Google 这一代模型按元素周期表命名,旗舰是 Carbon(碳),Hydrogen(氢)则是最轻的元素,正好对应它为速度和价格而生的定位。Google 把它和 Anthropic 的 Sonic 5.5、OpenAI 的 GPT 6.1 Tera 放在一起比较——这两款是各自的中档模型,比顶级模型低一档,但承担了人们日常任务中很大一部分。
Hydrogen 的默认档是“高思考”,同时还提供低、中、高三档思考强度,并新增了一个 X-High 档,让开发者在质量、速度和成本之间做平滑取舍。
基准测试:中档模型中的领先者
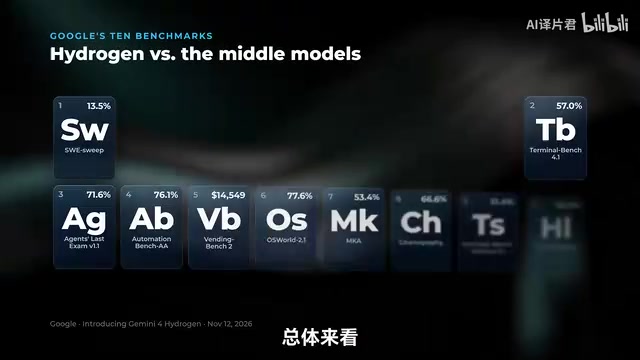
在多项基准测试中,Hydrogen 展现出对同档模型的明显优势:
- Suesway 代码测试:Hydrogen 得分 13.5,Tera 只有 8,Sonic 只有 3——是 Tera 的两倍多,Sonic 的四倍以上。
- Agent's Last Exam:Hydrogen 得分将近 72%,Tera 略低于 70%,Sonic 大约 60%。
- Automation Bench:Hydrogen 约 76%,Sonic 72%,Tera 60%。
- MKA 视觉文件测试:Hydrogen 约 53%,Sonic 52%,Tera 约 44%。
Google 表示它适合处理杂乱的办公工作,把 PDF、表格、图表、音频和视频都丢给它,它就能返回一份报告。不过 Google 自己的图表上也显示有几项落后:在 OS World 2.1 测试中,Hydrogen 略逊于 Sonic;在 Terminal Bench Science 的科学任务上,两项都落后。
第三方机构 Artificial Analysis 的独立评测提供了另一组视角。其 Intelligence Index 汇总分数显示,默认设置下 Hydrogen 得分 51,超过 Gemini 4.2 的 50 分;调到 X-High 档后达到 54 分,而 Sonic 5.5 在最高档下得分 55,Tera 在最高档得分 51。据中国科技媒体 AI Front 报道,它还在一个智能体排行榜上冲进了全球前五。
Artificial Analysis Intelligence Index 是由独立评测机构 Artificial Analysis 维护的模型能力综合评分,它把数十个常见基准(数学、代码、推理、指令遵循等)的得分归一化后加权汇总成一个单一数字,方便跨厂商横向比较。该指数通常会在模型的不同“思考强度”设置下分别测量,因此同一模型会出现多个分数(如默认档与最高档)。由于它不依赖厂商自报数据,常被媒体和开发者当作相对中立的参考,但也要注意汇总权重与所选题库会显著影响排名,单一总分不能完全代表某一具体任务上的表现。
成本与速度:真正的杀手锏
按 Artificial Analysis 的单任务成本计算,Tera 其实比 Hydrogen 更便宜,但它的最高分更低。Sonic 最高档每任务 10.2 美元,Hydrogen 最高档 3.16 美元——少拿一分,花费只要大约三分之一。
速度方面,在默认的高思考档下,Hydrogen 完成任务的速度比 Google 上一款快速模型 Gemini 3.8 Flash 快 2.5%;反复检查代码时这个差距会很明显。AI Front 的看法是,如果日常工作主要靠 Sonic 或 Tera,Hydrogen 已经能替代它们——质量接近顶尖,速度是它们的 2.5 倍,成本只有三分之一,这比在排行榜上当第一更划算。
单任务成本是 Artificial Analysis 提出的估算口径:完成其评测集中的一项任务平均需要消耗多少美元,计算时综合了输入/输出 Token 单价、模型实际生成的 Token 数量(含思考过程)以及重试等因素。它比单纯的“每百万 Token 价格”更贴近真实使用感受,因为推理型模型在高思考档下会产生大量不可见的思考 Token,导致账单远高于表面单价。不同任务的成本差异很大,因此这一指标适合在同一评测集内做相对比较,而非直接换算成生产环境的绝对开销。
一句话生成3D游戏:演示里的硬实力
Google 的演示主角是一个叫 Gemini Island 的 Minecraft 风格 3D 图形工具。你输入一句提示,Hydrogen 就能立刻把整个游戏用 3D 写出来——一座岛,有道路、建筑和大型动物,你可以第一人称到处走动。
开发者社区也贡献了亮眼的案例。一位叫 Kim Onesimus 的前用户用 3JS 做了个峡谷飞行游戏,地形由代码生成,水会流动,还有 25 个计分门要飞过去;另一个演示 Pure Physics 是实时 3D 场景,光穿过水和玻璃时弯曲、弹射、分成不同颜色再被吸收,整个过程都是实时的——这既需要图形代码,也得真正理解光的传播规律。
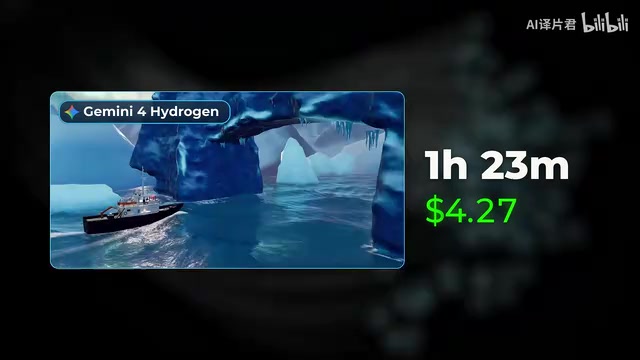
开发者 Tony 把同一个任务分别交给 Hydrogen 和 Carbon,做的是船只驶过冰川的 3D 场景:Hydrogen 用了 1 小时 23 分钟、花了 4.27 美元,Carbon 用了 2 小时 39 分钟、花了 8.83 美元。时间减半,费用也大约减半,而 Hydrogen 做出来的版本看上去仍和 Google 自家顶级模型非常接近。
还有一个经典的 AI 测试:让模型用 SVG 画一只骑自行车的鹈鹕。一位叫 Marcel 的用户加大了难度,让鹈鹕全程动起来骑车穿过 5 个变换的季节,再交给 Hydrogen 和 Fable 5.2 来做——Fable 花了大约 25 分钟,Hydrogen 用了 5 分钟,成品看起来相当扎实。
Orchestrator:让旗舰和轻量模型分工协作
Google 更大的计划是让 Hydrogen 和 Carbon 一起跑,靠的是 AI 编程应用 Anti-Gravity 里一个叫 Orchestrator 的新选项。
思路很清晰:Carbon 先以只读模式上场,只查看不改动,弄清代码之间怎么连接,写出一份具体计划并设定好重新评估的节点;接着由 Hydrogen 动手干活——写、修改、更新项目依赖并运行测试;如果 Hydrogen 卡住了,Carbon 就回来检查问题并修正计划。简单说,Carbon 是资深工程师,Hydrogen 是负责敲键盘的快速初级工程师。
在 TerminalBench 4.1 这项测试里,Orchestrator 完成的任务几乎和 Carbon 单独运行一样多,同时配额少用 24%,平均快 19%。Hydrogen 单独在这项测试中得分 57%,是 Gemini 3.8 Flash 18.2% 的三倍多。开发者也可以用 Anti-Gravity SDK 自己把两个模型接起来。
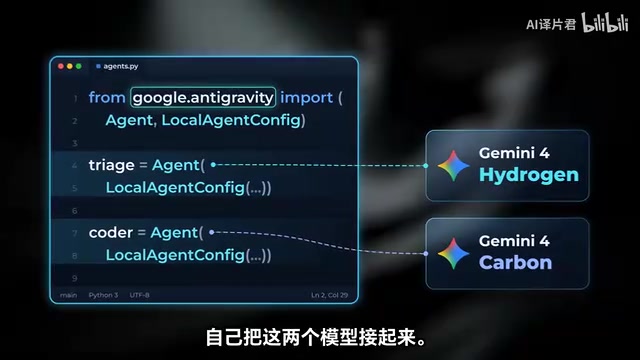
在 Google 的演示里,开源项目涌来大量报告时,Hydrogen 智能体跟得上,会搜索代码、提出澄清问题并根据评审意见快速调整设计,而 Carbon 智能体负责更大的重写和新功能。
Orchestrator 有 Carbon 版和 Argon 版,Ultra 订阅两个都有,Pro 只能用 Argon 版。企业则可以通过 Gemini for Business 获得 Hydrogen 和 Orchestrator。
TerminalBench 是一类面向命令行与真实开发环境的智能体基准,要求模型在终端中自主执行命令、读写文件、安装依赖并完成多步骤工程任务,最终以任务是否成功完成来计分。它比传统的代码补全或单元测试类基准更接近“智能体能否独立干活”,因此常被用来衡量模型在长链条工具调用中的稳定性与纠错能力。文中提到的 TerminalBench 4.1 是其较新版本,任务更长、环境更真实,得分高低往往取决于模型规划、试错和从报错中恢复的能力,而不仅是单次生成代码的质量。
同日动态:微软预告Ignite,ChatGPT接入钱包
Hydrogen 发布前后,AI 领域的其他动作也值得关注。
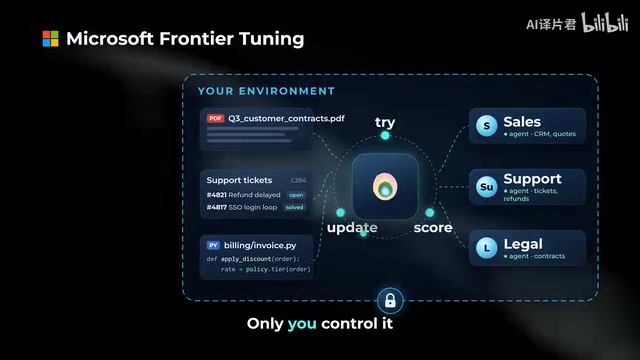
微软 AI 业务负责人 Mustafa Suleiman 转发了一则公告:Microsoft Ignite 大会将于 11 月 17 日到 20 日举行,微软模型团队 Maya 将带来“一些新东西”——新模型演示和开发者演讲。不过公告没有给出任何模型名称、演示标题或演讲者,基本上是在宣布“要宣布一些东西”。上一次公布真正的规格是在 6 月 2 日的 Microsoft Build 大会上,当时 Suleiman 发布了 7 个新的 Maya 模型,其中 Melee Thinking 1 是混合专家模型,每次回答只激活约 350 亿个参数,一次能装下 25.6 万个 Token。
OpenAI 则在 11 月 13 日推出 ChatGPT Wallet,让名为 Dots 的智能购物代理帮你挑选商品并结账。目前这项服务只面向少数美国 ChatGPT Pro 订阅用户,要求年满 18 岁并持有美国发行的 Visa、MasterCard 或 American Express 卡。绑定一次银行卡后,结账前你会看到商品总价和所用银行卡,再用 Face ID 或指纹确认;钱包会用支付令牌向卡扣款,真实卡号对 Dots 和商家都不可见。
AI 代理购物目前表现有好有坏:DoorDash 和 Uber 报告称由 AI 代理下单的数量很少,而 Meta 的 Muse 拥有超过 1000 万用户,AI 辅助购物已成为人们在那里最常做的事之一。OpenAI 想挤进来,但零售商态度不一,最大的障碍是亚马逊——它禁止这些代理,引导人们使用自家的 Alexa。
对日常开发者的意义
Hydrogen 的核心信号不是“又拿了一个榜单第一”,而是“够用的质量 + 更快的速度 + 三分之一的成本”。对于每天靠 Sonic 或 Tera 跑智能体任务、修 bug、做原型的开发者,这意味着同样的预算能跑更多轮次,或者把省下的配额留给真正需要旗舰模型的重活。
Orchestrator 的出现则指向一个更实际的趋势:让强模型做规划、快模型做执行,可能比全程用顶级模型更划算。Google 给出的数据是任务完成量几乎不变,同时配额少用 24%、平均快 19%。这条路能否在真实项目里站稳,还要看接下来几个月的开发者反馈。
相关推荐

手机本地运行无审查AI:LFM3模型实测与指南
介绍如何在iPhone和Android手机上本地运行Liquid AI的LFM3 1.7B无审查模型,无需GPU和网络,包含On Device LLM与Layla应用的操作步骤、实测速度与隐私优势分析。

Claude上线协作表格与白板,Anthropic硬刚微软谷歌
Anthropic向付费用户推送Claude Sheets和Claude Whiteboards测试版,支持一句话生成带公式的表格、将口头计划整理成带时间线的协作白板。文章分析其能力边界、编辑可见设计,以及与微软谷歌的正面竞争。

一句话生成表格?Claude Sheets深度体验与避坑指南
Claude Sheets 测试版上手解析:一句话生成带公式和下拉菜单的协作表格,但 100,000 单元格上限与套餐用量限制可能比你想的更早成为瓶颈。附三个业务场景、合规限制与五步避坑清单。