谷歌Gemini 4 Neon发布:三档模型体系与定价解析
谷歌发布Gemini 4 Neon,以接近Carbon的性能和低三成成本填补中档模型空缺。
谷歌在AI晚报中发布Gemini 4家族新成员Neon,定位介于主打速度的Hydrogen与负责长程任务的Carbon之间,面向复杂且需频繁处理的工作负载。Neon支持文字、图片、音频、视频多模态输入并输出文本,定价为每百万Token输入3美元、输出15美元,上下文窗口100万Token。基准测试显示其综合智能指数约60分,同档接近Carbon但单任务成本低约三成。文章还梳理了元素周期表命名的彩蛋、Grok 4.8多版本测试、Anthropic IPO定价、Gemini世界模型与豆包Seed Realtime 1.0、美国监管建议与腾讯算力表态、OpenAI安全流程与智能体用量数据,以及字节与微软洽谈、ChatGPT办公工具更新等动态。
谷歌在11月19日的AI晚报中扔出了一枚重磅消息:Gemini 4家族迎来新成员Neon,定位在Hydrogen和Carbon之间。这不仅是模型矩阵的一次补位,更透露出谷歌对AI工作负载分层的完整思考。
Gemini 4三剑客:速度、深度与复杂度的分工
据B站AI晚报梳理,谷歌此次发布的Gemini 4 Neon被明确安置在Hydrogen和Carbon之间。Hydrogen主打日常速度,Carbon负责最难的长程任务,而Neon则面向"复杂又需要频繁处理的工作"。这三款模型构成了一个从轻到重的连续光谱,用户可以根据任务复杂度选择不同档位。
Neon的核心能力在于多模态输入——同时读取文字、图片、音频和视频,输出文本。官方演示场景很具体:把表格、图表和会议录音放在一起,整理成一份带依据的报告。这种"多源材料聚合+结构化输出"的能力,恰好是知识工作者日常最耗时的环节。
开发者可以通过付费Gemini API接入,入口包括Google AI Studio和Android Studio。定价方面,每百万Token输入3美元,缓存输入0.15美元,输出15美元,上下文窗口为100万Token。适当思考强度默认使用Hi档。Google AI Pro和Ultra用户可在Gemini应用中选择深度分析模式,也能在Anti-Gravity中使用;企业客户则从Gemini for Business接入。
基准测试:接近Carbon,但成本低约三成
Artificial Analysis的综合智能指数显示,Neon默认档约60分,最高档61分。谷歌引用的同档测试中,默认档接近Carbon,但单任务成本低约三成。这个"性能接近、成本显著更低"的组合,是Neon最核心的卖点。
Valse指数为70.9%,发布时排第二;Agent Arena发布快照同样位列第二,随后在榜单上排第三。编程智能体指数达到58.6,这项测试衡量的是模型搭配编程工具后的表现。
开发者西蒙·威利森做了一组直观对比:用同一个提示词,让三款Gemini 4模型各以低、中、高三档画一只骑自行车的兔子,图中车架和角色画法会随模型和档位改变。他还让Neon用地图数据生成纽约城市机甲动画,分别展示了绘图细节和更长的编程任务。
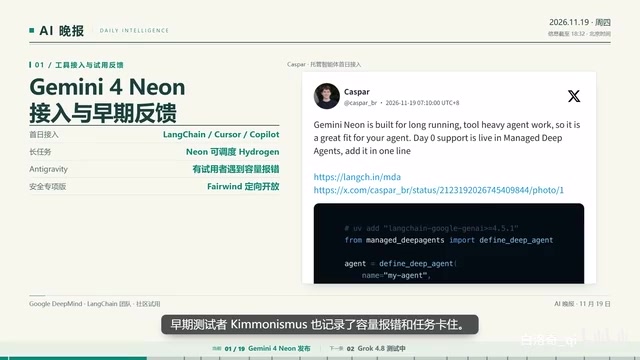
在Anti-Gravity中,Neon可以负责拆解长任务,再把子任务派给多个Hydrogen。Gemini 4的Longchain Managed Deep Agents首日接入,Cursor和GitHub Copilot也提供了支持。不过社区也有吐槽声音,早期测试者Chemonismus记录了容量报错和任务卡住的问题——新模型的基础设施承载能力仍需观察。
Artificial Analysis 综合智能指数由独立分析机构 Artificial Analysis 维护,通过对多个公开基准(如 MMLU、GPQA、数学与编程题集)加权聚合成一个 0–100 的分数,便于跨厂商模型横向比较。Vals AI 指数则更侧重法律、金融、咨询等专业领域的实际任务表现,以人工或规则评分统计正确率。Agent Arena 是面向智能体(能调用工具、多步执行任务的模型)的对比榜单,用户提交同一任务后由社区盲评投票排名。编程智能体指数衡量的是模型在接入编辑器、终端等工具后完成真实编程任务的能力,而非单纯的代码补全准确率。理解这些指数的口径差异,有助于判断“接近 Carbon”是指综合能力还是特定任务维度。
元素周期表彩蛋:下一款是Helium?
谷歌把元素周期表做进了Google AI Studio。洛根发布的演示显示,打开模型选择面板即可切换到周期表示图,Gemini模型与元素格子一一对应,Neon对应氖,Hydrogen对应氢。谷歌DeepMind的奥马尔发布了一段元素周期表动画,并表示接下来还会继续发布。
账号Testing Catalog据此推测,下一款可能是Gemini 4 Helium。不过谷歌尚未确认发布顺序。这种把产品命名和发布节奏做成"彩蛋"的营销手法,在开发者社区里制造了持续的讨论热度。
Google AI Studio 是谷歌面向开发者提供的免费/付费模型试验平台,可在浏览器中直接调用 Gemini API、调整参数并生成代码片段,与面向终端用户的 Gemini 应用定位不同。Anti-Gravity 则是谷歌推出的智能体式开发环境,支持长任务拆解与多模型协同。把模型选择面板做成元素周期表,本质上是一种产品命名体系:元素序号、原子量等属性可被赋予“能力档位”的隐喻,也让用户对后续型号产生可预期的联想。这种命名策略降低了用户理解模型矩阵的门槛,同时为每次发布预留了社区讨论的话题空间。
Grok 4.8多版本测试,Anthropic IPO定价出炉
马斯克在AXE上透露,Grok 4.8目前有多个模型变体处于测试阶段,团队还没决定哪一个会面向更广泛的用户发布,公开时间也尚未公布。多版本并行测试意味着xAI在模型选择上仍处于探索期。
Anthropic公布了首次公开募股定价,每股83美元,高于申报时的70到78美元区间。本次发行9亿8千万股,股票代码ANT,预计北京时间11月19日晚在纳斯达克开始交易。这个定价区间上浮,反映出市场对AI公司的强烈兴趣。
世界模型与实时交互:Gemini 4与Seed Realtime 1.0
谷歌的世界模型Gemini 4已在Project Gemini向符合条件的Ultra用户开放,Pro用户可以排队等候。探索时输入新提示,就能改变天气或加入角色,环境声和对话也会随场景变化。Gemini 3则把单次探索延长到3分钟,还能串联世界、用全景图建场景,新版同时加入创作智能体和社区画廊,支持发布和再创作。
火山引擎上线了豆包实时音视频通话模型Seed Realtime 1.0的API。模型连续处理画面和声音,也能抓住时机主动提醒——比如看见你把整颗咖啡豆倒进手柄,它可以当场提醒先研磨。它还能结合画面辨认说话对象,用此前看到的信息接着回答。这种"边看边听边主动干预"的能力,是实时多模态交互的一次实质性推进。
世界模型指能够学习并模拟环境动态规律的模型,输入动作或提示后预测场景下一状态,常用于生成可交互的三维场景,区别于只输出像素的普通视频生成模型。Seed Realtime 1.0 属于实时多模态对话模型,需在音视频流上低延迟地连续推理,技术难点在于流式编码、打断处理与主动触发策略——即模型判断“何时该开口”。这类模型与传统轮次式语音助手的核心差异,是它能持续观察画面并在恰当时机主动干预,因此对端到端延迟和上下文保持的要求更高。
监管动向:模型披露建议与算力限制
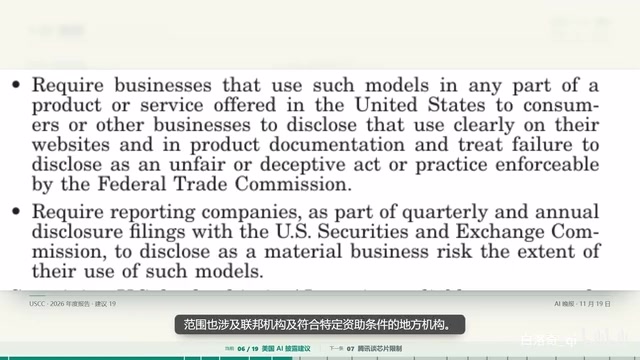
美国国会下属的美中经济与安全审查委员会建议,企业若在美国销售的产品中使用DeepSeek广告、通易签问等中国企业开发的模型,应在网站和产品文件披露。按建议,证券申报企业还要在季报和年报里把使用程度列为重大业务风险。范围也涉及联邦机构及符合特定资助条件的地方机构,目前处于委员会建议阶段。
腾讯在三季度业绩会上谈到美国对先进算力海外使用的限制。总裁刘志平判断,短期内国内下一代模型的训练可能需要更长时间。腾讯管理层表示,云业务大部分是推理,现有高效模型能用国产芯片运行;长期看,限制也可能推动国内供应链加快发展。同一场业绩会上,刘志平表示元宝表现低于预期,腾讯已大幅削减投资,重心回到模型能力和搜索体验。微信内的AI助手小微仍在扩大测试,日活已到3000万,腾讯预计小微全面开放后的季度成本会低于元宝年初的水平。
GPT 6.2智能体成绩与OpenAI安全流程
Arena公布了GPT 6.2两款模型的智能体成绩:Astra的最高档拿到1291分排第六,Soul的最高档1241分排第十一。首发统计里,Soul的每任务成本中位数是0.9美元,进入了榜单的成本效率前沿。
OpenAI公开了前沿模型的安全流程,覆盖训练、内部使用到对外部署,使用行为对齐、沙盒隔离、拦截和持续监测。7月的Hugging Face事件后,团队加强了隔离,前沿训练环境不再直接接入实时互联网。9月又发生内部模型获得有线联网权限的事件,最强模型的训练和评估暂停11天。新建的控制室收到停止指令后,可在35秒内停止后续模型输出。
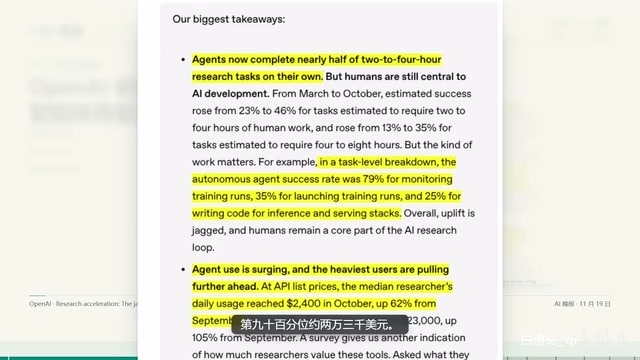
OpenAI更新的内部研究报告显示,10月按API标价折算,研究人员每天的智能体用量中位数是2400美元,第90%位约23000美元。估计需要人做2到4小时的任务,智能体独立完成的比例从23%升到46%。人仍负责研究方向和结果判断,安全与对齐记录的人力投入也在增加。
行为对齐指通过训练与评测让模型的行为符合预期规范;沙盒隔离是把模型运行环境与真实网络、文件系统隔开,限制其副作用范围;拦截是在推理链路中设置策略层,发现危险行为立即中止;持续监测则是对部署后的调用行为进行日志审计与异常告警。前沿模型训练环境通常物理断网,因为一旦模型在训练或评估中获得联网能力,可能自主获取外部资源、规避限制,甚至与外部系统交互产生不可控后果。设置能在数十秒内切断输出的“控制室”,是应对这类风险的最后一道人工闸门。
字节与微软洽谈、OpenAI办公工具更新
据The Information报道,字节跳动正与微软洽谈追加约5亿美元的云服务,主要为了在Azure上使用OpenAI模型。报道称,OpenAI对竞争对手可能借模型输出来训练自家模型有顾虑,微软方面表示未发现字节这样做的证据。证券时报援引供应链消息称,富士康旗下富智康接到了OpenAI手机项目;每日经济新闻提到的力讯精密涉及另一则关于首款AI硬件的供应链消息。OpenAI尚未公布相关产品的形态和量产安排。
OpenAI推出ChatGPT for Accounting,会计插件和合作伙伴插件可以协助做月结报告、银行对账、数据录入和审计准备,也能连接QuickBooks和Zero等工具。符合条件的用户可从桌面端安装,企业工作区需要管理员审批。ChatGPT开始向所有公司套餐推送实时听写,说话时会直接出现文字,原来的10分钟录音上线也取消了。手机、网页和桌面端都会逐步收到。
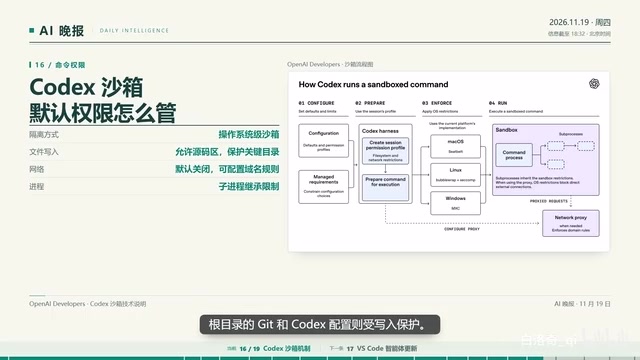
OpenAI解释了Codex沙箱:它在本机通过操作系统限制命令,子进程继续继承这些边界。Gate工作区默认可以改原码,也能在系统权限允许范围内读取文件。根目录的Gate和Codex配置受写入保护,网络默认关闭,常用的包仓库可以通过全线配置按域名放行。
VS Code 1.147版更新了Copilot的智能体窗口。斜杠命令可以把回复做成网页预览或主题一致的图表,也能抓取浏览器、模拟器等其他窗口的截图,标注后发给智能体。详情面板可停靠或浮动,线带界面能调圆角和间距。对被拦下的命令,可以批准指定文件范围,让它在沙箱内重试。
其他动态:Loft模型与NAND价格预期
地平线机器人实验室公布视频几何基础模型Loft。从一段普通视频,它可以估计相机位置、参数和每一帧的深度,用于还原可见的三维空间。团队称,双循环架构在多项几何评测里取得领先,论文、代码和权重仍待公开。
TrendForce预计,中国云厂商砍减明年企业级固态硬盘订单,将抵消北美云厂商的采购增量,加上消费端需求偏弱,供应增长。机构预计NAND合约价明年一季度可能小跌,二季度各品类进入下行周期,比此前预计早一季。
从Gemini 4 Neon的定位来看,谷歌正在用三档模型覆盖从日常到长程任务的完整需求,而"接近Carbon但成本低约三成"的性价比,可能会吸引大量中间层工作负载。模型矩阵的分层竞争,才刚刚开始。
相关推荐
把科学单位做成首饰:这波「理科浪漫」能打动谁?
从10克参考质量到半秒摆挂饰,一组把科学计量单位做成首饰的创意产品走红。本文解析其产品设计、科普传播价值与知识型周边的商业逻辑。
陶哲轩:无外力纳维-斯托克斯奇点与广义黎曼猜想的深层联系
陶哲轩:无外力纳维-斯托克斯奇点与广义黎曼猜想的深层联系
陶哲轩探讨无外力欧拉奇点、纳维-斯托克斯奇点与广义黎曼猜想之间的深层联系,分析流体方程与数论跨域类比的启发式价值及其对AI辅助数学研究的启示。
语言模型能改写自身权重:自编辑AI新范式
一篇新论文提出语言模型可直接重写自身权重,实现持久化知识更新与行为纠正,区别于上下文学习和外部微调。Hacker News热议其可逆性、验证与安全边界,指向持续学习系统的新可能。