语言模型能改写自身权重:自编辑AI新范式
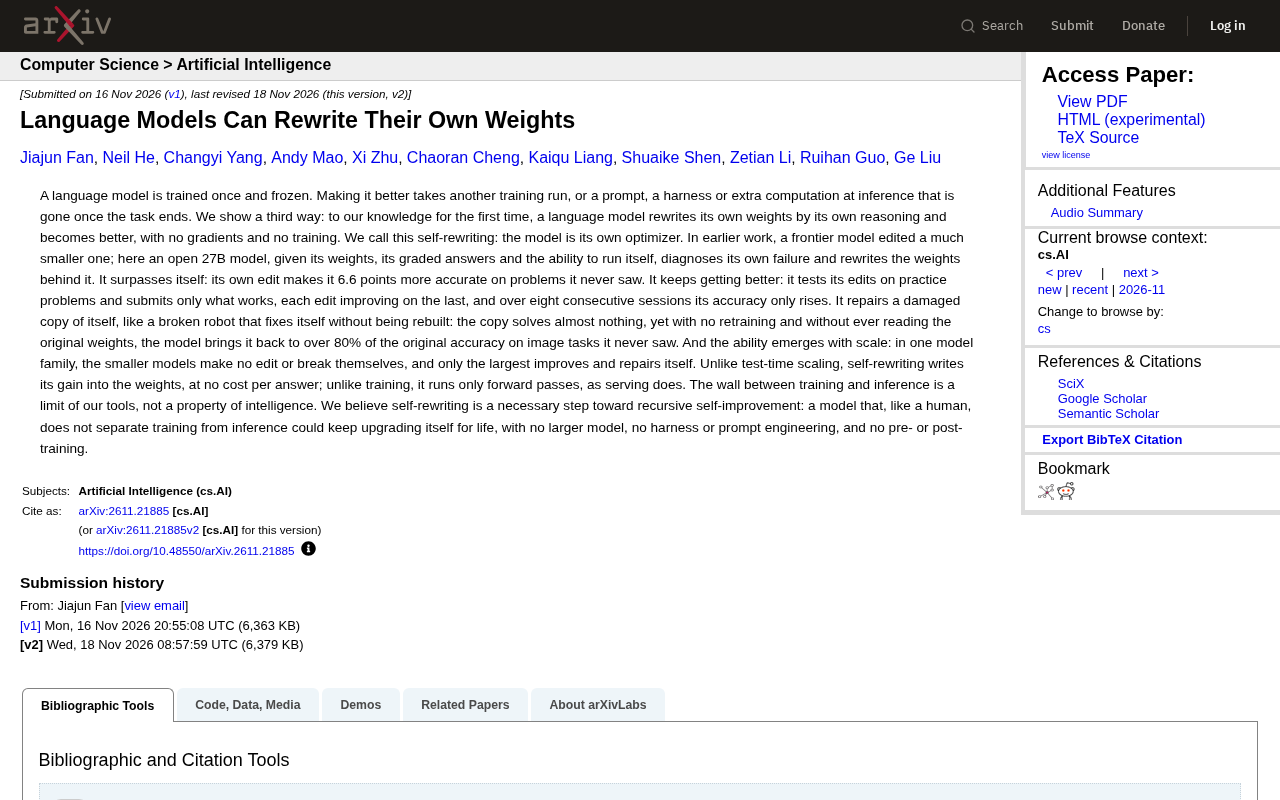
新论文让语言模型在推理时生成权重增量直接修改自身参数,实现持久化知识更新。
文章介绍了一项新研究:让语言模型在推理过程中生成对自身参数矩阵的修改,而非依赖外部微调或提示工程。技术路径分两步——模型接收自然语言指令,生成低秩或稀疏的权重增量,这依赖元学习框架将语义意图映射为参数变化。与上下文学习不同,权重重写是持久化的;与标准微调不同,执行者是模型自身。Hacker News社区关注可逆性、修改验证和安全边界三大问题。该方向可能模糊训练与推理的边界,打开持续学习新路径,但会降低可审计性。目前仍处受控实验阶段,距离安全自主自编辑尚有距离。
从「调参」到「自改」:模型获得编辑自身的能力
传统上,调整大语言模型的行为需要外部介入——微调、提示工程、或通过RLHF重新训练。但一篇新论文提出了一个更具野心的方向:让语言模型直接重写自己的权重。这不是比喻,而是指模型在推理过程中生成对自身参数矩阵的修改,从而完成知识更新或行为纠正。
该工作在Hacker News上获得了328个点数和106条评论,讨论热度说明社区对「模型自编辑」这一命题的高度关注。核心问题不再是「模型能否学习」,而是「模型能否有意识地修改自己」。
技术路径:权重生成与元学习
论文的核心思路可以拆解为两步。第一步,模型接收一个描述目标修改的自然语言指令,例如「学会这个新事实」或「修正这个错误倾向」。第二步,模型生成一组权重增量——不是文本输出,而是直接作用于自身参数的数值更新。这要求模型具备对自身参数空间的结构化理解,而不仅仅是前向推理能力。
实现上,这依赖于元学习框架:模型在训练阶段见过大量「指令→权重修改」的配对样本,从而学会将语义意图映射为参数变化。关键挑战在于,权重是百万到十亿量级的参数向量,模型必须生成低秩或稀疏的修改,才能让计算可行。论文采用的方法正是将权重增量约束在低维子空间中。
低秩与稀疏修改:权重矩阵的参数量通常在百万到十亿级别,若模型直接输出全量权重增量,计算和存储成本都不可行。低秩分解(如LoRA)将增量表示为两个小矩阵的乘积,把可训练参数压缩到原矩阵的极小比例;稀疏修改则只更新少量非零元素。两者都能让模型在生成修改时保持计算可行,同时限制每次编辑的影响范围,降低灾难性遗忘的风险。论文将权重增量约束在低维子空间,正是这类思路的体现。
元学习框架:元学习(Meta-Learning)的核心是“学会学习”,即模型在大量任务上训练后,获得快速适应新任务的能力。在本工作中,训练阶段提供大量“自然语言指令→权重修改”的配对样本,模型从中学习将语义意图映射为参数变化。这种“指令到权重”的映射能力本身是元学习的产物,使模型在推理时能针对新指令生成合理的权重增量,而非仅完成前向推理。
与现有方案的本质差异
这与上下文学习有根本区别。上下文学习把新信息放在提示里,模型权重不变,推理时临时「参考」这些信息。而权重重写是持久化的——修改一旦写入,后续所有推理都会携带它,不需要重复提供指令。
与标准微调的区别则在于执行者:微调由外部训练流程驱动,模型是被动对象;权重重写由模型自身发起,模型既是执行者也是受益者。这种「自指」特性带来了新的安全考量,也打开了持续学习的新可能。
上下文学习:上下文学习指模型在不更新权重的情况下,仅通过提示中提供的示例或信息完成新任务。新信息存在于推理时的上下文中,一旦上下文清空,信息即丢失。权重重写则将修改持久化到参数中,后续推理无需重复提供指令,这是两者在信息持久性上的根本区别。
RLHF:基于人类反馈的强化学习(RLHF)通过外部奖励信号微调模型行为,训练流程由外部驱动,模型是被动调整对象。权重重写则由模型自身生成参数修改,模型既是执行者也是受益者。这种自指特性带来了可逆性、验证和安全边界等新问题,也区别于传统微调的被动模式。
社区关注与潜在影响
Hacker News的106条评论反映出几个集中关切。一是可逆性:如果模型能改写自己,能否同样干净地回滚一次错误修改?二是验证问题:如何确认权重修改确实达到了预期语义效果,而非引入隐蔽偏差?三是安全边界:一个能自编辑的模型,是否可能绕过外部约束进行未授权修改?
从积极面看,这条路指向一种真正持续学习的系统——模型在部署后遇到新知识时,可以自我更新而非等待下一轮训练。但代价是,模型行为的可审计性会显著下降。
仍处早期,但方向值得跟踪
论文目前展示的是受控条件下的权重编辑能力,距离开放环境中自主安全地修改自身还有相当距离。不过,它提出了一个值得认真对待的问题:当模型能够修改自己的参数,「训练」和「推理」的边界就不再清晰。对AI研究者而言,这可能是一条通往自适应系统的关键路径;对安全研究者而言,这是一个需要提前建立护栏的新攻击面。
相关推荐
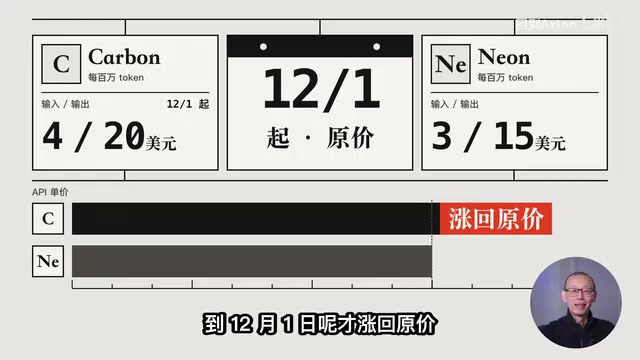
深度实测:Gemini 4 全系模型能力揭秘,默认档为何垫底?
基于B站UP主十小时双盲实测,彻底搞清Gemini 4四款模型Argon、Carbon、Hydrogen、Neon的真实能力:默认Neon High为何垫底,打开X High如何反超Carbon,多模型编排Orchestrator怎样3比0完胜默认档,附成本账单与四条选型建议。
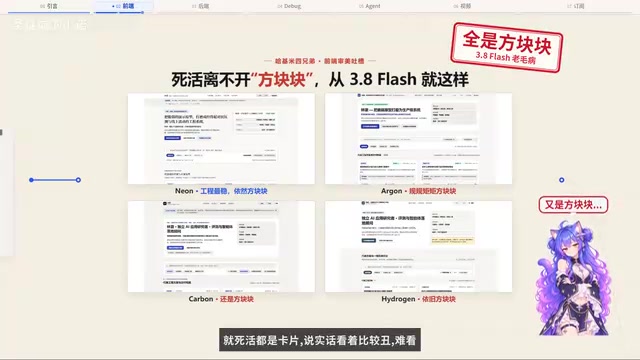
Gemini 4 家族实测一周:四个模型私榜各拿一冠,Carbon快慢两极分化
B站UP主重度实测Gemini 4家族一周:Neo、Argon、Carbon、Hydrogen在私榜各拿一冠,前端审美偏弱但后端和Agent能力突出,Carbon长程任务断层第一却慢到崩溃,视频生成Neo可对标顶级模型。

Gemini 4 Neon真的强过GPT-6.2 Sol?实测数据拆解
谷歌Gemini 4 Neon在官方19项测试中拿下16个第一,但独立评测与实战账单揭示:工具差异、思考成本与响应速度让GPT-6.2 Sol性价比反超。本文拆解Mervin Prezen实测数据,给出按API付费与订阅用户的选择建议。