谷歌Gemini Omni 1.2 Flash视频模型发布,李飞飞空间智能上掌机
谷歌发布可批量化的视频模型,World Labs与Muse推动空间交互落地。
文章汇总了当日三条 AI 动态。谷歌发布 Gemini Omni 1.2 Flash 视频模型,成本较前代降低 30%,仅凭一张风格参考图即可生成科普视频,支持多角色自然对话、参考音色配音与跨物种动作迁移;编辑上可更换背景、主体与灯光,支持 15 秒视频编辑,并可结合 Flow 工具延长时长与选择画质。李飞飞创立的 World Labs 推出掌机形态的 Frame Boy,搭载优化后的 Atlas 世界模型,基于云端 GPU,用户上传一张图片即可每秒 15 帧地探索 AI 生成的三维世界。AI 助手 Muse 上线实时语音与虚拟形象,支持通话式对话并同步表情动作。作者认为今日呈现视频工具化与空间交互硬件化两条主线。
谷歌推出Gemini Omni 1.2 Flash:视频生成进入"批量化"时代
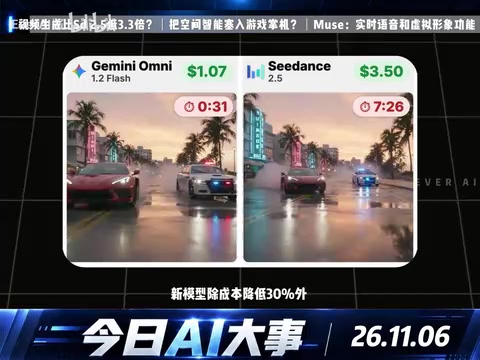
谷歌今日发布新一代视频模型Gemini Omni 1.2 Flash,官方将其定位为"具有Gemini大脑"的视频工具。据B站UP主"白虎"的解读,该模型在成本上较前代降低30%,但更值得关注的是它开始像一个"批视频工具"——这意味着视频生成正在从单条实验性输出转向可批量处理的生产力工具。
Gemini Omni 1.2 Flash的核心能力包括:仅凭一张风格参考图即可生成科普类视频,并能创建流畅的多角色对话场景。在演示中,模型生成了蜜蜂科普视频,角色对话自然,且能遵循参考音色进行拟人化配音。跨物种动作迁移是另一亮点——人体角色可以像章鱼一样舞蹈,动作衔接看上去相当自然。
Gemini Omni 系列与 Flash 后缀的含义
Gemini 是谷歌自 2023 年底发布的多模态大模型家族,按能力与成本分为 Ultra、Pro、Flash、Nano 等层级,其中 Flash 定位为面向大规模调用的轻量高速版本。"Omni"通常指模型原生支持多种输入输出模态(文本、图像、音频、视频),而非由多个专用模型拼接而成。将 Omni 与 Flash 结合用于视频生成,意味着谷歌试图在保持多模态理解能力的同时压低推理成本。所谓"具有 Gemini 大脑",即视频生成过程由大模型负责理解提示与参考素材、规划镜头与台词,再交由生成模块渲染,这也是其能处理多角色对话和科普讲解这类需要语义规划任务的原因。
多角色对话与编辑能力:从生成到后期的一体化
新模型在多角色对话场景中表现出色。演示片段里,两个角色围绕"兰花模仿配色"展开幽默对话:"Excuse me, that orchid is copying my color palette. I demand royalties." 另一个角色回应:"I think it just wants to match your tail, Cosmo." 这种带有个性化台词的互动,说明模型在角色一致性和语境理解上有所提升。
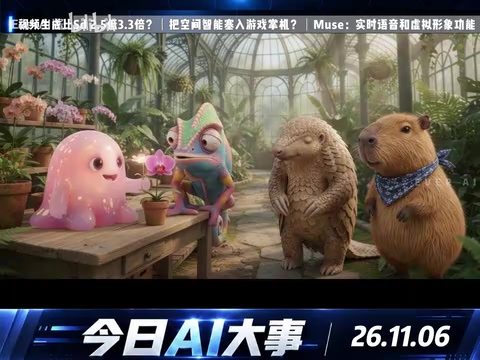
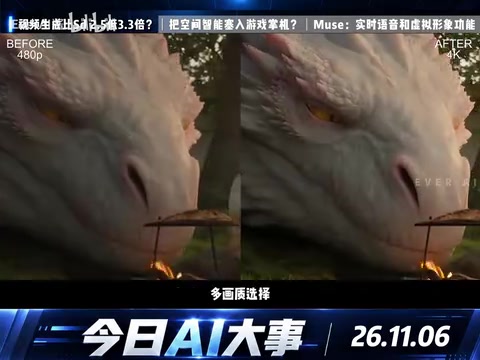
编辑功能方面,Gemini Omni 1.2 Flash支持更换背景、替换主体或调整灯光,目前可编辑长达15秒的视频。结合谷歌的Flow工具,用户还能自然地延长视频时长,并选择多种画质输出。这套组合拳让视频创作从"生成一段"走向"编辑一整条",对内容创作者来说实用性明显增强。
角色一致性与动作迁移的技术背景
视频生成中的"角色一致性"指同一人物在多镜头、多轮对话中保持面部、服装与体型稳定,是长期困扰扩散视频模型的难点,常见做法是引入参考图作为身份锚点并在时间轴上约束特征。跨物种动作迁移则通常依赖人体姿态估计提取骨骼关键点序列,再映射到目标形体的运动结构上,因此"人像章鱼般舞蹈"这类效果实质是骨架重定向而非逐帧模仿。此外,文中提到的 Flow 是谷歌面向 AI 影视创作的工作流工具,用于组织镜头、延展时长与统一输出规格;"可编辑 15 秒"则反映当前模型在时间维度上的上下文窗口限制,超出后需借助外推或分段拼接。
李飞飞把空间智能塞进游戏掌机:World Labs推出Frame Boy
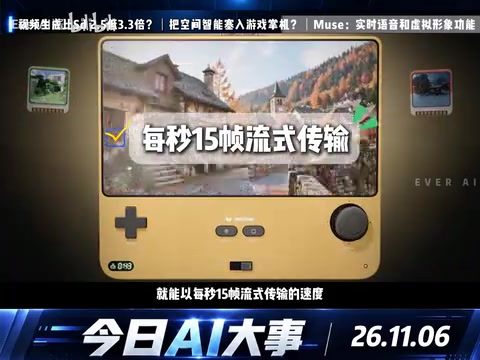
另一条值得关注的动态来自李飞飞创立的World Labs。该公司推出了一款名为Frame Boy的设备,形态上是一台游戏掌机,但内核是优化后的Atlas世界模型。据UP主介绍,Frame Boy基于云端GPU运行,用户只需上传一张图片,就能以"每秒15帧"的速度探索AI生成的三维世界。
这里的"每秒15帧流逝传输"描述了一种流式传输体验——画面随用户操作实时生成,而非预先渲染。将空间智能装进掌机形态,意味着世界模型正在从云端演示走向可交互的消费级硬件。虽然目前细节有限,但方向很明确:让普通人通过一张图就能"走进去"。
空间智能与世界模型
空间智能由李飞飞近年反复倡导,指智能体理解三维空间结构、物体位置关系与物理常识的能力,被视为超越语言智能的下一阶段目标。世界模型则是能够根据当前观测预测场景下一步状态(包括视角变化与物体运动)的生成式模型,World Labs 的 Atlas 即属于此类:从单张图片推断出可漫游的三维场景。与此前需要预先重建三维资产的做法不同,流式生成让画面随用户操作实时计算,代价是分辨率与帧率受限,这也是"每秒 15 帧"成为关键指标的原因——它决定了交互是否足够跟手。
AI助手Muse上线实时语音与虚拟形象
同日,AI助手Muse的实时语音和虚拟形象功能上线。用户可以随时给AI助手"打电话",在对话过程中看到虚拟角色同步做出表情和动作。这打破了纯文本或纯语音交互的边界,把语音对话与视觉反馈结合起来,让AI助手更像一个"在场"的对话对象。
小结:视频工具化与空间交互两条线并行
从Gemini Omni 1.2 Flash的批量化视频能力,到Frame Boy把世界模型塞进掌机,再到Muse的实时虚拟形象,今日AI动态呈现出两条清晰的主线:一是视频生成正在工具化、流程化,成本下降与编辑能力提升让其实用性增强;二是空间智能与实时交互正在寻找更轻量的硬件载体。对于内容创作者和AI应用开发者来说,这两条线都值得持续跟进。
相关推荐
 科技前沿
Textly:Mac上任意位置抓取文字和表格的效率神器
Textly是一款Mac菜单栏效率工具,支持从截图、PDF、视频和应用中框选捕获文字与表格,保持行列完整并导出CSV、Markdown、TSV,还内置即时翻译和剪贴板历史。
 科技前沿
Frameboy:World Labs Atlas 世界模型浏览器实时体验
World Labs 在 Product Hunt 发布 Frameboy,基于 Atlas 世界模型的浏览器实时演示,移动相机即可在云端 GPU 生成新视角,最高 15 fps 串流,探索 AI 生成的可漫游世界。
 科技前沿
Keypause:一键锁定Mac键盘,清洁时不再误触
Keypause是一款Mac菜单栏应用,一键锁定键盘所有按键,方便清洁时避免误触。本文介绍其功能、使用体验、潜在风险及适用场景,帮你判断是否值得尝试。