谷歌评论揭示食物获取障碍:地理邻近之外的隐形壁垒
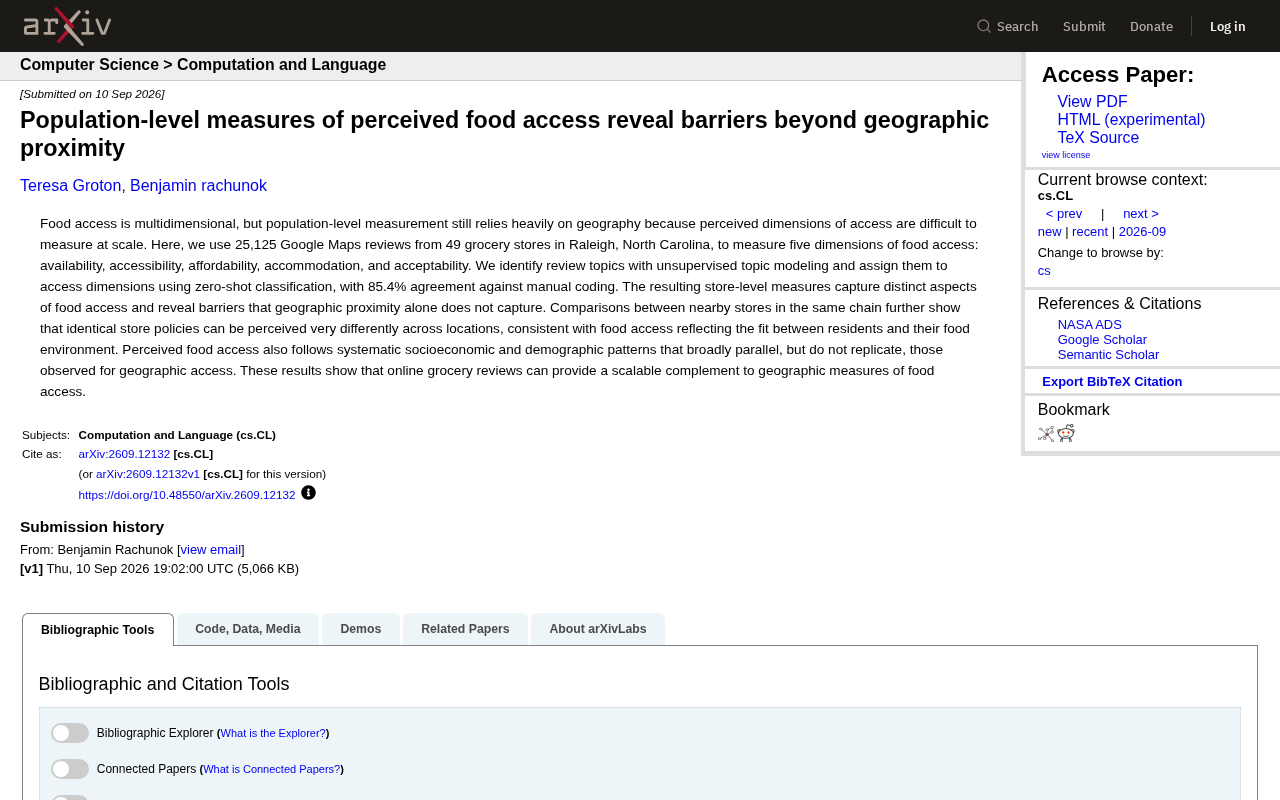
用2.5万条Google评论测量食物获取的五个维度,揭示地理距离之外的隐性障碍
这项发表于arXiv的研究以北卡罗来纳州罗利市49家杂货店的25,125条Google Maps评论为数据源,结合无监督主题建模与零样本分类,系统测量了食物获取的五个维度:可获得性、可达性、可负担性、便利性与可接受性。研究发现,即便是同一连锁品牌的不同门店,居民的感知体验也可能截然不同,说明食物获取本质上是人与环境之间的关系性契合,而非门店的绝对属性。感知获取所呈现的社会经济模式与传统地理测量「平行但不复制」,提供了增量信息。研究证明在线评论可作为地理测量的可扩展补充,为公共卫生干预提供更细粒度的依据,尽管样本代表性偏差和地域推广性仍是有待解决的局限。
食物获取远不止「离得近」这么简单
长期以来,衡量一个社区的「食物获取能力」几乎完全依赖地理指标——最近的超市有多远、步行能否到达。这种做法之所以盛行,并非因为它足够准确,而是因为其他维度太难在大规模人群层面测量。一篇发表于 arXiv(编号 2609.12132)的研究提出了一个新思路:用海量在线评论来捕捉那些地理数据看不见的障碍。
研究团队收集了美国北卡罗来纳州罗利市(Raleigh)49 家杂货店的 25,125 条 Google Maps 评论,试图从中提取食物获取的五个维度:可获得性(availability)、可达性(accessibility)、可负担性(affordability)、便利性(accommodation)和可接受性(acceptability)。这五个维度共同构成了「食物获取」的完整图景,而传统方法往往只覆盖了其中最表层的一两个。
方法论:无监督主题建模 + 零样本分类
这项研究的技术路径值得关注。研究者首先用无监督主题建模(unsupervised topic modeling)从评论文本中自动识别出讨论主题,再借助零样本分类(zero-shot classification)将这些主题归入五个食物获取维度。
零样本分类的价值在于:无需为每个维度预先标注大量训练样本,模型即可根据语义直接判断某条评论属于哪个维度。为验证可靠性,团队将机器分类结果与人工编码进行对照,达到了 85.4% 的一致率。这个数字说明,自动化流程在保持规模优势的同时,仍能维持接近人工的判断质量。
这套组合拳的意义在于可扩展性。人工阅读并编码两万多条评论成本高昂,而基于大语言模型能力的零样本方法让「人群层面」的感知测量第一次变得现实可行。
无监督主题建模通常指LDA(Latent Dirichlet Allocation,潜在狄利克雷分配)或其变体BERTopic等算法。这类方法不需要人工预先定义类别,而是让算法自动从大量文本中发现反复出现的词语共现模式,从而归纳出若干「主题」。例如,经常同时出现「价格」「贵」「折扣」的评论会被聚合为一个主题,算法再由人或模型赋予该主题语义标签。其核心优势是能从无结构文本中以低成本发现隐藏的讨论模式,尤其适合像评论这样规模大、话题分散的语料库。
零样本分类(Zero-shot Classification)则依托预训练大语言模型(如BART、RoBERTa的NLI变体)的语义理解能力。「零样本」意味着研究者只需提供目标类别的文字描述(如「这条评论涉及食物价格与经济负担」),无需针对该任务收集任何标注训练数据,模型便能判断某段文本与该描述的匹配程度。这与传统监督分类形成鲜明对比——后者往往需要数百至数千条人工标注样本才能训练一个可用的分类器。
关键发现:同一连锁品牌,体验天差地别
研究得出的最有启发性的结论之一,是关于连锁店之间的差异。当研究者比较同一连锁品牌在不同地段的门店时,发现即便执行完全相同的门店政策,居民的感知也可能截然不同。
这一现象直指食物获取的本质——它反映的是「居民与其食物环境之间的契合度」,而非门店的绝对属性。同样的商品陈列、同样的价格策略,在一个社区被视为便利,在另一个社区却可能被感知为障碍。地理指标或标准化的门店评级完全无法捕捉这种落差。
换句话说,食物获取是一个关系性概念:它取决于人与环境的匹配,而不仅仅是物理距离或门店本身的硬件条件。
感知获取与社会经济因素的系统性关联
研究还发现,居民感知到的食物获取水平呈现出系统性的社会经济与人口结构模式。这些模式在大方向上与地理获取所观察到的规律相似,但并不完全重合。
这一点尤为重要。如果感知获取只是地理获取的简单翻版,那么这套方法就没有额外价值。但研究显示两者「平行但不复制」(parallel, but do not replicate),意味着感知维度提供了地理数据之外的增量信息。一些社区可能在地理上「获取良好」,但居民的实际体验却充满摩擦;反之亦然。
对政策制定者而言,这意味着仅凭「食物荒漠」(food desert)的地理定义来分配资源,可能会遗漏真正需要干预的社区。
「食物荒漠」(Food Desert)是美国农业部(USDA)提出的政策概念,通常定义为:低收入社区中,居民距离最近的大型超市或杂货店超过一定距离(城市区域为1英里,农村为10英里)。这一概念推动了大量基础设施投资,但也受到越来越多的批评——仅靠物理距离无法解释为何部分社区即便有超市进驻,居民的饮食质量和健康指标仍未改善。后续研究提出了「食物沼泽」(Food Swamp)概念,强调快餐和便利店的密度对饮食选择的影响,与「食物荒漠」共同构成更立体的食物环境分析框架。本研究的感知维度测量,可视为对这一系列概念的进一步完善——将居民的主观体验纳入评估体系,而不再只关注客观的基础设施分布。
在线评论作为公共卫生测量工具的潜力
这项研究的核心贡献,是证明了在线杂货店评论可以成为地理测量的可扩展补充。它不是要取代传统的地理分析,而是填补其盲区。
- 规模优势:无需实地调查即可覆盖大量门店和人群
- 多维度:一次性捕捉可获得性、可负担性、便利性等多个难以量化的维度
- 感知视角:反映居民真实体验,而非纸面上的门店属性
当然,这一方法也存在局限。Google Maps 评论的作者未必能代表整个社区的人口构成,撰写评论的人群可能存在系统性偏差;单一城市(罗利市)的结果能否推广到其他地区,也有待更多验证。研究本身也承认,感知获取模式「与地理模式平行但不复制」,说明两套方法各有侧重,谁也无法完全替代谁。
尽管如此,这项工作展示了一条清晰的路径:借助文本挖掘与语言模型,公共卫生和城市规划领域可以用更低的成本、更细的粒度,去理解那些过去只能靠昂贵调查才能触及的社会问题。
相关推荐
MIT衍生公司将塑料废料变身高韧性建筑材料
MIT衍生初创公司Atlas Building Composites将塑料废料转化为高韧性建筑与基础设施部件,探索塑料回收的高价值产业化出路。本文解析其技术路径与产业意义。
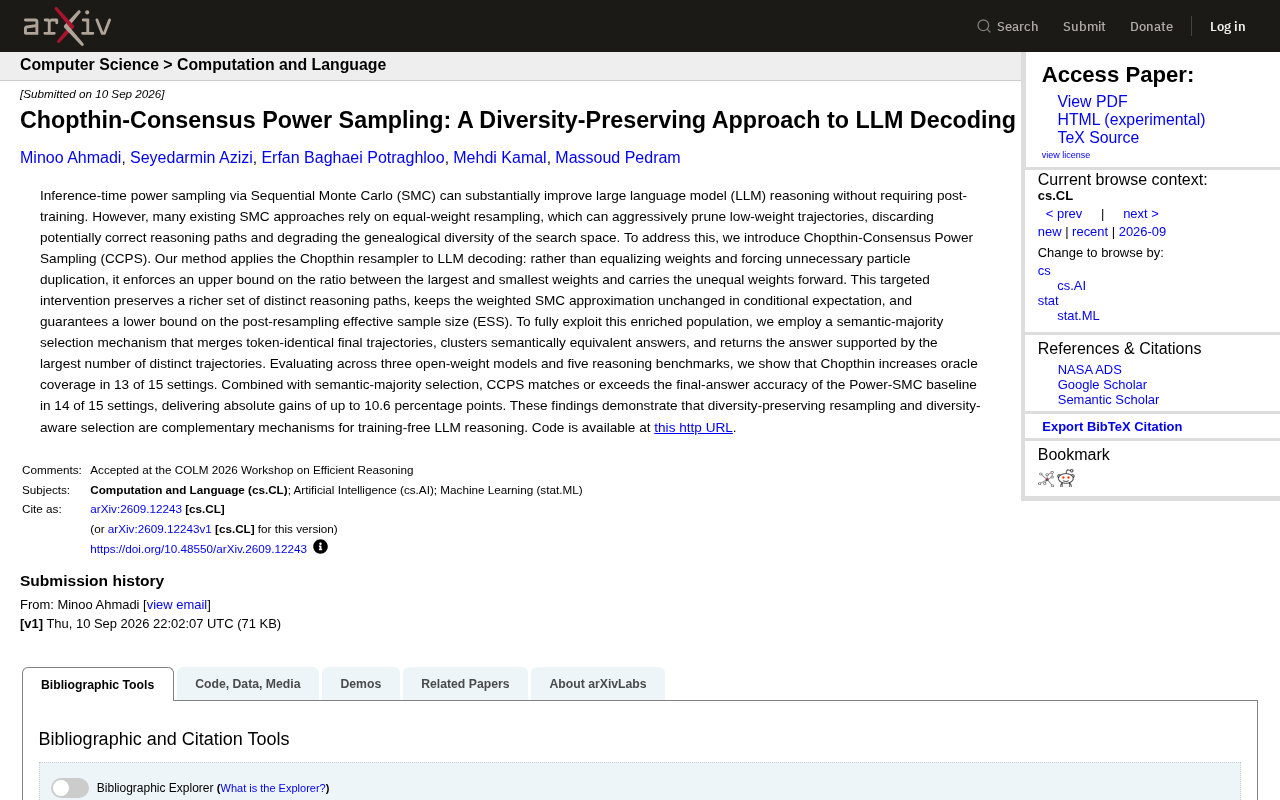
CCPS采样法:保留推理多样性,无需微调提升LLM表现
arXiv新论文提出Chopthin-Consensus Power Sampling(CCPS),通过保留推理多样性的重采样与语义多数选择机制,在不进行任何训练的情况下提升大语言模型推理准确率,最高绝对增益达10.6个百分点。
HardFlow算法:让生成式AI满足安全关键场景的硬约束
HardFlow是一种新算法,旨在让生成式AI在安全关键场景中严格遵守硬约束条件,同时保持高质量输出。本文解析其核心思路、技术难点与在机器人、工程设计等领域的应用前景。