过拟合推理引擎崛起:专用化如何重塑AI本地部署
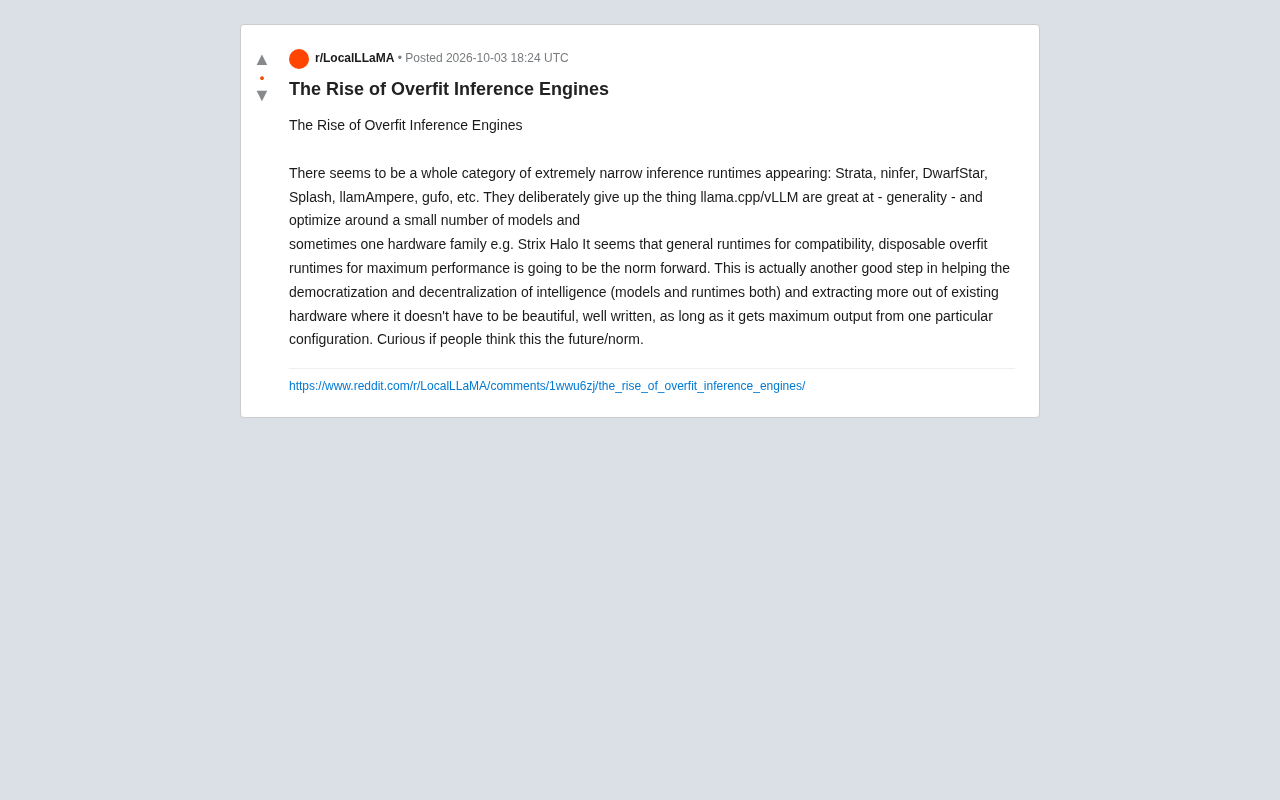
专用"过拟合推理引擎"正以放弃通用性换取极致性能,推动本地推理生态走向分层共存。
以Strata、ninfer、DwarfStar为代表的新一批推理运行时,刻意放弃对多种模型和硬件的兼容性,转而深度绑定少数特定平台,以榨取最大性能。与llama.cpp、vLLM等通用运行时不同,这类"过拟合推理引擎"奉行"够用即弃"的工程哲学,不求优雅和长期维护,只求在特定配置下的极致吞吐。这一趋势被视为AI民主化的新维度——让"不够主流"的消费级硬件也能找到专属优化方案。文章判断,未来更可能是通用与专用运行时分层共存,而非相互取代,但碎片化、可持续性和生态锁定是不可忽视的隐忧。
一类全新的推理运行时正在涌现
当多数人还在讨论 llama.cpp 和 vLLM 谁更强时,一批名字陌生的推理运行时正悄然登场:Strata、ninfer、DwarfStar、Splash、llamAmpere、gufo……这些项目有一个共同特征——它们并不追求通用性,而是刻意放弃兼容性,把全部精力押注在少数几个模型、甚至单一硬件家族上。
一位 Reddit 用户将这类项目称为"过拟合推理引擎"(Overfit Inference Engines),这个借用自机器学习术语的比喻相当传神:它们像是被"过度训练"去适配某一特定场景,牺牲泛化能力,换取在特定配置下的极致性能。例如 Strata 就围绕 AMD 的 Strix Halo 平台做深度优化。
通用 vs 专用:推理运行时的路线分化
过去几年,本地推理的叙事几乎被 llama.cpp 和 vLLM 主导。它们的核心优势在于通用性——支持广泛的模型架构、覆盖多种硬件后端、拥有活跃的社区生态。这种通用性让它们成为事实上的标准,但通用也意味着妥协:为了兼容各种情况,运行时往往无法针对某一具体硬件榨干全部算力。
过拟合推理引擎走的是相反路线。它们的逻辑非常直接:如果你只跑一两个模型、只用一种硬件,那么为什么要为你永远用不到的兼容性付出性能代价?
"一次性"运行时的价值主张
原帖作者提出了一个颇具启发性的判断——未来可能是"通用运行时负责兼容,一次性过拟合运行时负责极致性能"的双轨格局。这里的"一次性"(disposable)是关键词:这类运行时不必写得优雅、不必架构完美、不必长期维护,只要能从某个特定配置中压榨出最大吞吐量,它就完成了使命。
这种"够用即弃"的工程哲学,在传统软件工程里往往被视为反模式,但在追求硬件利用率最大化的推理场景中,反而可能是理性选择。当硬件成本高企、算力宝贵时,哪怕是难看、难维护的代码,只要能多榨出 20% 的性能,也具备现实意义。
理解这一分化,需要先明确推理运行时(Inference Runtime)的角色。它是介于模型权重文件与最终输出之间的执行层,负责将模型计算图高效映射到实际硬件上——包括内存分配策略、算子融合、量化计算、批处理调度等。llama.cpp 的核心竞争力在于跨平台的 CPU/GPU 混合推理,能在从树莓派到服务器的几乎任何设备上运行;vLLM 则以 PagedAttention 机制著称,专为高并发服务场景下的 GPU 吞吐量优化设计。两者的通用性建立在大量抽象层之上,而这些抽象层本身就是性能开销的来源之一。
从工程实践角度看,"过拟合"优化的手段通常包括:针对特定硬件的 ISA 指令集手写内核(如 AMD 的 RDNA/CDNA 架构专用 ROCm 内核)、跳过动态形状推断直接硬编码常见序列长度、针对单一模型架构的注意力计算做层融合、以及根据具体 SRAM/HBM 带宽比例定制的 KV Cache 布局。这些优化在通用框架中因需兼顾其他场景而无法激进应用,但在专用运行时中可以不加保留地全部打开。AMD Strix Halo 之所以成为 Strata 的目标平台,部分原因在于其独特的统一内存架构(高达 96GB LPDDR5X 共享内存)与主流 CUDA 生态存在明显差异,通用运行时对其支持相对薄弱,恰好为专用优化留出了空间。
为什么这是智能democratization的又一步
原帖作者将这一趋势视为智能去中心化与民主化的推进。这个观点值得展开。
模型层面的民主化我们已经看到了——开源权重模型让个人和小团队得以绕开闭源 API。而运行时层面的多样化,则是另一个维度的开放:当越来越多针对消费级或特定硬件优化的运行时出现,意味着普通用户手上那块"不够主流"的硬件,也可能找到专门为它调优的推理方案。
换句话说,过拟合运行时降低了"把现有硬件用到极致"的门槛。你不需要顶级数据中心 GPU,一块特定型号的 APU 或消费级显卡,配上一个为它量身定制的运行时,就能获得接近硬件极限的表现。这对于算力资源有限的开发者和爱好者社区而言,是实实在在的赋能。
这会成为常态吗?
原帖最后抛出的问题是开放式的:这究竟是未来趋势,还是昙花一现?
从技术演进的逻辑看,专用化与通用化的并存在计算史上并不罕见——我们既有通用 CPU,也有针对特定任务的 ASIC;既有通用数据库,也有专用的时序、图数据库。推理运行时出现类似分化,符合这一规律。
不过也要看到潜在的隐忧:
- 碎片化风险。过多的小众运行时可能分散社区精力,用户面临选择困惑,项目也容易因缺乏维护而迅速过时。
- 可持续性存疑。"一次性"听起来洒脱,但模型和硬件迭代很快,针对某一代配置的极致优化可能在新硬件面前迅速失去意义。
- 生态锁定。深度绑定单一硬件家族,也意味着使用者被某种程度地锁定。
结构性判断
更可能的终局或许不是"谁取代谁",而是分层共存:通用运行时作为基础设施提供稳定、广泛的支持,承担大多数日常场景;而过拟合运行时作为性能尖兵,在特定硬件与模型组合上提供额外的性能红利。对普通用户,通用方案依然是默认选择;对追求极致的高级用户和特定硬件玩家,专用运行时提供了新的可能性。
无论这类项目最终能走多远,它们的出现本身就反映了一个健康的信号:本地推理生态正在从"少数巨头主导"走向"百花齐放",而这正是技术民主化最生动的注脚。
计算机体系结构史上,专用与通用的张力贯穿始终。1980年代的 RISC vs CISC 之争、2000年代 GPU 从图形专用芯片演变为通用计算平台(GPGPU)、近年来 TPU、NPU 等 AI 专用芯片的兴起,都呈现出类似的模式:当某一计算范式足够重要且需求足够明确,专用方案就会涌现并在特定指标上碾压通用方案,而通用方案则凭借生态与灵活性守住广大腹地。推理运行时的分化遵循同一逻辑,其特殊之处在于"硬件-模型"组合的爆炸式增长——消费级 GPU 型号、移动端 NPU、各类 APU 与模型架构的排列组合,使得通用运行时的覆盖成本越来越高,也使得专用优化的价值越来越容易被量化和证明。
相关推荐
一套完整的Proxmox家庭实验室架构拆解:50+自托管服务实战
深度拆解一套基于Proxmox的完整家庭实验室架构,涵盖50+自托管服务的分层管理、GitOps部署链路、AI工具、安全监控与IaC灾备实践,为self-hosting玩家提供实战参考。
Anthropic游说梵蒂冈:AI会是有意识的存在吗?
Anthropic游说梵蒂冈:AI会是有意识的存在吗?
AI公司Anthropic曾尝试向教皇传达AI可能具有意识的观点,引发关于机器意识、AI伦理与宗教权威交集的讨论。本文分析这一事件背后的动机与争议。
如何用好 Claude 与 Claude Code 中的 Opus 5.5
围绕 Hacker News 分享的《Getting the most out of Opus 5.5 in Claude and Claude Code》主题,解读如何在 Claude 对话与 Claude Code 编程场景中发挥 Opus 5.5 模型能力的通用思路。