GVD框架:文档库版本治理与去重的本地化新解法
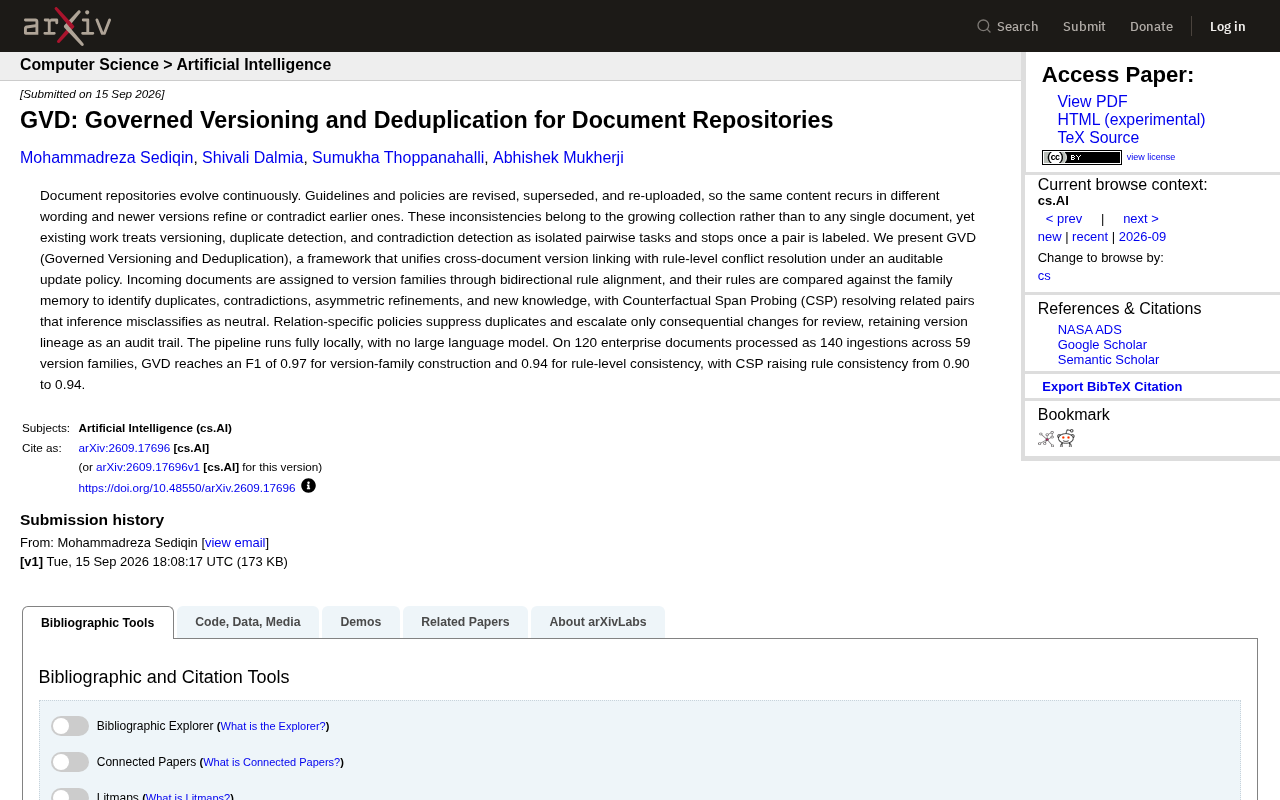
GVD将文档版本管理、去重与冲突检测统一为可审计的规则级治理框架,完全本地运行无需大模型。
企业文档库在持续演进中会累积版本混乱、内容重复和规则冲突等结构性问题,现有工具往往孤立处理这些成对判断任务。GVD(Governed Versioning and Deduplication)提出了一套统一框架:通过双向规则对齐将文档归入版本家族,并在规则粒度上识别重复、矛盾、非对称细化和全新知识四类关系。其核心技术亮点"反事实跨度探测(CSP)"专门修正被误判为中性的规则对,将规则一致性F1从0.90提升至0.94。系统采用关系特定的治理策略,只将实质性改动升级人工审查,并完整保留版本谱系用于合规审计。整条流水线完全本地运行,不依赖任何大语言模型,适合对数据隐私有严格要求的企业合规场景。在120份企业文档、59个版本家族的评估中,版本家族构建F1达0.97,展示了该框架在文档集合治理任务上的实用价值。
文档库演进中的老难题
企业文档库从来不是静态的。指南、政策、规章不断被修订、废止、重新上传,同一份内容会以不同措辞反复出现,新版本可能细化或直接推翻旧版本的规则。这些不一致并不属于某一份单独的文档,而是整个文档集合在持续演进中累积出来的结构性问题。
现有研究往往把版本管理、重复检测和冲突检测当作三个孤立的成对任务来处理——判断两份文档是否重复、是否矛盾,一旦给某一对贴上标签就算完成。这种做法忽略了文档集合层面的整体治理需求:谁是谁的新版本?哪些改动只是措辞变化,哪些是实质性冲突需要人工介入?这些问题无法靠孤立的成对比较回答。
arXiv上一篇题为《GVD: Governed Versioning and Deduplication for Document Repositories》的新论文,提出了一个统一处理这些问题的框架,思路值得关注。
GVD 做了什么
GVD(Governed Versioning and Deduplication,受治理的版本管理与去重)的核心目标,是把跨文档的版本关联与规则级别的冲突消解,统一到一套可审计的更新策略之下。
它的处理流程大致如此:新进入的文档通过**双向规则对齐(bidirectional rule alignment)**被分配到相应的"版本家族"(version family)中,然后将文档内的规则与该家族的"记忆"进行比对,识别出四类关系——重复、矛盾、非对称细化(asymmetric refinements,即一方对另一方的补充或精化)以及全新知识。
这里的关键设计在于"规则级别"的粒度。GVD 不满足于判断整份文档的关系,而是深入到文档内部的具体条款,判断每一条规则相对于历史版本处于什么状态。这种细粒度让系统能够区分"仅仅是换了说法的重复"和"真正改变了约束的实质冲突"。
反事实跨度探测(CSP)
论文提出的一个技术亮点是 Counterfactual Span Probing(CSP,反事实跨度探测)。在自然语言推理中,很多本应判定为"重复"或"矛盾"的规则对,会被模型错误地归类为"中性"(neutral),从而漏掉真正需要关注的关系。CSP 专门用来处理这些被误判为中性的相关对,重新识别它们之间的真实关系。
从数据上看,CSP 的贡献是明确的:它把规则一致性判定的 F1 分数从 0.90 提升到了 0.94。
反事实跨度探测的设计灵感来自自然语言推理(NLI)领域对模型"捷径学习"问题的研究。NLI模型在判断两段文本关系时,往往依赖表面词汇重叠或句式相似度,而非真正理解语义。当两条规则措辞相近但含义相悖,或措辞不同但实质等价时,模型容易将其归入最保守的"中性"类别——即"我看不出明确的蕴含或矛盾关系"。
反事实跨度探测的做法是:对被判为中性的规则对,系统性地对关键跨度(span,即文本片段)做最小化修改——例如把数值、条件词、否定词替换为反义表达——然后观察模型输出是否发生显著变化。如果微小的语义扰动让模型从"中性"跳变到"矛盾"或"蕴含",就说明原始规则对之间确实存在被模型忽略的实质关系。这种"如果改成相反的说法,结论会变吗"的反事实检验,正是该方法名称的由来。
可审计的治理策略
GVD 与传统去重工具最大的区别,在于它把"治理"放进了框架名字里。
系统采用关系特定的策略(relation-specific policies):识别为重复的内容被自动抑制,只有那些具有实质影响的改动才会被"升级"(escalate)提交人工审查。这意味着运维人员不会被海量的重复告警淹没,注意力可以集中在真正需要判断的冲突和细化上。
更重要的是,整个版本谱系(version lineage)被完整保留,作为审计追踪(audit trail)。对于受合规约束的企业环境,这种"谁在什么时候修改了哪条规则、为什么"的可追溯性,往往比检测准确率本身更有价值。
**版本谱系(version lineage)与审计追踪(audit trail)**的概念在合规驱动的行业中有明确的法规依据。例如ISO 9001质量管理体系、SOX(萨班斯-奥克斯利法案)以及各类金融监管框架,均要求组织能够证明"在某一时间点,适用的政策版本是什么,由谁授权修改"。传统文档管理系统(DMS)虽然记录文件的上传时间和操作人,但并不理解文档内容层面的变化——一个条款被悄悄删改,系统只会记录"文件已更新",而无法标注"第3.2条的数值上限从100万元改为80万元"。GVD在规则级别保留变更记录,使得内容级别的合规举证成为可能,这正是它对受监管行业最直接的价值。
完全本地运行,不依赖大模型
在大模型几乎成为默认选项的当下,GVD 的一个反直觉设计是:整条流水线完全本地运行,不使用任何大语言模型。
这一取舍对企业文档场景相当务实。政策文档、合规规章往往涉及敏感信息,不便上传到外部 LLM 服务;本地化运行既规避了数据外泄风险,也避免了 API 调用成本和延迟。在这个前提下还能达到较高的准确率,说明针对特定任务的专用方法在这类结构化程度较高的场景中,依然有不依赖大模型的空间。
在不使用大语言模型的前提下实现高精度的语义理解,GVD依赖的很可能是较小规模的专用自然语言推理模型(如基于BERT系列的NLI分类器)与规则化流水线的组合。这类模型参数量通常在1亿量级,可完全部署在本地CPU或单张GPU上,推理延迟和硬件成本均大幅低于调用GPT-4等大模型API。
这一取舍也有其局限性:专用NLI模型的泛化能力依赖训练数据的覆盖范围,对高度专业化的领域术语(如医疗法规、金融合约的特定措辞)可能表现不稳定,而大模型在这类场景下通常有更强的零样本理解能力。因此,GVD的本地化方案更适合文档结构相对规范、规则表达较为标准化的企业政策场景,而非跨领域的通用知识库治理。
实验结果
论文在一组企业文档上做了评估:120 份企业文档,作为 140 次摄入(ingestions)处理,分布在 59 个版本家族中。
结果如下:
- 版本家族构建的 F1 分数达到 0.97
- 规则级别一致性的 F1 达到 0.94
- CSP 将规则一致性从 0.90 提升至 0.94
这些数字表明,在企业级文档治理这一具体任务上,GVD 的版本关联和冲突识别能力都达到了相当高的水平。需要说明的是,59 个版本家族、140 次摄入的评估规模属于中等量级,其在更大规模、更异构文档库上的表现仍有待进一步验证。
为什么值得关注
GVD 的意义不只在于几个漂亮的 F1 分数,而在于它重新定义了问题。
它把版本、重复、矛盾这三件事从"孤立的成对判断"提升为"集合层面的持续治理",并配上了可审计的策略机制。对于任何维护着大量政策文档、技术规范或知识库的组织来说,这套思路——细粒度规则比对、只升级有意义的改动、保留完整审计链、本地化不依赖大模型——都提供了一个可操作的参考范式。
随着企业知识库规模不断膨胀,"文档治理"正从一个后台运维问题,逐渐变成影响合规与决策质量的核心议题。GVD 这类框架的出现,正是对这一趋势的回应。
相关推荐
冰岛Treble获1800万美元融资,押注语音仿真平台
冰岛语音仿真公司Treble完成1800万美元融资,其平台服务于语音AI模型开发者、AI可穿戴设备及机器人公司。本文解析语音仿真技术价值与融资背后的行业信号。
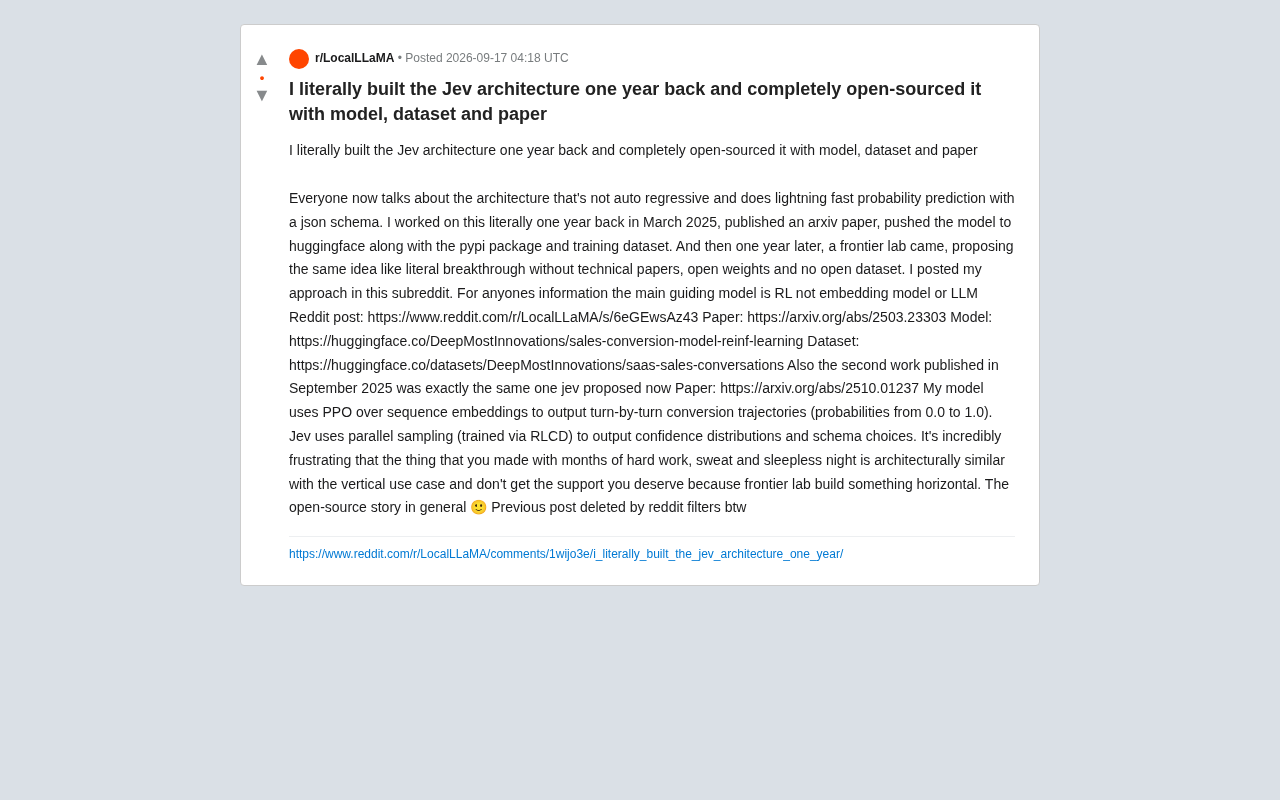
开源之痛:非自回归架构的先行者,为何被前沿实验室抢了风头
一位独立开发者在 Reddit 发帖称,其一年前开源的非自回归 RL 架构,被前沿实验室重新包装为突破。本文拆解 PPO 序列嵌入与 RLCD 并行采样两种路线的异同,并探讨开源生态的溯源与署名困境。
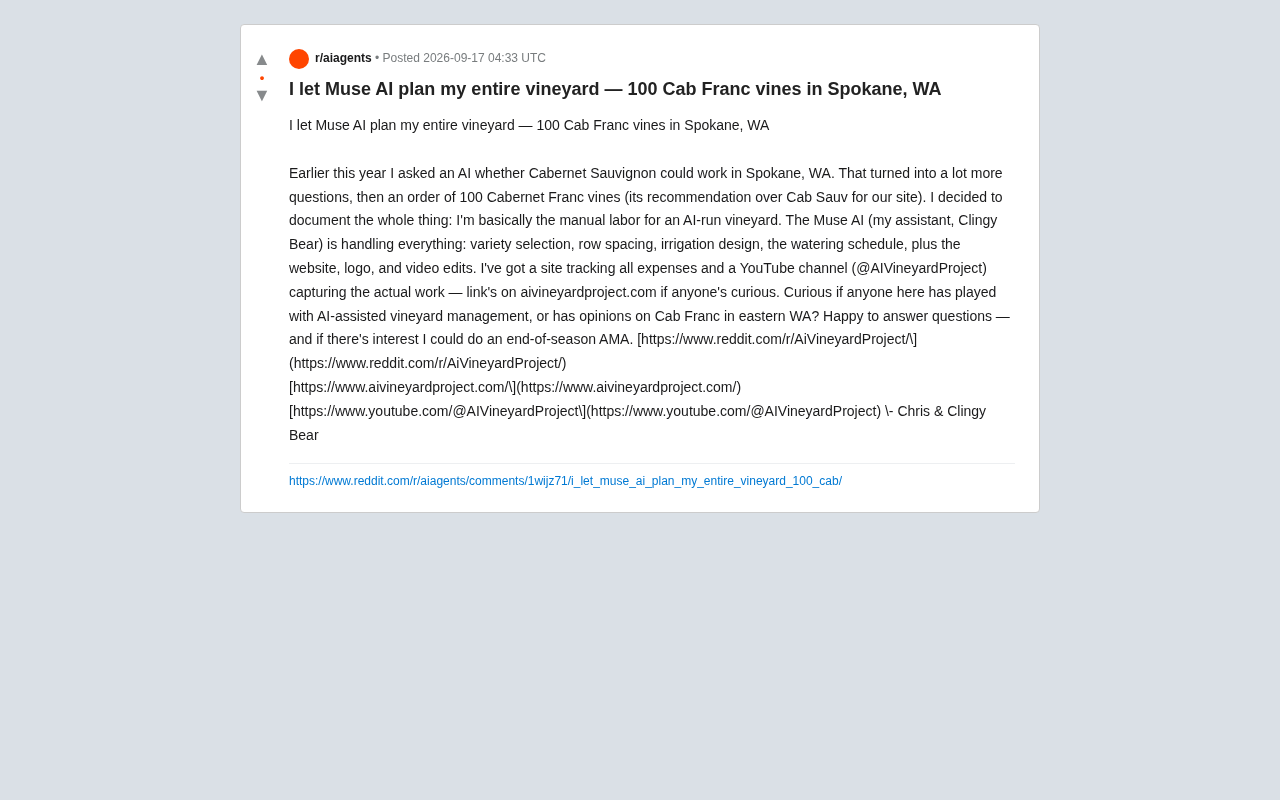
AI全程规划葡萄园:一场100株葡萄藤的真实实验
华盛顿州斯波坎一位爱好者让Muse AI全程规划葡萄园,从品种选择、行距到灌溉全部交给AI,最终种下100株品丽珠。这场AI主导、人类执行的公开实验,揭示了AI辅助农业的机会与边界。