哈佛研究:AI Coding Agents让代码量增30%,但交付量没变

AI编码工具让代码产出增30%,但交付几乎不变,瓶颈转移到代码审查环节。
哈佛两位经济学家基于Jellyfish平台追踪718家企业、70多万名工程师,发现AI编码工具(Claude Code、Cursor、Devin)让人均代码量增长约30%、commit和PR分别增长20%和23%,但真正完成的软件交付几乎没有变化。原因是瓶颈转移到了下游:review时间增加49%,需返工的PR比例几乎翻倍,审查评论和参与人数都在上升。研究利用各公司错峰采用AI的设计分离出工具本身的真实影响。论文结论是生产力增益未传导到软件产出或就业。作者提醒这是未经同行评审的工作论文,数据存在平台选择偏差,且属于短期效应,但"编码加速不等于交付加速"这一核心发现仍值得所有引入AI编码工具的团队重视。
哈佛两位经济学家Fiona Chen和James Stratton最近发布了一份工作论文,用Jellyfish平台的数据追踪了718家企业、超过70万名工程师的工作模式。结论相当反直觉:AI编码工具让工程师写的代码多了30%,但真正完成的工作量几乎没有变化。
研究是怎么做的
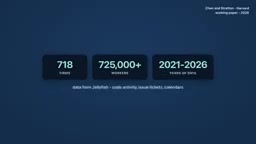
这项研究的数据来源是Jellyfish——一家专门追踪工程活动的商业分析公司。数据集覆盖718家企业、超过70万名工作者,时间跨度从2021年到2026年。追踪的内容不只是代码提交,还包括issue工单、日历安排等工程管理维度。
涉及的AI编码工具包括Claude Code、Cursor和Devin。这些工具在企业中的渗透速度非常快:2024年底几乎为零,到2026年初已经超过95%的受调研企业采用。
研究设计上有个巧妙之处——由于各公司采用AI工具的时间不同,研究者可以将"已经切换"的团队与"尚未切换"的团队进行对比,从而分离出AI工具本身的影响,而不是把行业整体趋势误归因于AI。
工作论文(working paper) 是经济学界常见的一种成果发布形式:作者在正式投稿期刊、接受同行评审之前,先把研究草稿公开,以便快速传播、收集反馈并抢占首发权。它通常发布在NBER(美国国家经济研究局)、SSRN等平台上,未经期刊编辑和匿名审稿人把关,因此结论的稳健性、数据的可复现性都尚未经过独立验证。读者在引用工作论文的结论时应保持谨慎——尤其是当它涉及快速变化的领域(如AI工具)时,样本窗口、变量定义和识别策略都可能在后续版本中调整,甚至出现与初版相反的结论。这也是本文作者主动强调"尚未经过同行评审"的原因。
双重差分(difference-in-differences) 是本文识别策略的核心。它的基本思路是:把"已经采用AI工具"的团队作为处理组,把"尚未采用"的团队作为对照组,比较两组在采用前后的变化差异。这样做的关键优势在于,它可以剔除掉那些同时影响两组的共同趋势(例如整个行业因为经济周期、技术栈升级而导致的生产率波动),从而把"采用AI"这一事件本身的影响分离出来。本文利用各公司采用时间不同(错峰采用)构造了天然的准实验条件,这正是该方法的典型应用场景。
写代码快了,但瓶颈转移了
产出端的数据确实亮眼。人均代码量增长约30%,commit数增长约20%,pull request数增长约23%。从纯粹的"写代码"这个动作来看,AI编码工具带来的效率提升是实打实的。
问题出在下游。代码写出来之后必须经过review才能合并上线,而review环节完全没有跟上节奏:review时间增加了49%,需要返工修改的PR比例几乎翻倍,review中的评论数量多了约三分之一,被拉进来参与review的工程师人数也在增加。
论文的原话是:"生产力增益并未完全传导到软件产出或就业的变化上。"换句话说,代码写得多不等于软件交付得多。
为什么"写更多"没有变成"交付更多"
这个结果其实揭示了一个软件工程中的老问题:软件开发从来不是单一环节的游戏,而是一条流水线。当AI把"写代码"这个环节的速度大幅提升后,整条流水线的瓶颈就转移到了最慢的环节——审查和验证。
AI生成的代码需要人工审查,而审查者面对的是更多、可能质量参差不齐的代码。PR数量增加23%,但每个PR需要的审查时间和修改次数都在上升,审查者被大量低质量或需要返工的代码淹没,反而降低了整体流转效率。
这对团队的启示很直接:如果只投资AI编码工具,却不相应加强代码审查能力(无论是增加reviewer、改进review流程、还是用AI辅助review),那么投入的回报会被下游瓶颈吃掉。论文作者的观点很明确——要获得AI编码的真正收益,必须同时投资审查环节,而不只是让代码写得更多。
阿姆达尔定律(Amdahl's Law) 是计算机体系结构中的一个经典结论,但它对理解本文的现象同样贴切:一个系统的整体加速比,受限于其中无法被加速的部分所占的比例。假设软件交付流水线中"写代码"占总时间的30%,"审查与验证"占70%,那么即便把写代码环节的速度提升到无限快,整体交付速度的提升上限也只有约43%。AI编码工具正是在这个意义上触发了瓶颈转移——它加速了可加速的部分,却让不可加速或尚未被优化的审查环节成为新的约束。这解释了为什么代码产出增长30%,端到端交付却几乎没有变化:收益被下游的固定成本吃掉了。
瓶颈转移(bottleneck shift) 是约束理论(Theory of Constraints)中的核心概念。该理论认为,任何系统的产出都由其最薄弱的环节决定,优化非瓶颈环节不会提升整体产出,只会增加在制品(WIP)的堆积。在本文数据中,PR数量增加23%、审查时间增加49%、返工比例翻倍,正是典型的"上游加速、下游堵塞"信号:更多的代码并没有流经审查闸门变成可交付的软件,而是堆积在审查队列里,甚至以返工的形式回流。
这项研究的局限性
补充一点,这是一份尚未经过同行评审的工作论文。数据来自商业分析公司Jellyfish,可能存在平台用户的选择偏差。作者自己也强调,这些是短期效应——随着团队逐步适应新工具、调整工作流程,长期结果可能不同。
但即便有这些保留,"编码加速≠交付加速"这个核心发现仍然值得每个正在或准备引入AI编码工具的团队认真对待。它提醒我们:评估AI编码工具的价值时,不能只看代码产出指标,更要看端到端的交付效率。
选择偏差(selection bias) 指的是样本的构成并非随机,导致观测到的结果系统性地偏离总体真实情况。本文数据全部来自Jellyfish这一商业分析平台的客户。愿意付费购买工程效能追踪工具的企业,往往本身就规模较大、工程管理更规范、对度量指标更敏感——这类企业采用AI工具的速度、审查流程的成熟度,可能与不使用此类平台的中小团队存在系统性差异。因此,研究结论能否外推到整个软件行业,需要打一个问号。这是所有基于商业平台数据的研究都要面对的共性问题。
相关推荐

iPhone Duo续航实测:一天一充跑不掉,大屏是耗电元凶
iPhone Duo续航实测:重度使用一天需至少充电一次,6.5小时亮屏约剩30%电量。大屏展开频率是耗电关键,MagSafe电池背夹可救场,长期衰减同样值得关注。

Kimi K3.1 Pro开源发布:2.8万亿参数逼近Opus
Moonshot发布开源MoE模型Kimi K3.1 Pro,2.8万亿总参数、1040亿激活参数,Terminal Bench 4.0仅落后Opus 5.5不到1分,单任务成本约三分之一,API价格减半,开源权重11月4日开放。

Costco科技产品价格竞猜:显示器、键鼠、Bose音响值不值?
YouTube博主在Costco竞猜科技产品价格:2K 180Hz显示器、罗技键鼠、Bose音响和CyberPower UPS实测估价,揭示仓储会员店的选品定价逻辑与品牌溢价真相。