Haiku 5.5 实测对决 DeepSeek V4.1 Flash 与 GPT-6 Luna
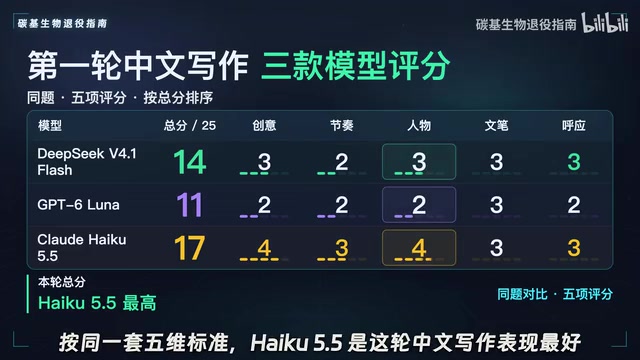
三款轻量AI模型实测:DeepSeek效果最佳但速度拖后腿,Haiku 5.5综合均衡但定价有陷阱,Luna全面落败。
本文对 Anthropic Haiku 5.5、DeepSeek V4.1 Flash 与 GPT-6 Luna 三款主打"快且便宜"的轻量模型,从中文写作、票据视觉推理和 3D 智能体编程三个维度进行横向实测。定价上,Haiku 5.5 对标 Luna 具竞争力,但超过 10 万 Token 后价格跳涨 5 倍,隐性成本不容忽视。中文写作 Haiku 5.5 本轮最佳,但仍逊于旗舰模型;15 张破损票据识别中,Haiku 5.5 与 DeepSeek 全部答对且 DeepSeek 速度快一倍,Luna 错三张;3D 纪念碑编程任务中 DeepSeek 效果最佳但耗时近一小时,Luna 唯一完成题词但方向错误,Haiku 5.5 视觉效果最差。综合来看,三款模型各有短板,用户应按具体任务类型匹配选择,而非追求"全能最强"。
国庆假期刚过,Anthropic 便推出了 Haiku 5.5,并把它定位成旗下"最快、最便宜"的模型。半个月内,大中小三档模型一次性集齐,节奏之快被不少人解读为冲刺 IPO 的信号。官方跑分显示,Haiku 5.5 在所列测评项目上全线领先 GPT-6 Luna。但纸面数据和真实体验往往有差距,本文结合 B 站 UP 主的实测,从中文写作、视觉推理和智能体编程三个维度,看看 Haiku 5.5、DeepSeek V4.1 Flash 与 GPT-6 Luna 这三款主打"又快又便宜"的轻量模型,谁才是这个价位真正能打的那一个。
阶梯定价:对标 Luna,却埋了隐藏成本
Haiku 5.5 的定价策略直接瞄准 GPT-6 Luna。在 10 万 Tokens 以内,它与 Luna 同价,并略低于 DeepSeek广告 的空闲价。看上去极具竞争力,但问题藏在后面:输入一旦超过 10 万 Tokens,Haiku 的四项价格会直接跳涨到 5 倍,大任务场景下甚至比 DeepSeek 的高峰价还贵。
这种阶梯式定价意味着用户在处理长文档、长上下文任务时必须格外小心,否则很容易在不知不觉中触发高价区间。实测者直言这种模式"让人用起来束手束脚",削弱了"最便宜"这个卖点的说服力。对于真正跑大任务的开发者来说,这是一个需要提前算清楚的隐性成本。
阶梯式 Token 定价是当前大模型 API 市场的常见策略,本质上是以"低门槛吸引试用、高用量覆盖成本"的价格歧视模型。Token 是模型处理文本的基本计量单位,中文语境下大致 1 个汉字对应 1.5–2 个 Token,10 万 Token 约等于 5–6 万汉字,相当于一篇中等长度的行业报告或数十轮长对话的上下文。对于日常轻量查询,这个阈值鲜少触达;但在 RAG(检索增强生成)、长文档分析、多轮智能体任务等场景下,单次调用轻松突破这条线。因此,开发者在选型时不能只看"起步价",需要按实际业务的平均上下文长度和调用频次,折算出加权单价,才能做出真正划算的决策。
中文写作:Haiku 5.5 本轮领先,但不及头部模型
第一轮测试沿用了此前测评头部模型时的题目——创作长篇小说《修真奶茶铺》的第一章。三款轻量模型使用同一道题、同一套评分标准进行横向比较。
按照统一的 5 分制标准,Haiku 5.5 是这一轮中文写作中表现最好的。不过与上一期的 GPT-6 Astra 相比,测评者仍觉得"差一点",说明轻量模型在长篇叙事的连贯性与文采上,与旗舰级模型还有可见的距离。
值得肯定的是,测评者把三款模型的小说原文、完整提示词和评分标准都整理进了文档,鼓励读者按同一套标准自行打分。这种可复现的测评方式,比单纯公布一个分数更有参考价值。
视觉推理:15 张票据的硬核考验
第二轮用了一个贴近真实办公痛点的任务:识别 15 张来自不同地区、年份和格式的票据,其中部分已经模糊破损,甚至字段被涂抹或缺失。模型需要先识别票面信息,再结合上下文推断残缺内容,同时又不能"过分脑补"引入幻觉。测评者表示,人工完成这项工作至少要 15 分钟。
结果颇具看点:GPT-6 Luna 错了三张,而 Haiku 5.5 和 DeepSeek V4.1 Flash(视频中昵称"小鲸鱼")全部答对。速度上,DeepSeek 比 Haiku 还快了一倍。
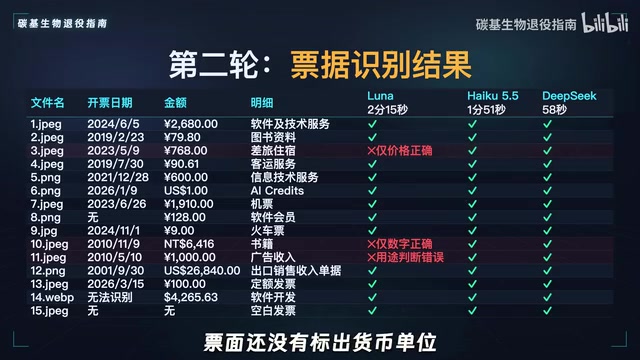
最难的是第 10 张票据——金额和名目均为手写,票面还未标注货币单位,模型必须先判断票据来自哪个地区,再推断对应货币。Luna 除了数字之外几乎没能判读出其他信息,而 Haiku 和 DeepSeek 的表现"出乎意料"。
这类任务的现实意义很强:面对泛黄、破损、信息残缺的纸质旧资料,可以先拍照或扫描,让模型提取关键信息并归纳分类,疑点处标注出来再由人工核对。方法和工具选对,原本一周的整理量有机会压缩到一天完成。
票据识别属于文档视觉理解(Document Visual Understanding)任务,要求模型同时具备 OCR(光学字符识别)、版面分析与跨字段语义推理三种能力。与识别清晰印刷体不同,破损票据还涉及图像去噪、残缺信息补全和地域常识推断——例如根据票面印章、纸张风格或地名判断货币体系。这类任务对模型的幻觉控制要求极高:过于保守会漏识,过度推断又会捏造信息。当前主流多模态大模型普遍将视觉编码器与语言模型联合训练,使模型在"看到图像"的同时能调用语言侧的世界知识进行补全,这正是 Haiku 5.5 和 DeepSeek 在第 10 张手写票据上能推断出货币单位的底层原因。
智能体编程:3D 纪念碑考验工程能力
第三轮进入智能体编码环节,题目是制作一个 3D 人民英雄纪念碑:镜头要连续 360 度环绕,光影还需模拟全天 24 小时的变化。这是一道综合考验建模、渲染与代码工程能力的难题。
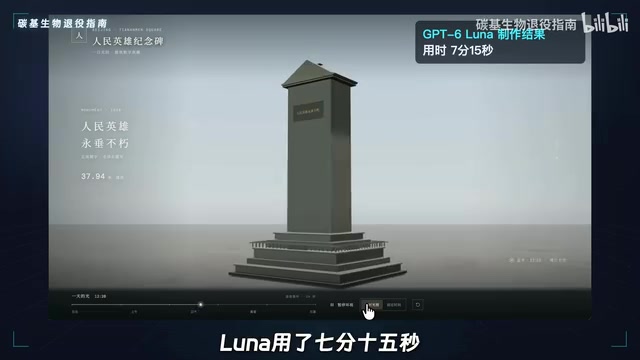
GPT-6 Luna 用时 7 分 15 秒,是唯一把碑身题词做出来的模型,但方向出错——把竖向排版做成了横向。碑身其他细节不足,日出日落光照还原也欠佳。不过从代码结构看,拆分规范,后续测试和维护更方便。
Haiku 5.5 用时 8 分 23 秒,视觉效果最差,除日出日落光照更贴近现实外,整个碑身"几乎没法看"。其代码特点是参数集中编写,调整修改较为方便。
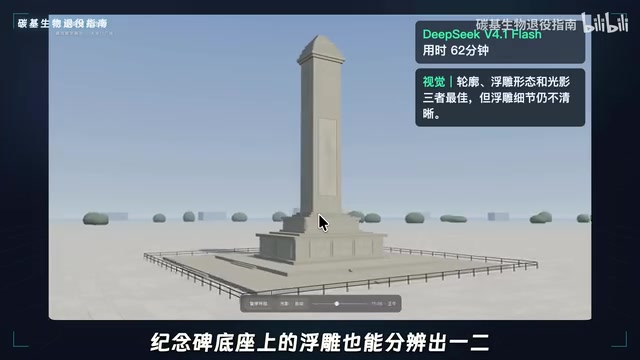
DeepSeek V4.1 Flash 的整体效果无疑最好,纪念碑底座的浮雕都能分辨出一二,代码上做了功能封装和性能优化。但它"居然花了一个小时",而且是在晚上 9 点后的低谷时段完成——这个速度被测评者吐槽"太不够中国速度"。此外,它在工程拆分和测试环节仍有不足。
智能体编程(Agentic Coding)与普通代码补全的核心区别在于:模型需要自主分解任务、决定工具调用顺序、处理中间步骤的错误反馈,并最终交付可运行的完整工程,而非仅仅填写单一函数体。3D 渲染场景尤为复杂——模型通常会选择 Three.js 或 WebGL 等浏览器端渲染库,需要同时处理几何体构建、材质贴图、动态光照和摄像机动画等模块,任何一处参数出错都会影响最终视觉效果。测试中 DeepSeek 做出了浮雕细节并进行了功能封装,说明其在代码抽象和模块化方面更为成熟,但长达一小时的生成时间也暴露出推理吞吐量的瓶颈,在时延敏感的生产环境中会成为明显制约。
三轮综合:速度与质量的权衡
三轮比下来,结论相对清晰:GPT-6 Luna 在任务结果上输得较惨;DeepSeek V4.1 Flash 一如既往地能打,视觉和代码都很亮眼,但三轮加起来跑了一个多小时,速度拖了后腿;Haiku 5.5 在中文写作上本轮领先,视觉推理表现出色,但在编程视觉效果上明显落后。
换句话说,这三款模型没有一个"全能冠军"。追求结果质量可以看 DeepSeek,但要有等待的心理准备;在意速度和写作可以考虑 Haiku 5.5,不过要注意超过 10 万 Tokens 后的价格跳涨。测评者也呼吁 DeepSeek 团队多投入硬件,把推理速度提上来,真正跑出"中国速度"。
对于普通用户和开发者而言,与其纠结哪家"最强",不如结合具体任务——写作、票据整理还是 3D 建模——去匹配最适合的模型。把方法和工具选对,才是提升效率的关键。
相关推荐

Linux内核AI内战:反AI斗士入TAB,Torvalds取消AI披露
反AI活动人士Laurent Pinchart当选Linux内核技术咨询委员会成员,同时Linus Torvalds取消AI代码披露要求。本文梳理内核社区AI内战的最新进展、双方立场及对开源生态的影响。

育儿付费从何时成为常态?职场妈妈与托育变迁
育儿付费何时成为常态?本文梳理从70-80年代托育中心兴起、90年代联邦补贴挂钩工作要求,到污名下降与成本上升的演变,并探讨倡导者推动托育与带薪产假追赶其他国家的25年努力。

AI智能体最该接管的任务是什么?Reddit热议
Reddit热议:你最希望AI智能体完全接管哪项任务?跨应用数据迁移、CRM更新、报告生成位列榜首,但可靠性不足和信任鸿沟成为自动化落地的最大障碍。