Harness 决定成败:Codex CLI 让本地 LLM 脱胎换骨

执行框架(Harness)对本地LLM实际效果的影响,可能远超模型本身的benchmark差距。
一位拥有双路3090的开发者发现,本地LLM长期无法胜任严肃编程工作,直到他将执行框架从pi.dev和opencode切换到Codex CLI,同一模型的表现才出现质的飞跃。在Codex CLI加持下,Qwen 3.8 Flash Next在实际项目中甚至反超了benchmark分数更高的GPT 5.6 Luna。他还将pi.dev的联网搜索功能移植为Codex技能,并计划开源。这一案例的核心启示是:对本地LLM用户而言,"选框架"与"选模型"同等重要——相同的权重和硬件,在不同harness下可用性可能横跨"完全不能用"到"生产首选"两个极端。作者也诚实地承认,不能排除pi.dev配置未优化的可能性,结论仍待更多可控实验验证。
同一个模型,为何表现天差地别?
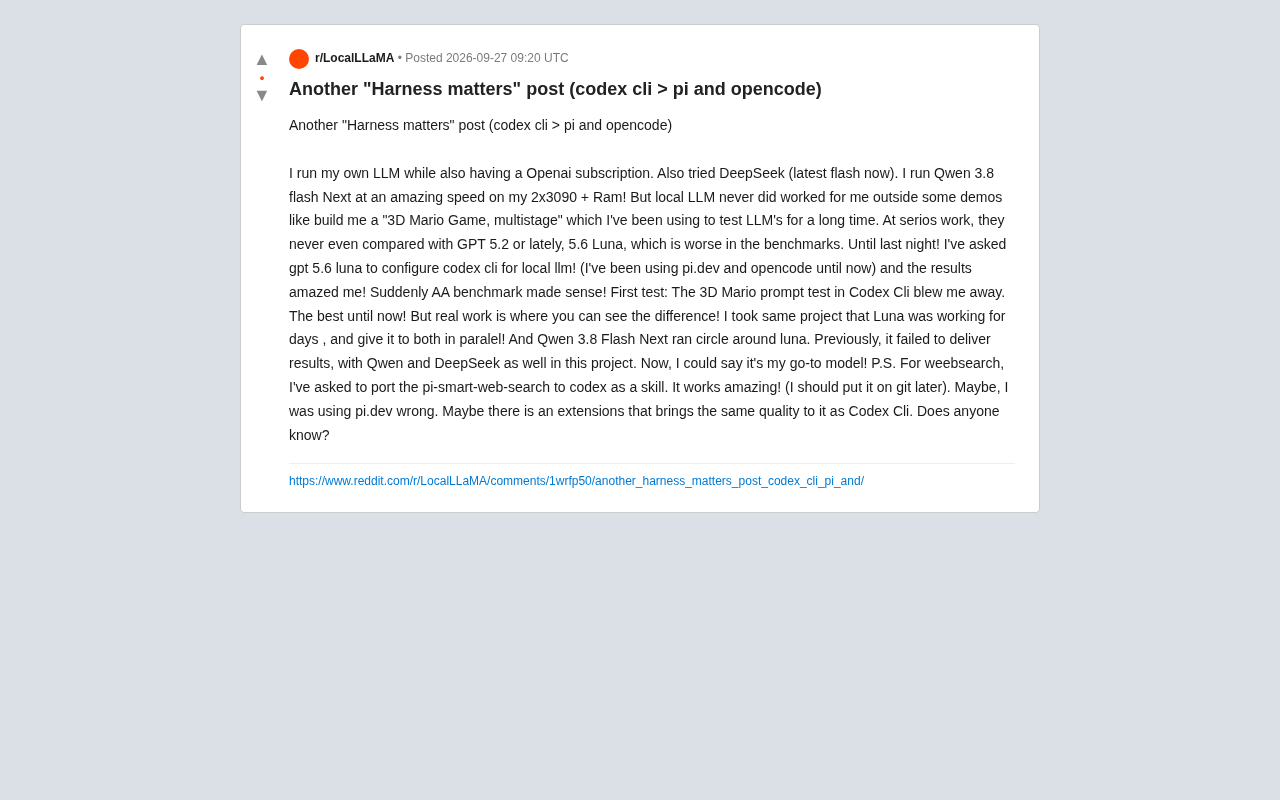
一位 Reddit 用户分享的实测经历,再次印证了 AI 编程社区里那句老话——"Harness matters"(工具链/执行框架很重要)。他同时拥有 OpenAI 订阅、本地部署的 LLM,还试用过 DeepSeek广告 的最新 flash 版本。硬件配置相当扎实:双路 3090 加大内存,能以惊人的速度运行 Qwen 3.8 Flash Next。
但问题在于,本地 LLM 在他手里始终只是"能跑 demo"的玩具。除了那个被他长期用来测试模型的经典任务——"帮我做一个多关卡的 3D 马里奥游戏"——一旦进入真正的严肃工作,本地模型从未能和 GPT 5.2、乃至后来 benchmark 分数更低的 5.6 Luna 相提并论。
转折点:换了 Harness,本地模型突然"开窍"
转机出现在他尝试让 GPT 5.6 Luna 帮忙把 Codex CLI 配置成对接本地 LLM 之后。此前他一直使用 pi.dev 和 opencode 作为执行框架,结果并不理想。换到 Codex CLI 后,效果让他大为震撼。
用他自己的话说:"AA benchmark 突然就说得通了。"第一轮测试依旧是那个 3D 马里奥的提示词,在 Codex CLI 里跑出的结果是他见过最好的一次。
这个细节值得所有关注本地模型的开发者留意:模型权重没变、硬件没变、提示词没变,唯一改变的是承载模型的执行框架(harness),产出质量却出现了质的飞跃。这说明当下评价一个模型"好不好用",很大程度上取决于它被放在什么样的工具链里运行。
**Harness(执行框架)**在 AI 编程领域特指包裹模型调用的整套工具链,涵盖上下文管理策略、系统提示词的组织方式、工具调用(tool call)的调度逻辑、多轮对话的状态维护,以及与文件系统、终端、外部 API 的交互协议。同一个模型权重,通过不同 harness 调用时,实际接收到的 prompt 结构、token 预算分配、错误重试机制都可能截然不同。Codex CLI 是 OpenAI 推出的面向开发者的命令行 AI 编程助手,其核心设计理念是赋予模型对本地代码库的直接读写和执行权限,并通过结构化的任务分解提示显著提升多步骤编码任务的完成率。pi.dev 和 opencode 则是另外两款定位类似但实现路径不同的 agentic 编程框架,各自在上下文压缩和工具调用策略上有不同取舍。框架层面的这些差异,往往比模型参数量级对实际编码体验的影响更为直接。
并行实测:Qwen 3.8 Flash Next 反超 Luna
真正能看出差距的是实际项目。作者把一个 Luna 已经连续工作了好几天的项目,交给两套方案并行处理。结果令人意外——在 Codex CLI 加持下的 Qwen 3.8 Flash Next 把 Luna 甩在了身后。
更关键的是对比历史:在此之前的同一个项目里,无论是 Qwen 还是 DeepSeek 都曾交不出结果。而现在,作者直言 Qwen 3.8 Flash Next 已经成为他的首选模型(go-to model)。
这个案例的价值不在于"本地模型碾压闭源模型"这样的结论——毕竟样本单一、缺乏可复现的量化数据——而在于它揭示了一个常被忽视的变量:同一个本地模型,在不同 harness 下的可用性可能横跨"完全不能用"到"生产首选"两个极端。
联网搜索:把 pi 的能力移植成 Codex 技能
作者还提到一个实用的工程细节:为了让 Codex CLI 具备联网搜索能力,他让模型把 pi 生态里的 pi-smart-web-search 功能移植成了 Codex 的一个 skill(技能/插件),并表示效果非常好,打算之后开源到 Git 上。
这一操作本身也是"harness matters"的延伸——执行框架的能力边界,很大程度上由其可扩展的技能/插件体系决定。Codex CLI 的技能机制让用户能把其他工具的优势特性迁移进来,从而不断补齐短板。
pi-smart-web-search 是 pi.dev 生态中内置的联网检索功能,能在对话过程中实时抓取和摘要网页内容,从而让模型在回答技术问题时引用最新文档或 Stack Overflow 帖子,而不局限于训练数据截止日期前的知识。将其移植为 Codex CLI 的 skill 意味着需要用 Codex 的工具注册机制编写一个包装函数:定义函数签名(输入查询字符串、输出摘要文本)、处理 HTTP 请求与结果解析,再通过 Codex 的 tools 配置将其暴露给模型。这类技能移植属于 agentic 框架的能力迁移——不同框架的底层工具调用协议大多基于 OpenAI function calling 规范,使得跨框架移植具备一定可行性,但仍需适配各框架特有的沙箱权限与调用时序。
尚待验证的疑问:是不是 pi.dev 用错了?
作者在帖子结尾保留了足够的诚实与开放:"也许是我 pi.dev 用错了。也许有某个扩展能让它达到 Codex CLI 同样的质量。有人知道吗?"
这是一个非常合理的追问。单一用户、单一项目的对比很难排除配置差异、参数设置、上下文管理策略等干扰因素。Codex CLI 在其测试中胜出,未必是框架本身绝对更强,也可能是默认配置更契合本地模型的调用方式,或者 pi.dev/opencode 需要额外调优才能发挥同等水平。
对开发者的几点启示
抛开个案的局限性,这篇分享传递的信号对本地 LLM 用户很有参考意义:
-
不要仅凭模型 benchmark 下结论。benchmark 分数更高的模型(如 Luna)在实际项目中未必更快、更可靠,执行框架会显著改变最终体验。
-
换 harness 是低成本的高杠杆操作。在不更换硬件、不重新训练模型的前提下,尝试不同的 CLI/agent 框架,可能直接决定本地模型"能不能干活"。
-
技能/插件生态是关键竞争力。联网搜索这类能力能否方便地移植和扩展,直接影响框架的实用天花板。
对于手握 3090 这类消费级/准专业硬件、想把本地模型真正投入生产的人来说,值得把"折腾 harness"当作和"选模型"同等重要的环节来对待。
相关推荐

Gemini 4 Argon实测:AI自主造桌游、建寺庙、训机器人
Gemini 4 Argon 实测汇总:AI 自主用 Blender 搭建书桌赛道与寺庙、编写光线追踪引擎、训练人形机器人连进7球,并附 API 定价与开发者接入方式。

魔法八边形硬币:为何仅9%的人能预测它的翻转?
魔法八边形硬币仅9%的人能正确预测其翻转方向。本文解析其空间旋转机制、常见认知误区,并介绍基于相关性理论的新假说,探讨人类空间推理的局限。

Sam Altman:AI正迈入科学发现时代,数学突破将复制到生物与能源
Sam Altman 表示 AI 正进入科学发现时代,数学领域的突破方法将复制到生物学、材料科学和能源领域,帮助研发新药与新能源。他认为这种影响不会让人直接感知,而是融入社会日常运转。