HarnessTax:编码智能体的"外壳"到底有多重要?
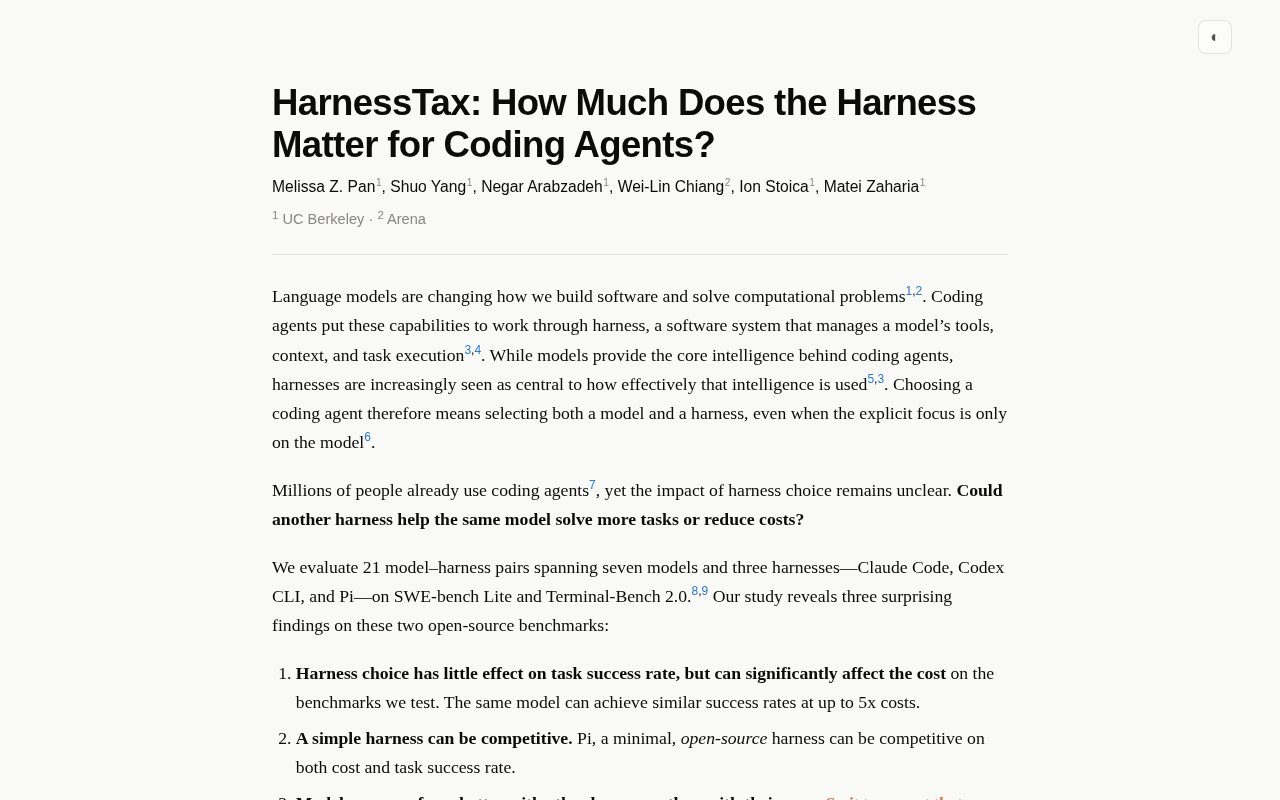
编码智能体的性能有多少来自模型本身、又有多少来自工程外壳——"HarnessTax"提出了这一被长期忽视的归因问题。
文章围绕"HarnessTax"这一概念展开,探讨在评估 AI 编码智能体时如何区分底层模型与外层工程框架(harness)各自的贡献。Harness 涵盖提示词工程、上下文管理、工具调用逻辑等架构层,同一模型套上不同 harness 表现可能天差地别。"外壳税"的比喻暗示 harness 既能放大模型能力,也可能消耗其潜力。对于开发者选型,文章建议关注工具在不同底层模型上的稳定性、上下文管理是否透明、以及真实代码库中的表现,而非单一排行榜分数。文章同时坦承,该讨论来自一个热度极低的 Hacker News 帖子,目前缺乏充分的实证数据,更多是提供一个能力归因的思维框架。
什么是编码智能体的"Harness"?
当我们谈论 AI 编码工具(如各类代码助手和自动化编程智能体)时,往往把注意力集中在底层大模型的能力上——它到底有多强、能不能理解复杂需求、写出的代码质量如何。但一个常被忽视的问题是:包裹在模型外层的"harness"(工程外壳/框架)究竟贡献了多少价值?
Harness 指的是模型与实际编码任务之间的那层工程架构,包括提示词工程、上下文管理、工具调用逻辑、文件读写策略、错误处理与重试机制等。同一个基础模型,套上不同的 harness,最终在真实软件工程任务上的表现可能天差地别。
近期一篇题为《HarnessTax: How Much Does the Harness Matter for Coding Agents?》的讨论在 Hacker News 上出现,抛出了这个值得深思的命题:在评估编码智能体的整体表现时,我们应当如何区分"模型的功劳"和"外壳的功劳"。
在软件工程中,"harness"一词本义是"测试框架"(test harness),指用于驱动和验证被测系统的辅助代码。在 AI 智能体语境下,它被借用来描述包裹模型的整套执行架构。以 SWE-bench 等主流编码能力基准测试为例,参赛系统通常需要自主完成"读取代码库→理解 Issue→定位文件→修改代码→运行测试"这一完整流程,而模型本身只负责其中的推理与生成环节,其余的文件系统操作、shell 命令执行、多轮对话状态维护等都属于 harness 的职责范围。典型的商业实现包括 Anthropic 的 Claude Computer Use、GitHub Copilot Workspace 以及开源的 SWE-agent 框架,它们使用相同或相近底层模型,但在 harness 设计上各有侧重,最终在 SWE-bench 上的修复成功率可相差 10–20 个百分点以上。
"HarnessTax"概念的核心意涵
从标题中的 "HarnessTax"(外壳税)一词可以看出作者的问题意识。这里的"税"是一个隐喻——它暗示 harness 层既可能带来收益(提升智能体的可靠性和任务完成率),也可能带来成本或损耗(额外的 token 消耗、延迟、以及因框架设计不当而对模型能力造成的限制)。
换句话说,一个设计精良的 harness 能让中等能力的模型发挥出超预期的表现;而一个笨拙的 harness 则可能"税"掉强大模型的相当一部分潜力。这个视角对于当前市场上层出不穷的编码智能体产品评测不能忽视。
为什么这个区分很重要
当下的 AI 编程赛道竞争激烈,众多产品都宣称自己"更懂代码"、"完成率更高"。但这些提升究竟来自:
- 底层模型的迭代升级;
- 还是外层 harness 的巧妙工程设计?
如果一款产品的优势主要来自 harness,那么当竞争对手接入同样的底层模型并优化自己的外壳后,这种优势可能迅速被抹平。反之,如果优势来自模型本身,则壁垒更为坚实。理解这一点,对开发者选型、对投资者判断产品护城河,都至关重要。
对开发者选型的启示
对于正在选择编码智能体工具的工程团队,这个命题提供了一个更理性的评估框架。与其被"完成了多少个 benchmark 任务"这样的营销数字吸引,不如追问:
- 该工具在不同底层模型上表现是否稳定?如果换掉模型后性能大幅下滑,说明其 harness 高度依赖特定模型的"脾气"。
- 它的上下文管理和工具调用逻辑是否透明可控?
- 在真实、复杂的代码库中(而非玩具级示例)表现如何?
这些问题的答案,往往比单一的排行榜分数更能反映工具的实际价值。
工程实践层面的思考
对于自研编码智能体的团队而言,"HarnessTax"的视角提醒我们:模型能力与工程外壳需要协同优化,而非各自为政。一个理想的 harness 应当"放大"模型的长处、"补齐"模型的短板,同时把额外开销控制在合理范围内。这需要在提示词设计、上下文窗口利用、错误恢复机制等多个环节反复打磨。
从技术实现角度看,harness 的核心挑战之一是上下文窗口管理。真实代码库动辄数百万 token,远超当前模型的上下文长度限制,harness 必须决定"喂给"模型哪些文件片段、调用栈、文档注释。检索增强生成(RAG)、文件树摘要、符号级索引(如 Tree-sitter 解析 AST)都是常见手段。另一个挑战是工具调用的可靠性:当模型输出格式不规范或工具返回错误时,harness 需要设计重试与降级策略,而这些策略本身会显著影响最终成功率。这些工程细节高度依赖经验积累,难以从模型评测指标中直接推断,这也是"HarnessTax"概念的实践意义所在。
讨论的局限与延伸
需要说明的是,这篇 Hacker News 帖子目前热度和讨论量都较低(仅 4 个赞、暂无评论),因此我们无法从社区讨论中获取更多定量数据或实验结果来验证"HarnessTax"到底有多大。文中提出的更多是一个值得研究的框架性问题,而非已有充分实证支撑的结论。
尽管如此,这个命题本身抓住了当前 AI 编程工具评测中的一个真实痛点:我们习惯于把智能体当作一个黑盒整体来评价,却很少拆解其内部的能力归因。随着编码智能体愈发普及,如何科学地进行"模型 vs. 外壳"的能力拆解,很可能成为下一阶段评测方法论的重要课题。
对于关注 AI 编程领域的从业者,不妨把"HarnessTax"作为一个思维工具:下次看到某款编码智能体的亮眼数据时,多问一句——这里面,究竟有多少是模型的功劳,又有多少是外壳的功劳?
相关推荐
多智能体SOC应用的LLM选型策略:规则路由还是LLM自主决策?
在 LangGraph 多智能体 SOC 应用中,LLM 选型应采用规则路由还是让 LLM 自主决策?本文分析两种方案的权衡,并给出适合安全运营场景的混合路由策略建议。
Snap再推2200美元智能眼镜,能否说服市场?
Snap本周为其售价2200美元的智能眼镜发布新功能,再次尝试证明产品价值。本文分析Snap智能眼镜的定价困境、市场定位及其在AR眼镜赛道的行业意义。
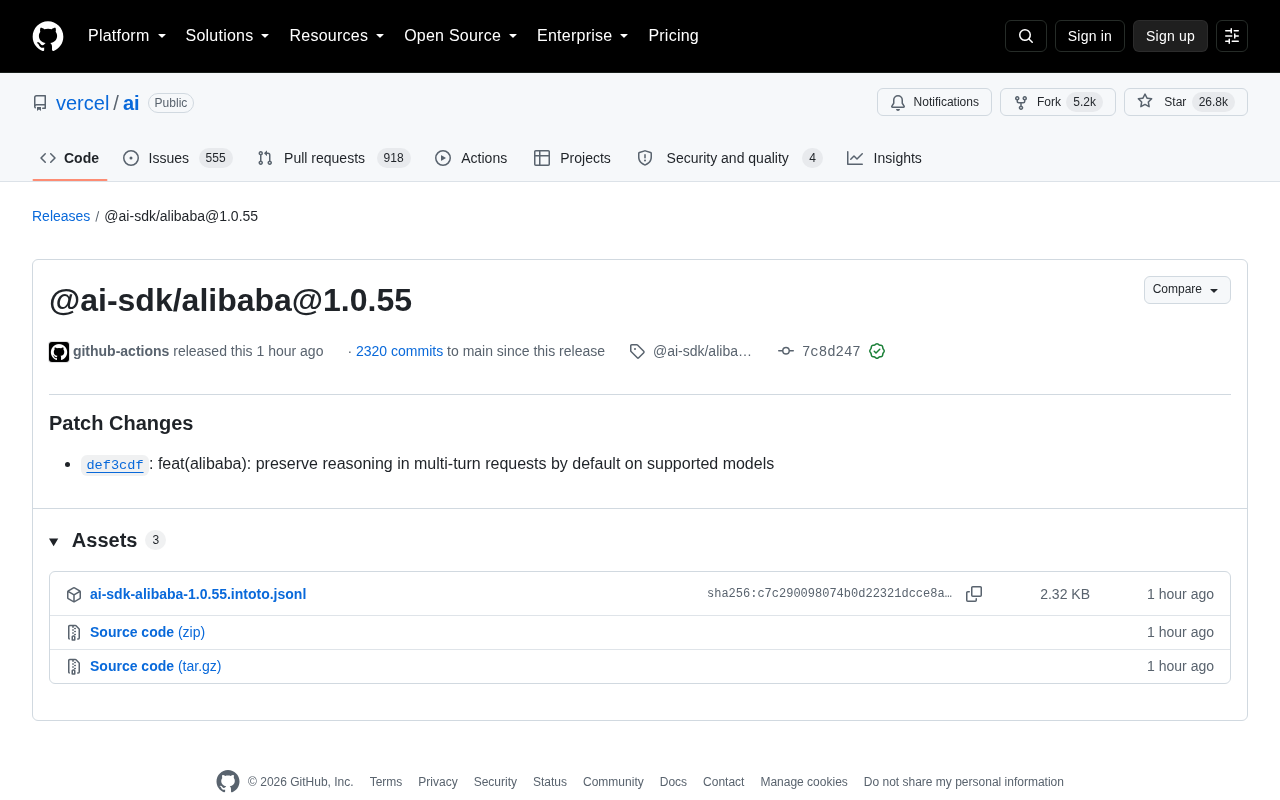
Vercel AI SDK 更新:阿里巴巴模型支持多轮推理保留
Vercel AI SDK 发布 @ai-sdk/alibaba@1.0.55 补丁更新,为阿里巴巴受支持模型默认启用多轮请求中的推理保留(reasoning)能力,优化多轮对话与 Agent 场景体验。本文解析该更新的核心变化与开发者应对建议。