Hindsight:会自我学习的AI Agent记忆系统解析

Hindsight是一个让AI Agent记忆能够自我学习进化的开源项目,单周新增Star超1.4万。
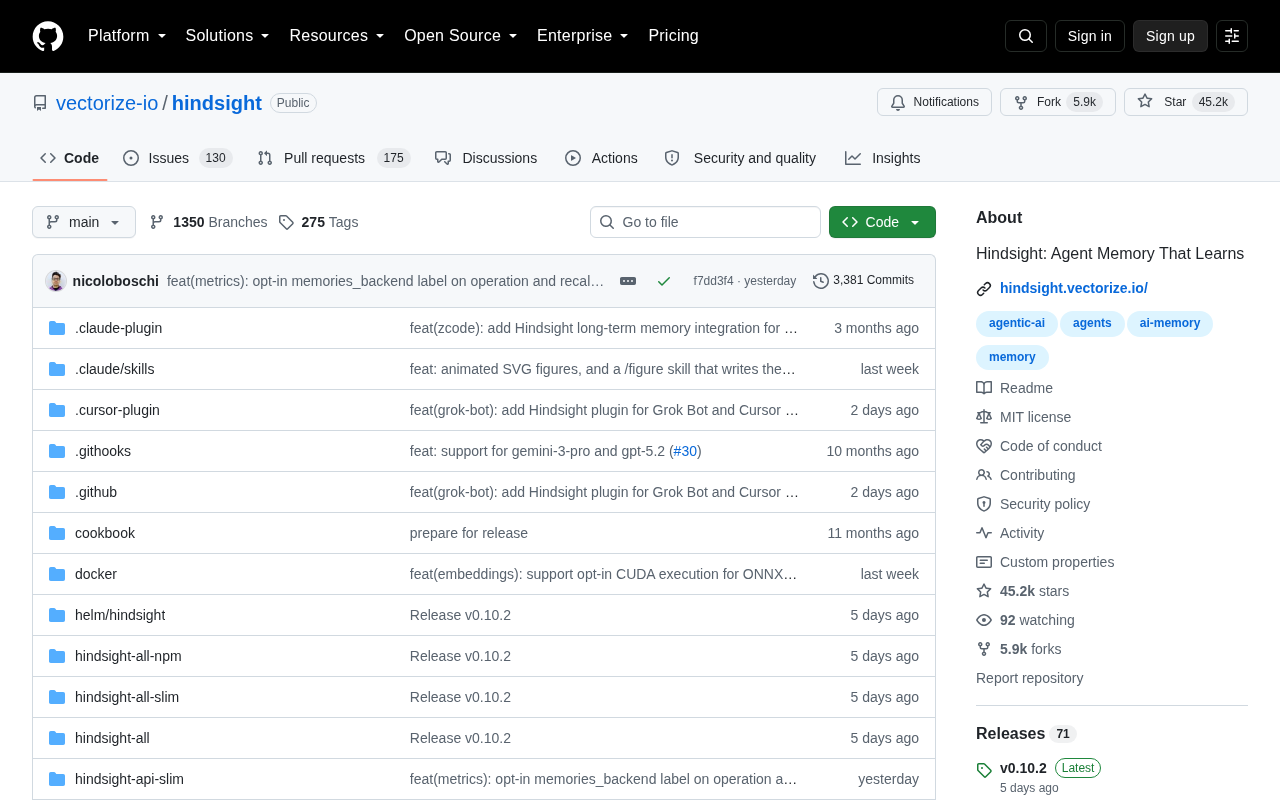
Hindsight是由vectorize-io团队开源的AI Agent记忆层,核心理念是将Agent记忆从静态的向量存储升级为动态的学习系统。不同于传统RAG方案仅做"存与取",Hindsight借鉴"事后之明"的概念,让记忆系统在交互后主动反思、归纳,将具体经历提炼为可复用的高层知识。项目使用Python编写,契合LangChain、LlamaIndex等主流Agent框架生态。GitHub Star超4.5万、单周新增1.4万的增速,反映出开发者社区对长期个性化Agent记忆方案的迫切需求。不过,可学习记忆也引入了记忆更新、遗忘策略、错误固化等新的工程挑战,建议团队在生产落地前进行充分验证。
为什么AI Agent需要"会学习的记忆"
大语言模型驱动的AI Agent正在从实验走向生产环境,但一个长期存在的瓶颈始终困扰着开发者——记忆。传统的检索增强生成(RAG)方案往往只是把对话历史或文档片段简单塞进向量数据库,检索时按相似度召回。这种做法在短期任务中尚可应付,但当Agent需要跨会话、跨任务地积累经验时,它既记不住重要的教训,也无法从过往交互中提炼出更高层次的认知。
vectorize-io团队开源的 Hindsight 项目,正是瞄准了这个痛点。它的核心定位是"Agent Memory That Learns"——一个会随着使用不断学习和进化的Agent记忆层。项目在GitHub上获得了超过4.5万颗Star,单周新增Star超过1.4万,这种增长速度本身就说明开发者社区对"可学习记忆"这一方向抱有极高期待。
Hindsight 想解决的核心问题
从项目命名可以读出设计者的意图。"Hindsight"意为"事后之明",指的是人在经历事件之后形成的更清晰、更深刻的理解。把这个词用在Agent记忆系统上,传达的理念是:记忆不应只是对原始信息的被动存储,而应当像人类回顾经历那样,经过反思、归纳后沉淀为可复用的知识。
这与当前主流记忆方案形成明显区别。一般的向量记忆方案关注"存与取",而Hindsight强调的是"学"——即记忆系统本身具备从交互中提炼模式、更新认知的能力。对于需要长期运行、持续与用户或环境交互的Agent来说,这种能力意味着它可以逐渐变得更"懂"特定场景,而不是每次都从零开始。
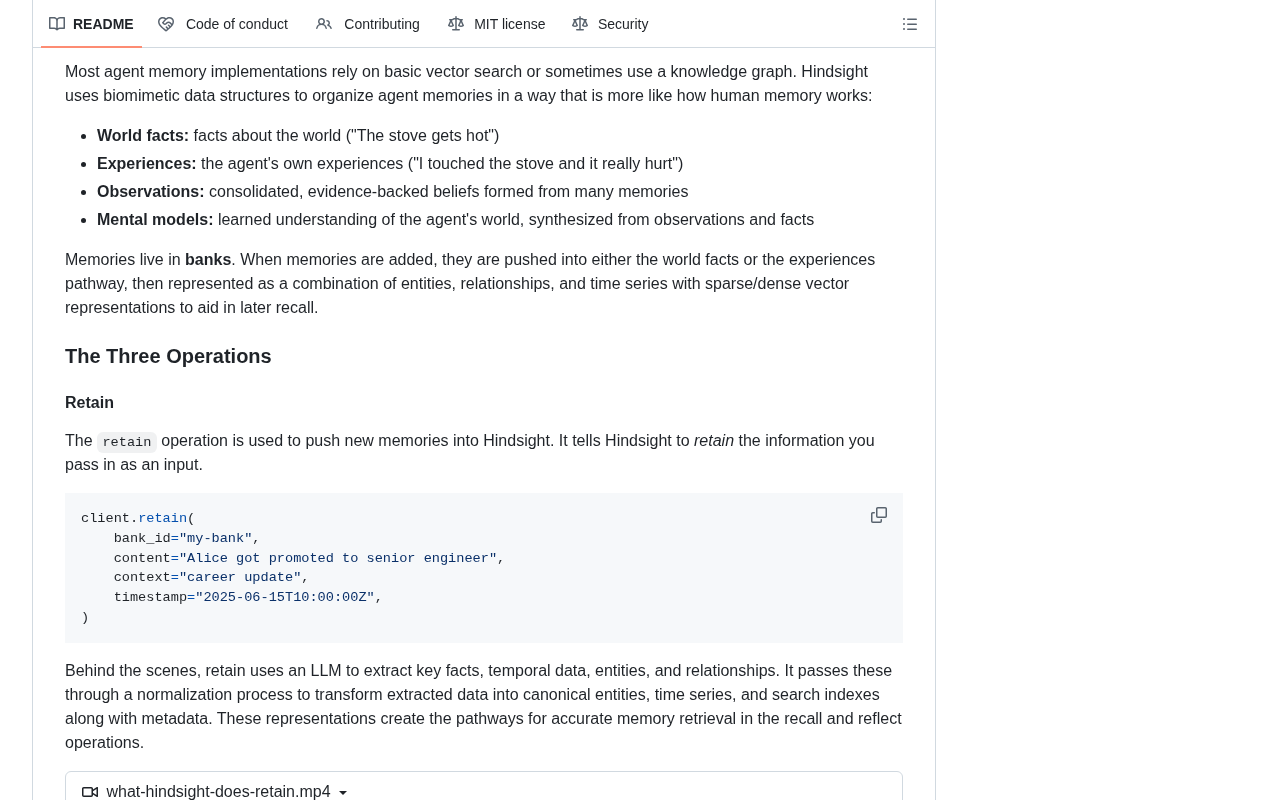
从认知科学角度看,"事后之明"(hindsight)对应的是人类记忆中的情节记忆向语义记忆转化过程:具体的经历经过反复提取和重新编码,逐渐抽象为可泛化的规则或概念。将这一机制移植到Agent系统,意味着记忆层需要在原始对话片段之上额外运行一层"反思"(reflection)或"摘要"(summarization)过程,由模型自动提炼出高层次的行为规律或用户偏好。这与MemGPT、Reflexion等学术方向高度吻合——这些研究均发现,让Agent在任务结束后显式生成"经验总结"并写回记忆,能显著提升跨任务迁移能力。Hindsight的价值在于将这一研究思路工程化,打包成可直接集成的开源库。
技术定位与生态背景
项目使用 Python 编写,这符合当前AI Agent开发的主流技术栈,便于与LangChain、LlamaIndex等框架以及各类向量数据库集成。开发方 vectorize-io 本身在向量检索与数据管道领域有积累,将这套工程能力延伸到Agent记忆层是顺理成章的布局。
从更大的行业视角看,Agent记忆正成为2026年前后AI基础设施竞争的关键战场。无论是通用Agent框架还是垂直领域的智能助手,记忆能力的强弱直接决定了产品能否提供连贯、个性化的长期体验。Hindsight这类专注于"可学习记忆"的开源项目,补上了Agent技术栈中相对薄弱的一环。
RAG(检索增强生成)是目前最主流的Agent外部记忆方案:将文档或历史对话切分为文本块,通过嵌入模型(Embedding Model)转化为向量后存入向量数据库(如Pinecone、Weaviate、Chroma等),查询时以当前输入的向量为锚点做近邻检索,将召回片段拼入提示词。这一方案的局限在于:它只做"存"和"取",而不对记忆内容做任何质量判断或知识提炼,导致噪声信息与有价值信息混杂存储,长期运行后检索精度下降,且无法主动更新过时知识。Hindsight所针对的正是RAG在Agent长期记忆场景下的这一结构性缺陷,其思路是在向量存储之上增加一个由LLM驱动的"记忆管理器",负责决策哪些信息值得保留、如何归纳、何时覆盖。
对开发者意味着什么
对于正在构建生产级Agent的团队,Hindsight提供了一条值得评估的路径。相比自行从头实现记忆管理逻辑,采用一个专门设计、并经过社区验证的记忆层,可以显著降低工程负担。短期内暴涨的Star数也反映出早期采用者的热情——尽管Star数不能完全等同于生产可用性,但它确实是社区关注度的一个有力信号。
需要提醒的是,"会学习的记忆"在带来能力提升的同时,也引入了新的复杂度:记忆如何被更新、旧知识如何被遗忘或修正、如何避免错误经验被固化等,都是实际落地时需要谨慎处理的问题。建议开发者在接入前仔细阅读项目文档,结合自身场景做小规模验证。
记忆更新机制的设计是可学习记忆系统最棘手的工程问题之一。核心挑战包括:遗忘策略(如何识别并淘汰过时或低价值记忆,避免存储无限膨胀)、冲突消解(当新经验与已有记忆矛盾时应以哪方为准)、以及错误强化(如果Agent在某次交互中得出错误结论并将其写入记忆,后续任务可能因此持续出错)。这些问题在人类记忆研究中对应"遗忘曲线"与"记忆再巩固"理论,但工程实现时需要在准确性、延迟与成本之间做出取舍。开发者在评估Hindsight时,建议重点考察其对上述场景的处理策略,尤其是在高频写入场景下记忆质量能否保持稳定。
小结
Hindsight代表了AI Agent记忆方向上一个有意思的探索:把记忆从静态的"存储仓库"升级为动态的"学习系统"。在Agent应用快速普及的当下,这种思路契合了行业对长期、个性化智能体的需求。它的高速增长的社区热度,值得持续关注。对于关注Agent基础设施的开发者而言,这是一个值得纳入技术选型雷达的开源项目。
相关推荐

恒星究竟能有多大?最大恒星的物理极限
红超巨星是宇宙中体积最大的恒星,半径可达太阳的2000倍,吞没内太阳系。但恒星尺寸没有精确上限,模型预测可达15000倍太阳半径。质量最大的蓝色恒星体积远小于红超巨星——最大和最重是两回事。

苹果HomeView智能屏全功能解析:墙挂桌面两用,299美元
苹果发布299美元智能显示屏HomeView,支持壁挂和桌面两种安装方式,配备1200万像素摄像头实现面部识别,可控制智能家居、播放音乐、发送食谱到屏幕逐步跟做。本文全面解析HomeView的表盘、应用扩展、隐私保护和烹饪集成等核心功能。

承诺的新工作室去哪了?Craft Computing用五年时间给出答案
Craft Computing主理人回应观众质疑:承诺五年的新工作室因建设成本从3万暴涨至7.5万美元而搁浅,最终改为168平方英尺车库改造空间。频道收入因算法变化下滑,内容方向也将转向更务实的项目制作。