HiSA:在RoPE注意力隐藏维度上实现稀疏化
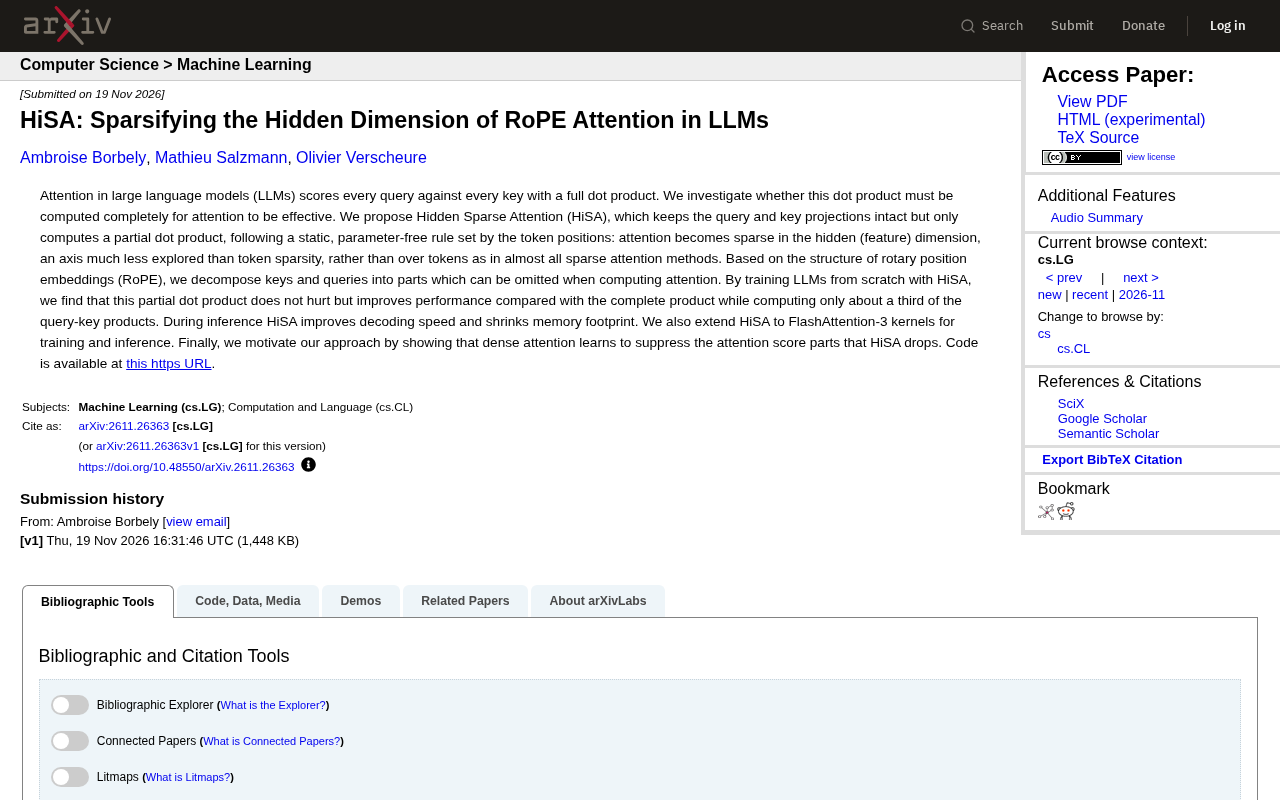
HiSA在隐藏维度而非token维度稀疏化注意力,仅算约三分之一点积却性能不降反升。
HiSA(Hidden Sparse Attention)提出一种正交于主流 token 稀疏化的注意力优化思路:保持查询和键的投影不变,但只计算部分隐藏维度上的点积,省略规则静态、无参数,由 token 位置决定,并依托旋转位置编码(RoPE)的结构实现。研究团队从零训练 LLM 后发现,这种部分点积不仅未损害性能,反而相比完整点积有所提升,同时只需约三分之一的查询-键乘积。推理阶段,HiSA 提升解码速度并降低内存占用;团队还将其扩展到 FlashAttention-3 内核并开源代码。文章指出,密集注意力本身会学习抑制 HiSA 所丢弃的分数部分,说明模型本就有抑制冗余信息的倾向,HiSA 只是将其显式化。
大型语言模型(LLM)的注意力机制通常计算每个查询与每个键的完整点积。这种全量计算虽然有效,但代价高昂。一篇新论文提出了HiSA(Hidden Sparse Attention),从另一个角度切入稀疏化:不是稀疏化token,而是稀疏化隐藏(特征)维度。
核心思想:部分点积已足够
HiSA的核心观察是:注意力并不需要完整的点积。它保持查询和键的投影不变,但仅计算部分点积。这个部分点积的规则是静态、无参数的,由token位置决定。换句话说,注意力在隐藏维度上变得稀疏,而这一轴线的探索远少于token稀疏性。
基于旋转位置编码(RoPE)的结构,HiSA将键和查询分解为若干部分,这些部分在计算注意力时可以被省略。研究团队从零开始训练LLM,发现这种部分点积不仅没有损害性能,反而相比完整点积有所提升,同时只计算约三分之一的查询-键乘积。

旋转位置编码(RoPE) 是一种将位置信息注入注意力计算的方法:它不额外添加位置向量,而是用一个与位置相关的旋转矩阵对查询和键向量成对维度做旋转,再计算点积。这样注意力分数会随相对位置差自然产生周期性变化,且无需改变模型结构。HiSA 得以“按位置静态决定省略哪些隐藏维度”,正是因为 RoPE 把位置信息编码进了查询/键的每一对维度中:不同位置对应不同的旋转角度,使得某些维度上的部分点积对位置的敏感度更低,可以安全省略。若没有 RoPE 这种结构,隐藏维度的静态稀疏规则就失去可依据的位置信号。
性能与效率的双重收益
在推理阶段,HiSA提升了解码速度并缩小了内存占用。这对于部署大型模型尤其有意义,因为解码速度和内存是实际应用中的关键瓶颈。
研究还展示了密集注意力会学习抑制HiSA丢弃的那些注意力分数部分。这为方法提供了动机:模型本身就有抑制冗余信息的倾向,HiSA只是将这种倾向显式化并在计算上实现。
工程实现:集成FlashAttention-3
为了便于实际使用,团队将HiSA扩展到FlashAttention-3内核,支持训练和推理。这意味着HiSA不仅是一个理论上的稀疏化方案,还具备高效的工程实现基础。代码已在GitHub开源(ambroise-b/hisa)。
FlashAttention-3 是针对 Hopper 架构 GPU(如 H100)优化的注意力内核,核心思路是分块(tiling)与在线 softmax,把注意力计算融合进片上 SRAM 以减少显存读写,并利用异步流水线与 Tensor Core 实现高吞吐。将 HiSA 接入该内核意味着稀疏规则必须与分块调度兼容:省略的隐藏维度需要在分块加载与矩阵乘的粒度上表达,才能不破坏内核的流水线效率。这也是判断一个稀疏注意力方案能否落地的关键——仅有算法层面的稀疏性,若无法映射到高效内核,实际加速往往大打折扣。
与token稀疏化的对比
几乎所有的稀疏注意力方法都聚焦于token维度——跳过某些token之间的交互。HiSA则选择了隐藏维度,这是一个较少被探索的方向。这种正交的稀疏化思路可能为注意力优化开辟新的可能性,尤其是与token稀疏化方法结合时。
启示与展望
HiSA表明,在RoPE注意力中,隐藏维度的部分计算可以保持甚至提升性能,同时显著减少计算量。这挑战了“完整点积是必要的”这一默认假设,并为高效注意力机制的设计提供了新视角。未来,这种静态稀疏规则或许可以与其他动态稀疏方法互补,进一步推动LLM的效率边界。
相关推荐

胰腺癌口服药被誉数十年来最大突破
胰腺癌口服药被评价为数十年来最大突破,引发Hacker News热议。本文从剂型优势、临床验证阶段和技术社区审慎态度三个角度,分析这一突破的真实含金量与距离临床可及的距离。
DevWorkflow 5.0:用AI五步法从想法到上线
DevWorkflow 5.0 是 Claude Code 插件,用五步流程让 AI 辅助开发从想法到上线。每个决定先问你,避免 AI 擅自加表加字段、文档代码不一致、测试未写就合并。支持多平台多语言,个人开发者和小团队适用。
Hermes Agent的.md文件如何工作?核心机制解析
解析 Hermes Agent 的 .hermes 目录机制:user.md 存个人信息、memory.md 记录值得记住的细节、soul.md 定义 Agent 性格。了解这套纯 Markdown 文件如何让 Agent 跨会话保持一致行为。