Homa协议能否终结TCP在AI集群中的统治?

Homa协议以消息为单位、接收方主导拥塞控制,剑指TCP在AI集群中的结构性缺陷。
大规模AI训练中,GPU集群间频繁的梯度聚合与参数同步使网络传输层成为性能瓶颈。TCP因其有序字节流、连接状态管理及发送方主导的拥塞控制等历史包袱,在高带宽、低延迟的数据中心环境中表现不佳,尤以尾部延迟问题对集体通信操作危害最大。斯坦福John Ousterhout团队提出的Homa协议从根本上重新设计传输语义:以消息而非字节流为抽象单位,采用无连接架构,由接收方主动授权发送并为短消息赋予最高优先级,从而系统性地压低尾部延迟。受制于TCP庞大的生态护城河,Homa短期内难以全面替代TCP,但在软硬件栈可协同定制的专用AI集群环境中具备现实落地空间,标志着网络传输层正成为AI基础设施优化的新战场。
为什么AI集群对网络传输提出了新要求
在大规模AI训练和推理场景下,GPU集群之间需要频繁交换海量数据。参数同步、梯度聚合、模型分片之间的通信,往往成为整个训练任务的性能瓶颈。当成百上千张GPU协同工作时,网络延迟和尾部延迟(tail latency)的影响会被放大,哪怕是微小的通信抖动都可能拖慢整体吞吐。
传统的TCP协议诞生于互联网早期,它为广域网环境下的可靠传输做了大量优化,但这些设计目标与现代AI数据中心的需求并不完全吻合。正是在这样的背景下,Homa这类新型传输协议开始受到关注。近期一场以「Homa: The End of TCP for AI Clusters」为题的技术分享,在Hacker News上引发了讨论。
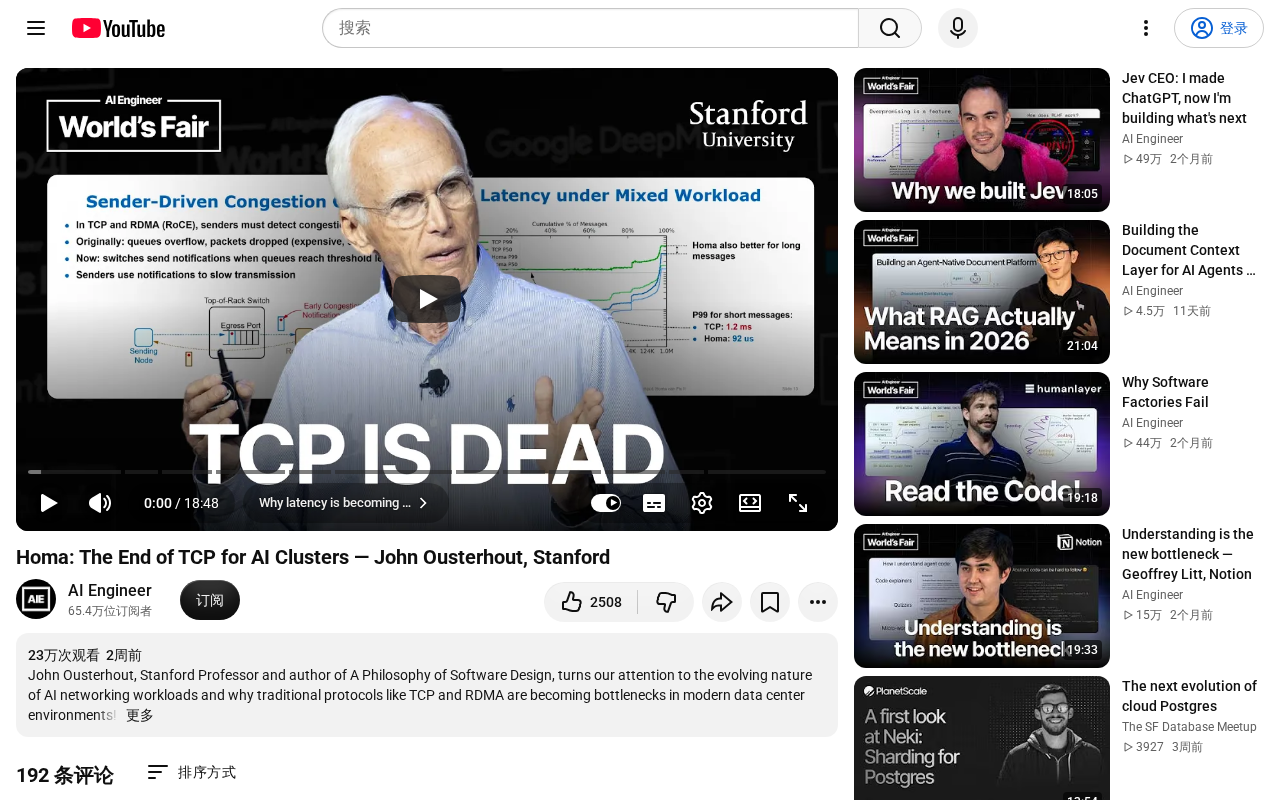
TCP在数据中心面临的结构性问题
TCP最初是为低带宽、高延迟、丢包不可忽视的广域网设计的。它的拥塞控制、慢启动、有序字节流抽象等机制,在数据中心这种高带宽、低延迟、相对可控的环境中反而成了负担。
具体来说,TCP存在几个长期被诟病的痛点:
- 队头阻塞(Head-of-line blocking):TCP的有序字节流语义意味着一个数据包的丢失会阻塞后续所有数据的交付,这对以消息为单位的RPC通信极为不利。
- 连接管理开销:数据中心内部往往存在大量短小的请求-响应消息,为每一对通信端点维护长连接状态代价不菲。
- 尾部延迟不可控:TCP的拥塞控制在面对突发流量时容易产生排队,导致少量请求的延迟急剧升高,而AI集群恰恰对这种长尾延迟高度敏感。
这些问题在AI训练场景下被进一步放大——集群规模越大,通信模式越密集,TCP的边际成本就越高。
**尾部延迟(Tail Latency)**在分布式系统中具有特殊破坏力,值得单独说明。在AI训练中,一次集体通信操作(如AllReduce梯度聚合)需要等待参与该操作的所有节点全部完成才能继续,这意味着整体性能由最慢的那个节点决定。当集群规模扩大到数百乃至数千张GPU时,即使每个节点以99%的概率按时响应,只要有一个节点延迟偏高,整个同步轮次就会被拖慢。这种「木桶效应」使得p99、p999尾部延迟比平均延迟更能反映系统的实际瓶颈。TCP在突发流量下容易触发缓冲区堆积(bufferbloat),导致少量数据包经历远超平均值的排队延迟,这正是其在AI集群场景中被诟病的核心原因之一。
Homa协议的核心思路
Homa是由斯坦福大学John Ousterhout团队提出的一种面向数据中心的传输协议,其设计出发点与TCP有本质不同。
Homa以**消息(message)**而非字节流为基本抽象单位,这更贴合数据中心内RPC通信的实际模式。它采用无连接设计,避免了TCP维护连接状态的开销,使得大量短消息的处理更加高效。
在拥塞控制上,Homa引入了基于接收方的优先级调度和报文级别的负载均衡思路,目标是最小化短消息的延迟,尤其是压低尾部延迟。对于AI集群中大量存在的小粒度同步消息,这种针对性优化可能带来显著收益。
换句话说,Homa不是在TCP上打补丁,而是重新思考「数据中心内部到底需要什么样的传输语义」这一根本问题。
Homa的基于接收方的拥塞控制是其与TCP最具差异化的设计之一。传统TCP的拥塞控制由发送方主导,通过观察丢包或延迟信号来猜测网络状态,响应天然滞后。Homa则将控制权交给接收方:接收方根据自身的处理能力和当前负载,主动向发送方授予发送许可(grant),发送方只能在获得授权后才能传输后续数据。这种机制类似于显式流量控制,能够更精准地避免交换机端口处的排队积压。与此同时,Homa为不同大小的消息分配不同的网络优先级,短消息获得最高优先级,确保小粒度同步请求不被大块数据传输阻塞,从根源上压低了短消息的尾部延迟。这一思路与数据中心网络中DSCP流量分级的工程实践方向一致,但在协议层面实现得更为彻底。
「终结TCP」是口号还是现实
标题中「The End of TCP」的说法无疑带有一定的宣传意味。从工程落地的角度看,TCP在短期内被完全取代的可能性不大。
TCP最大的护城河在于其无处不在的生态:操作系统内核、网卡硬件卸载、负载均衡器、监控工具链,几乎所有基础设施都围绕TCP构建。任何新协议要想替代它,不仅要在性能上胜出,还必须解决部署、兼容和运维的现实障碍。
不过,在AI集群这样一个相对封闭、可控、且对性能极度敏感的专用场景中,情况有所不同。这里的网络通常由单一厂商或团队管理,软硬件栈可以协同定制,这为Homa这类专用协议提供了落地空间。RDMA、RoCE等技术在AI数据中心的普及,也说明业界早已在探索TCP之外的路径。
从这个角度理解,「终结TCP」更准确的含义或许是:在AI集群这个特定领域内,TCP不再是默认的、唯一合理的选择。
**RDMA(Remote Direct Memory Access)和RoCE(RDMA over Converged Ethernet)**是目前AI数据中心中最广泛部署的TCP替代方案,理解它们有助于评估Homa的定位。RDMA允许网卡直接读写远端主机的内存,完全绕过CPU和操作系统内核,将通信延迟压缩到微秒级,并大幅降低CPU开销。RoCE是RDMA在标准以太网上的实现,相比需要专用InfiniBand网络的传统RDMA部署成本更低。英伟达的InfiniBand网络和基于RoCEv2的方案目前已是大型AI训练集群的主流选择。然而RDMA对网络无损(无丢包)环境要求极高,需要配合优先级流控(PFC)等机制,运维复杂度显著高于TCP。Homa的目标之一正是在普通以太网上实现接近RDMA的低延迟性能,同时降低对网络无损特性的依赖,这代表了另一种技术路径的权衡取舍。
对从业者的启示
对于构建大规模AI基础设施的工程师而言,Homa的讨论提供了一个有价值的视角:网络传输层不应被视为理所当然的黑盒,它同样是性能优化的重要战场。
随着模型规模持续扩大、分布式训练成为常态,通信效率将越来越直接地影响训练成本和迭代速度。关注Homa这类协议的演进,有助于更早地识别基础设施层面的优化机会。
需要说明的是,本文基于Hacker News上的一则技术分享讨论整理,该讨论目前热度有限(14个赞、1条评论),视频的具体技术细节和实测数据仍需结合原始分享进一步了解。感兴趣的读者建议观看原视频,并参考Ousterhout团队关于Homa的学术论文获取更严谨的论证。
相关推荐

MCP协议入门:从概念到天气服务实战开发全解析
本文系统讲解MCP(模型上下文协议)的核心概念、三层架构与两种通信机制,并手把手演示用Python和UV开发天气查询MCP Server、在Claude Desktop中配置调用,以及用MCP Client编码方式连接的完整实战流程。

大模型RAG企业实战:从零搭建问答系统架构
大模型RAG企业项目实战课第一周详解:基于FastAPI构建RESTful API,统一调度本地开源模型与在线API,用PyCharm远程连接Linux服务器完成部署,并用Postman验证前后端问答链路,还原企业级大模型系统的真实开发流程。
RAG知识库系统实战:从零搭建企业级私有知识库全流程
手把手教你搭建企业级RAG私有知识库系统,基于Vue 3与Spring AI,涵盖Milvus向量数据库、分块策略、召回率优化、AI幻觉抑制、来源追溯与访问控制等企业级实战难点,附完整Java+AI学习路径。