HP ZGX Fury开放订购:搭载GB300超级芯片与748GB统一内存
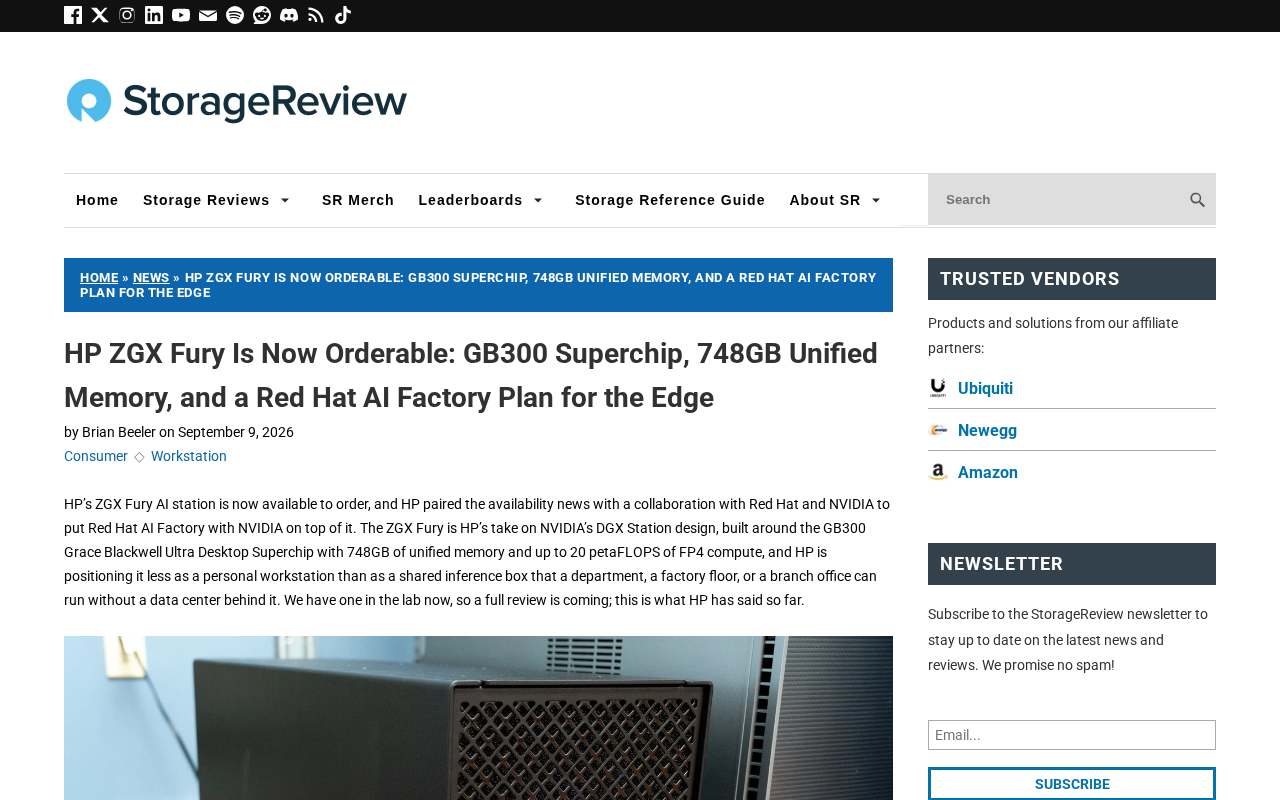
HP推出搭载NVIDIA GB300芯片与748GB统一内存的桌面AI工作站ZGX Fury,瞄准本地大模型开发需求。
HP ZGX Fury是一款面向AI研究者与企业研发团队的桌面超级工作站,核心亮点是搭载NVIDIA Grace Blackwell架构的GB300超级芯片,并提供748GB CPU-GPU统一内存池。统一内存通过高带宽芯片间互联消除了传统架构中主机内存与显存之间的数据拷贝开销,使单台设备在理论上具备加载和微调数百亿参数级大语言模型的能力。产品定位聚焦于需要本地算力、对数据隐私敏感或追求低延迟开发迭代的专业场景。社区讨论的主要疑点集中在定价合理性、实测性能表现以及软件生态的成熟程度,这些因素将最终决定其对目标用户的实际价值。
HP ZGX Fury登场:面向AI开发的桌面级超级工作站
HP旗下的AI工作站产品线迎来重磅新成员——ZGX Fury现已开放订购。这款设备最引人注目的配置在于搭载了NVIDIA GB300超级芯片,并提供高达748GB的统一内存,直接瞄准需要在本地运行大规模AI模型的开发者与研究团队。
对于长期依赖云端GPU实例训练和推理的团队而言,一台能够在桌面端提供如此规格算力与内存的工作站,意味着开发流程可以更靠近本地,减少对远端算力的持续依赖。
GB300超级芯片与统一内存的意义
GB300超级芯片是这款工作站的核心。NVIDIA的Grace Blackwell架构将CPU与GPU通过高带宽互联整合,形成统一的内存寻址空间。这正是748GB“统一内存”这一表述的关键所在——CPU和GPU可以共享同一块巨大的内存池,避免了传统架构中数据在主机内存与显存之间反复拷贝所带来的开销。
为什么748GB内存对大模型很重要
当前主流大语言模型的参数规模动辄数百亿甚至更高,模型权重、KV缓存以及中间激活值都需要占用大量内存。消费级显卡通常只有24GB到80GB的显存,运行超大模型时不得不进行量化或多卡切分。748GB的统一内存容量,使得在单台设备上加载和微调较大规模模型成为可能,显著降低了本地实验的门槛。
以常见的70B参数模型(如Llama 3 70B)为例,以BF16精度存储权重本身就需要约140GB显存,若再考虑推理时的KV缓存(随上下文长度线性增长)和训练时的优化器状态(Adam优化器会额外存储梯度动量,约为权重的2-3倍),完整的训练内存需求轻易超过400GB。目前单张H100 SXM最大只有80GB显存,要运行上述工作负载通常需要8卡以上的多机多卡配置。748GB的统一内存池在理论上允许单机加载并微调参数量达数百亿的模型,同时还能维持足够长的推理上下文窗口,这对RAG(检索增强生成)等需要大上下文的应用尤为关键。
桌面级形态的价值
把数据中心级别的芯片带到桌面工作站形态,本质上是在追求“开发即本地”的体验。研究人员可以在本地完成原型验证、模型微调和推理调试,只有在真正需要大规模扩展时才转向数据中心集群。这种混合工作流对数据隐私敏感的场景尤为友好。
GB300是NVIDIA Grace Blackwell架构的最新迭代,前一代为GB200。Grace指的是NVIDIA自研的ARM架构CPU核心,Blackwell则是当前一代GPU微架构的代号(前代为Hopper)。Grace Blackwell通过NVLink-C2C芯片间互联将CPU与GPU紧密集成在同一封装或同一基板上,实现了远超PCIe带宽的内部数据传输速率(理论峰值可达900GB/s以上)。这种集成方式不仅降低延迟,更是实现统一内存寻址的物理基础——操作系统和编程框架可以将CPU内存与GPU显存视为同一连续地址空间,开发者无需手动管理数据在两侧之间的搬运。
目标用户与应用场景
从产品定位来看,ZGX Fury并非面向普通消费者,而是服务于AI研究者、机器学习工程师以及企业研发团队。典型的应用场景包括:
- 本地微调与实验大规模语言模型,无需长期占用云端资源
- 对数据安全有严格要求、无法将数据上传云端的行业(如医疗、金融)
- 需要低延迟迭代的AI原型开发
- 边缘部署前的模型验证与优化
对这类用户来说,一次性投入的硬件成本,可能在长期上比持续租用高端云GPU更具经济性,尤其是在算力需求稳定且高强度的场景下。
社区反应与讨论焦点
该消息在Hacker News上引发了讨论,评论中的关注点集中在几个方面。一方面,开发者对本地拥有如此大内存容量表示兴趣,认为这能改变本地开发的可行性边界;另一方面,价格与实际可用性成为普遍疑问——这类搭载顶级芯片的工作站往往定价高昂,是否具备足够的性价比仍需实际评测来验证。
此外,NVIDIA Grace Blackwell架构的软件生态成熟度、散热与功耗表现,也是潜在买家在下单前会重点评估的因素。
Grace Blackwell平台目前主要通过CUDA 12.x及对应的cuDNN、NCCL版本提供支持,主流AI框架(PyTorch、JAX)已有针对该架构的优化内核,但部分第三方库和量化工具链仍在跟进适配中。统一内存编程模型(CUDA Unified Memory)虽然简化了代码编写,但在性能调优上需要开发者额外关注内存访问局部性,否则可能因页面迁移开销而无法充分发挥硬件潜力。这也是社区评论中软件生态成熟度被反复提及的原因——硬件规格亮眼,但真实工作负载下的端到端吞吐量仍需系统性基准测试来验证。
小结
HP ZGX Fury代表了AI硬件向本地化、桌面化发展的一个方向。凭借GB300超级芯片和748GB统一内存,它试图在数据中心与个人工作站之间架起一座桥梁。对于真正需要大内存本地算力的专业团队而言,这是一个值得关注的选项,但最终的采购决策仍取决于定价、实测性能以及与现有工作流的契合度。
相关推荐
涵洞失效的隐性风险:被忽视的基础设施安全隐患
涵洞是深埋于道路下方的隐性排水结构,其失效可能导致路基掏空、局部洪水乃至致命事故。本文梳理涵洞的重要性、失效风险及被忽视的基础设施维护困境。
OzBrain:让每个AI智能体共享同一份知识库
OzBrain 是一款面向多AI智能体时代的共享知识库产品,让每个AI智能体与团队成员读写同一个「大脑」。支持数据加密、不用于训练、可导出Markdown随时离开,解决AI工具间的知识孤岛问题。
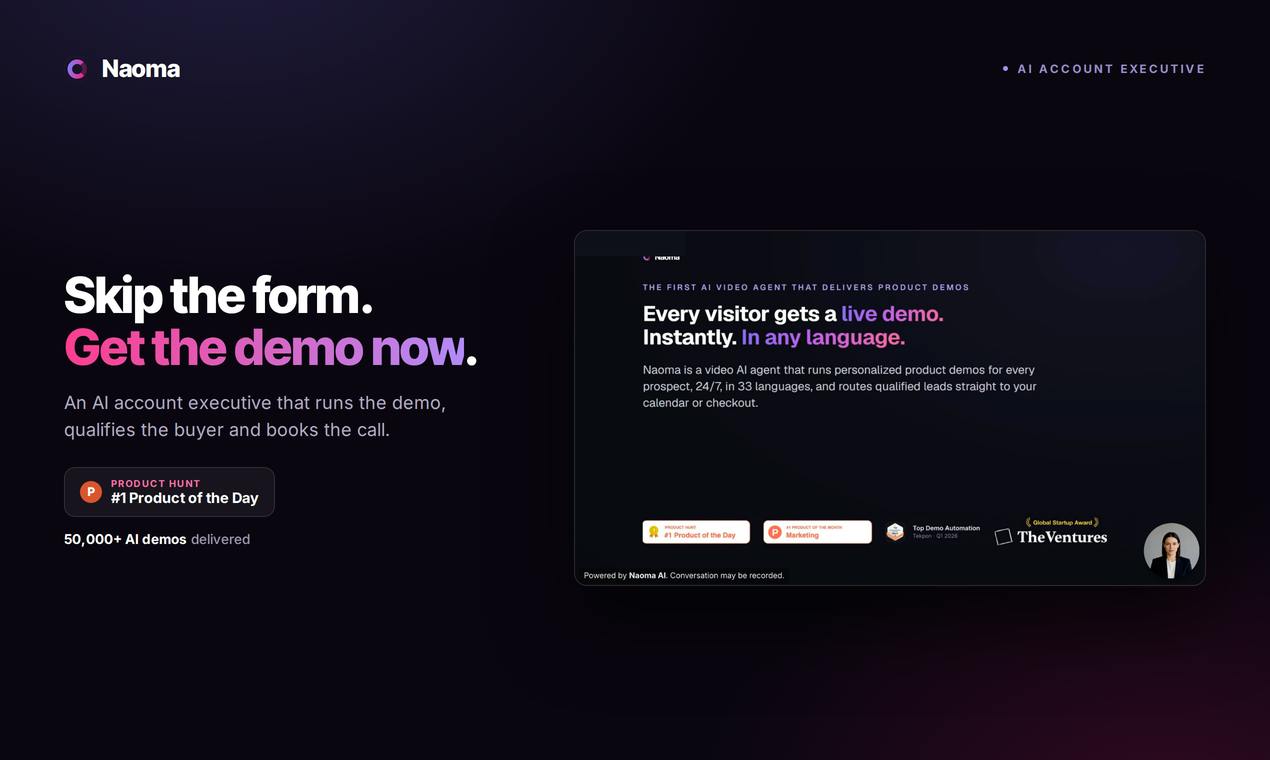
Naoma AI Demo Agent V2:用AI销售把网站流量变成成交会议
Naoma AI Demo Agent V2 用AI销售代表替代传统预约表单,实时为访客演示产品、筛选线索并预约会议,已运行5万+演示并开放自助试用。解析这款登顶Product Hunt的销售自动化工具。