幻尔miniAuto Pro开源小车:融合AI大模型与语音智能体实测
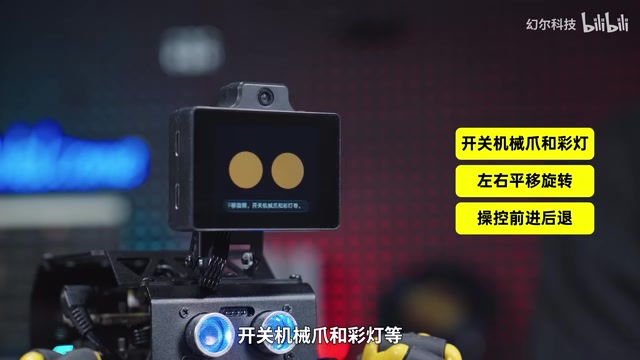
miniAuto Pro将大语言模型、视觉AI与嵌入式硬件打通,实现自然语言驱动的感知、决策、执行全链路机器人控制。
幻尔科技的miniAuto Pro是一款面向嵌入式开发者与AI爱好者的开源机器人平台,核心亮点是将大语言模型(LLM)、视觉大模型(VLM)与传统机械控制整合为完整闭环。用户可通过自然语言下达连续多步指令,系统自动拆解为前进、转向、机械爪动作等序列;结合超声波传感器,还能执行基于实时数据的if-else条件判断(如根据距离切换灯光颜色);视觉模块则支持场景描述与物体识别,并可联动机械爪完成识别—抓取—搬运的完整操作。作为开源平台,miniAuto Pro为希望实践「语音+视觉+控制」全链路的开发者提供了可拓展的实验基础,但实际开发体验仍需在真实环境中进一步验证。
对于嵌入式开发者和AI爱好者而言,一个能把大语言模型、语音交互与机械控制真正打通的开源平台,往往比单纯的教学套件更有吸引力。幻尔科技的miniAuto Pro正是这样一款产品——它把ESP-Claw智能体、AI语音助手「小焕」与机器人本体结合,展示了从自然语言指令到物理动作的完整闭环。
一句话指令,完成多步动作编排
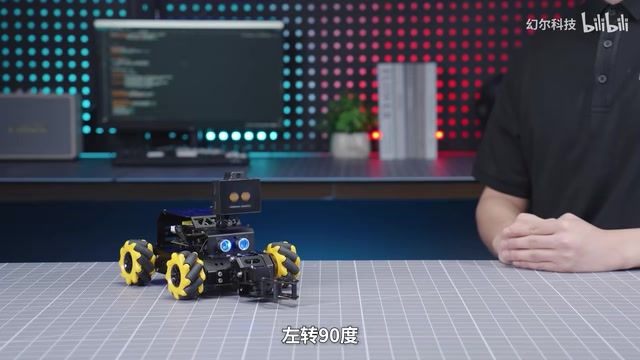
miniAuto Pro最直观的亮点,是它能够解析连续、复杂的自然语言指令,并转化为一系列精确的机械动作。在实测演示中,用户只需说出「先往前走20厘米,再向后退15厘米,接着左转90度、右转100度,然后将机械臂抬起来再放下,最后机械爪开合两次」,小车便能逐条执行完整个动作序列。
这背后体现的是大模型对多步骤任务的拆解能力。传统机器人控制往往需要预先编程或图形化拖拽指令,而这里的交互方式更接近人与人之间的自然对话,指令的距离、角度、动作顺序都能被准确映射到底层电机与舵机控制上。
这种能力的技术基础是大语言模型(LLM)的「函数调用」(Function Calling)机制。开发者预先定义好底层控制函数(如前进、转向、舵机角度等),并以结构化格式告知模型可调用的工具列表;模型接收到自然语言指令后,负责将其拆解为有序的函数调用序列,再由嵌入式控制器(如ESP32系列)依次执行。这种架构将LLM定位为「任务规划层」,而非直接生成底层控制信号,既保留了自然语言交互的灵活性,又保证了硬件执行的确定性与安全性。ESP-Claw智能体即是承担这一「语言理解到硬件指令翻译」角色的核心模块。
感知与条件判断:让机器人「会思考」
比动作执行更进一步的是条件逻辑的处理。演示中给出的指令是:「探测前方障碍物的距离,如果大于30厘米就原地转一圈并把超声波的灯光调成绿色,如果小于30厘米就把灯光调成红色。」小车检测到前方距离为52厘米后,正确判断「大于30厘米」,随即原地旋转并将灯光调为绿色。
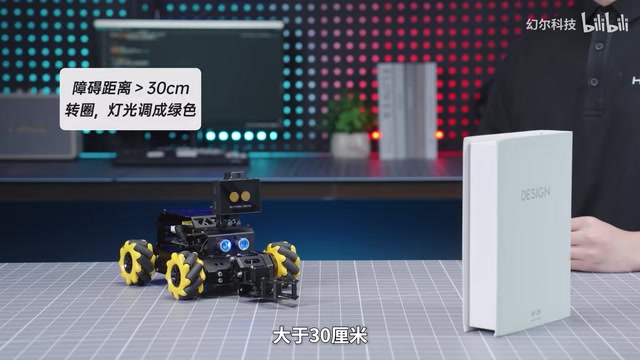
这类 if-else 条件分支的实现,说明系统不只是把语音当作简单的遥控指令,而是能结合超声波传感器的实时数据做出判断。对于学习者来说,这是理解「感知—决策—执行」机器人控制范式的绝佳案例。
「感知—决策—执行」是经典的机器人控制范式,也称为感知-行动循环(Perception-Action Loop)。传统实现中,感知层(传感器数据采集)、决策层(条件逻辑或规划算法)与执行层(电机驱动)通常由工程师手动编写控制逻辑串联。miniAuto Pro的创新之处在于,将决策层的条件判断交给大模型动态生成——模型在运行时读取超声波传感器返回的实时数值,结合指令中的阈值描述,输出对应的执行方案。这意味着开发者无需预先穷举所有判断分支,只需以自然语言描述规则,大模型即可将其转化为可执行逻辑,显著降低了条件控制逻辑的编写成本。
视觉理解与物体操控的结合
miniAuto Pro接入了视觉大模型,具备场景描述与物体识别能力。当被要求「描述看到的场景」时,它能识别出桌面上的熊猫、斑马、小树和埃菲尔铁塔模型,并说明背景是白板和灯光。
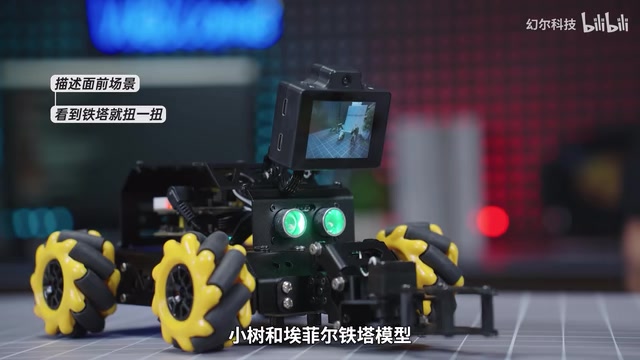
更有趣的是视觉与动作的联动。用户下达「如果有铁塔的话就扭一扭」这样的条件指令后,小车识别到埃菲尔铁塔模型便执行摆动动作;而在「左转60度,如果看到小黄鸭就抓住然后放到右边」的任务中,它完成了识别、抓取、搬运的完整流程。这种「视觉识别 + 机械爪操控」的组合,把大模型的感知能力真正落到了物理世界的操作上。
视觉大模型(Vision-Language Model,VLM)是能够同时处理图像与文本输入的多模态模型,典型代表包括GPT-4o、LLaVA、Qwen-VL等。与传统计算机视觉方案(如YOLO目标检测)相比,VLM的优势在于无需针对特定物体训练专用模型,只需通过自然语言描述即可完成开放词汇的物体识别与场景理解。在miniAuto Pro的应用场景中,摄像头采集的图像帧被送入视觉大模型,模型输出识别结果后再交由LLM结合当前指令决策下一步动作。这一「VLM感知 + LLM决策 + 嵌入式执行」的三层架构,是当前具身智能(Embodied AI)领域的主流技术路线之一。
面向开发者的开源价值
从产品定位看,miniAuto Pro的核心价值在于「开源」二字。它整合了AI语音助手、ESP-Claw智能体、视觉大模型以及机械控制多个模块,为嵌入式与AI爱好者提供了一个可拓展的实验平台。
开发者既可以研究语音指令如何被解析为控制信号,也可以探索视觉模型与硬件动作的协同逻辑,甚至基于现有框架拓展新的智能应用场景。相比封闭的成品玩具,这种开放性让它更适合作为学习机器人与AI融合技术的载体。
小结
miniAuto Pro通过一段实测演示,完整呈现了自然语言控制、条件判断、视觉理解和物体操控四类能力。它把当下热门的大模型能力与传统嵌入式硬件结合,降低了普通爱好者接触AI机器人开发的门槛。对于希望动手实践「语音+视觉+控制」全链路的开发者而言,这样一款开源平台提供了不错的起点。需要说明的是,本文基于官方演示内容整理,实际开发体验与拓展能力仍需在真实环境中验证。
相关推荐
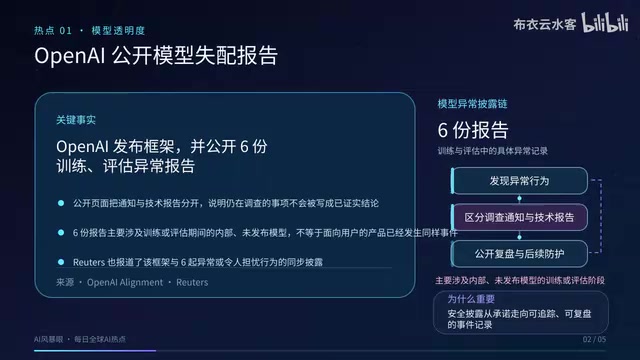
OpenAI披露模型异常、DeepMind建AGI机构、英伟达联手管电力
9月17日AI行业三大动态:OpenAI公开模型异常披露框架并放出六份报告,Google DeepMind成立AGI公共讨论平台,英伟达联合Google等发起AI电力管理联盟。深度解析AI安全、治理与基础设施三大瓶颈。
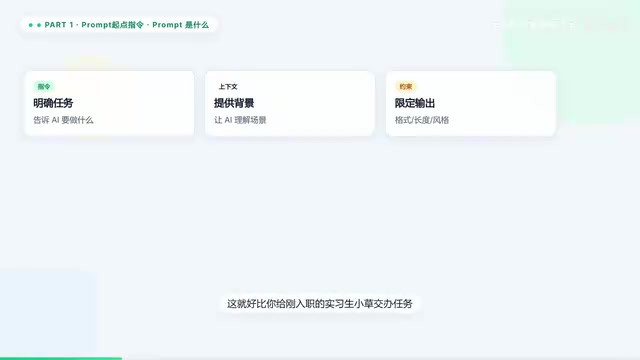
Prompt→MCP→Agent→Skill:5分钟搞懂AI术语进化链
一篇科普梳理Prompt、MCP、Agent、Skill、Cowork五大AI核心概念的递进关系。用职场类比讲透AI如何从简单指令进化到多智能体团队协作,帮你彻底告别AI术语焦虑。
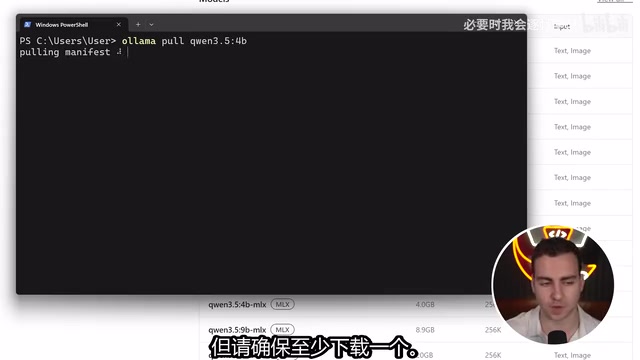
10分钟用Python搭建本地AI代理:Ollama+PydanticAI实战
一篇基于B站教程的实操指南,教你用Python、Ollama和PydanticAI在10分钟内搭建完全本地运行的AI代理。涵盖模型选择、连接推理服务器、挂载工具函数和构建对话循环全流程。